


大部分人与 AI 打交道,几乎都是在屏幕里,用它帮我们写代码、查资料、做表格等任务。
试图解放我们双手,把键盘和鼠标的活都交给它,而且现在也干得挺像样的。
但在屏幕之外的物理世界,AI 才刚入门,也就是今年大家常看到的「世界模型」方向。
就连李飞飞和 LeCun 等 AI 领域的权威大佬,都纷纷开公司投入研究,还拿到了十亿美元融资。
他们都在往物理世界这个方向推,想要把 AI 落地到机器人身上,让它们能主动把一件事做成。
就在 9 月 10 日的上海外滩大会上,事情迎来了重大突破。
生数科技,发布了一个面向机器人灵巧操作的自进化通用世界模型:Motus2。

周末,我把它的论文和项目主页翻了一遍,第一反应是它把行业这半年最热的几件事一次做全了。
大规模人类第一视角数据、世界模型、触觉,再加上让模型自己评估自己再改进,这几件事同行大多是分开做的。
就拿英伟达来说,前三件它今年都碰了,但拆成了四个独立的工作。
DreamZero 是 14B 参数的世界动作模型(WAM),管「怎么动」,DreamDojo 用 4.4 万小时第一视角人类视频训世界模型,管「预测」。
EgoScale 用 2 万多小时第一视角视频预训练策略去控制 22 自由度灵巧手,管迁移,T-Rex 再往上加 100 小时触觉数据,管「摸」。
而 Motus2 直接把这几件放进了同一个模型里,还加上了自己给自己打分的闭环,用的是灵巧手,不是夹爪。
先看官方放出的真机演示,机器人对准灯座把灯泡一圈圈拧到点亮。
双手配合撕下一张厨房纸,翻书,还能记住之前看到的信息,在几个杯子里找出被藏起来的方块。
这些动作用的是单手 22 自由度的 Sharpa Wave 和单手 20 自由度的 WUJI Hand 2,都是带触觉的灵巧手。
对人来说这些都是非常简单的事,但对机器人却并不简单,尤其到了灵巧手阶段。
问题已经不只是能不能抓起来,而是怎么捏、怎么转、什么时候松手、力度合不合适、接触状态有没有变化。
要攻克解决这些难题,一台机器人得过三大关卡,下面跟大家一起把这三关拆解来看看。
第一关,手怎么动
灵巧手最先卡住的是数据,一只手二十多个关节要互相配合,真机数据又贵又少。
夹爪只有一个开合维度,几百条遥操数据就能学会一个任务,高自由度的手做不到。
Motus2 的做法是先不急着教机器人,而是让它先看人怎么做。
用了约 13 万小时的第一人称人类数据(Ego 数据)做预训练,从大量人类第一视角视频里学物体怎么动、手怎么和物体打交道。
这 13 万小时分两层,单目 Ego 视频学世界常识和操作规律,双目视频加动作学手和物体的三维关系。
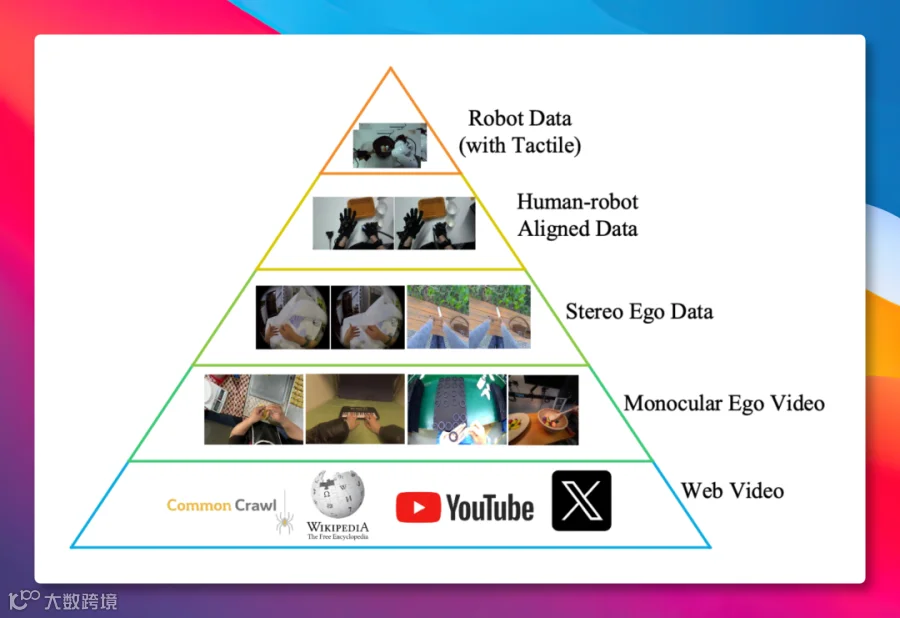
看完人怎么做之后,再学这双手怎么干,这一步叫机器人领域中间训练。
用的是 100 多小时的机器人轨迹和人机对齐数据,把人类经验适配到机器人的观测和控制空间,最后再做目标任务微调。
前两步的差别论文里有一组对照,相同微调流程下,只做人类数据预训练的模型五项真机任务平均成功率 51%。
加上机器人中间训练之后,这个数字到了 84%,提了 33 个百分点。

在我看来这组数字说明两类数据的分工是不一样的。
人类数据给的是规模化的世界知识和操作经验,机器人数据负责把这些经验落到这具身体上,少了哪个都不行。
先看人再教手这条路,前面提到的 EgoScale 今年 2 月也走过,人类视频预训练完再用机器人数据对齐。
Motus2 的差别在量级和分层,13 万小时是它的六倍多,而且把单目和双目分了两层。
第二关,做之前先想一步,做完自己打分
传统的机器人策略模型只回答一个问题,现在看到这个状态,下一步做什么。
Motus2 让同一个模型多回答两个问题,做完会发生什么,这个结果好不好。
对应到架构上是三个接口,世界动作模型 WAM 负责策略(Policy),根据指令、机器人状态和视觉历史生成动作块。
动作条件世界模型 AC-WM 负责模拟(Simulator),给定当前状态和候选动作,预测未来的视觉状态。
价值模型 VM 负责评估(Evaluator),根据动作和它带来的结果,判断任务进展是否更接近目标。
要把这三种能力压进一套参数,不是简单的拼接,最大的坑是动作不能「偷看」执行之后才有的信息。
于是 Motus2 用 Action-first 的信息流来解决,动作只读执行前的观测,未来画面可以读动作,评估可以同时读动作和预测结果。
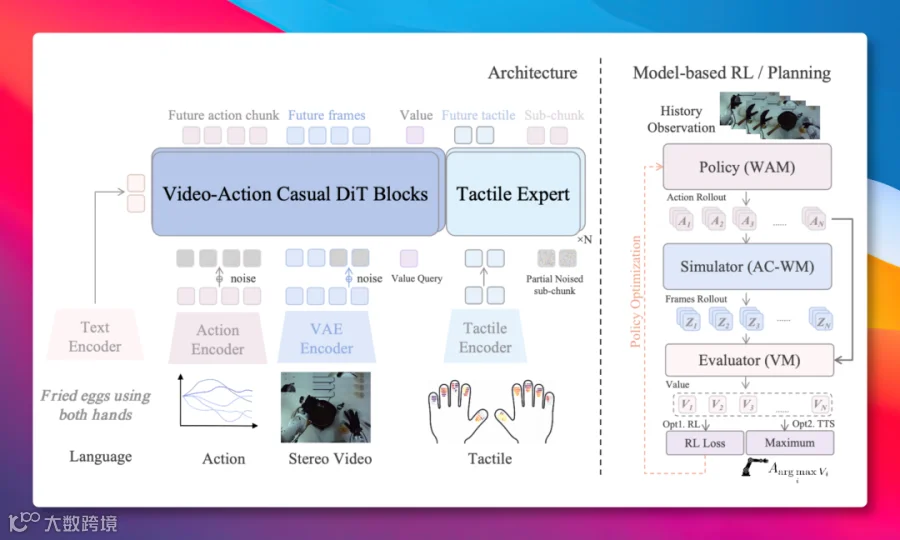
接口和信息流都定了之后,Motus2 在推理和训练两个阶段里各做一件事。
推理时做 Best-of-N 规划,策略先采样 N 个候选动作块,模拟器逐个预测执行后的画面,价值模型给每个打分,挑分数最高的那个执行。
执行完这一段动作,机器人会再读一次真实世界的新观测,重新开下一轮规划,说白了就是每动一下之前,先把几个备选方案在脑子里过一遍。

训练时做基于模型的强化学习(MBRL),候选动作的价值评分被转成策略更新信号,高分方案加强,低分方案减少。
这一阶段只更新动作相关的参数,预测和评估部分保持稳定,反馈只影响策略,不破坏原有的世界模型能力。
也就是说模型自己预测出来的未来,反过来成了训练自己的教材。
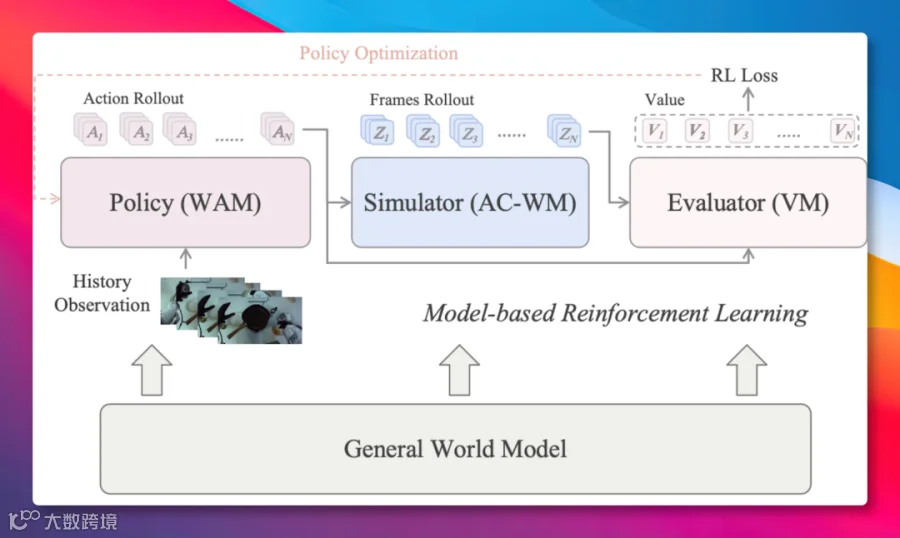
这套「预测、打分、更新」的闭环,也改变了失败数据的用法,因为三种能力吃的数据本来就不一样。
成功轨迹教策略应该怎么做,失败和次优轨迹则喂给模拟器和价值模型,让模型看明白做了什么、发生了什么、为什么没成。
以前采集完要过滤掉的数据,现在有了去处,一条数据不再只有留和删两种命运。
在论文里看到,他们在放置手机和多指操作两项真机任务上,进行了分开测试:

得到的结果是,同时加入 MBRL 与规划的方法,平均成功率比基础策略提升了 10 个百分点。
规划改变的是这一次选哪个动作,而 MBRL 让好动作以后更容易被生成出来,一个管当下一个管长期。
把这套闭环放大了看,它是机器人领域对递归自我改进(RSI,Recursive Self-Improvement)的一次初步探索。
RSI 说的是 AI 系统自己推动自己变强,今年 4 月 ICLR 专门为它开了一个 Workshop,机器人上最近的一个例子是 2 月的 RISE。
RISE 用一个动力学模型预测未来,再用一个进度价值模型给想象出来的结果打分,拿这个信号更新策略,思路和 Motus2 很近。
区别是 Motus2 把预测和打分收进了策略自己那套参数里,省掉了另外两个模型。
Motus2 现在做到的是多任务域内的策略优化,「初步探索」这四个字是准确的。
第三关,看不见的地方靠摸和记
第三关先从夹爪说起,前面说过它只有开合一个动作,手腕上装个相机,捏没捏住、捏多紧,画面里基本能看全。
灵巧手是照着人手设计的,二十多个关节一起动,手指一合拢就把自己挡住了,掌心那一块相机看不到。
同样是抽一张纸巾,夹爪夹住往外拉就行,灵巧手要捏住、感受有没有滑、决定什么时候加力,大半过程看不见。
所以灵巧手干活时,有两类信息不在眼前这一帧画面里,有的发生在过去,有的靠眼睛是看不出来。
先说眼睛看不出来的,比如撕纸、抽纸杯这类持续接触性的动作,视觉判断不了手指有没有打滑、抓得稳不稳、受力有没有变。
为此,Motus2 加入轻量级触觉专家模块,在每一小段动作执行前读取最新的触觉反馈,对这段动作做细化。
在抽取纸杯和撕纸两项任务里,通过加入触觉后平均成功率从 60% 提到 72.5%。
再说发生在过去的,方块被藏在三个杯子中的一个下面,杯子重新摆过之后,只看当前画面已经找不到目标了。
机器人得记得刚才发生了什么,Motus2 默认缓存近期的真实观测,并研究了保留更长历史信息的方式。
在找隐藏方块、按历史提示操作按钮两项任务里,保留完整历史信息的模型平均成功率 57.5%,明显高于压缩历史的方案。
记忆负责补过去,触觉负责补当下,两者一起让机器人拿到光靠当前视觉拿不到的状态信息。
写在最后
回到真机上看总账,论文设置的五项主要真机任务,Motus2 的平均成功率是 84%。
这些实验在采用 Wuji、WUJI Hand 2、Sharpa Wave 灵巧手的三种双臂配置上完成。
这个数字背后,是模型、数据、硬件三层一起升级的结果。
模型层是共享参数的骨干,加三个接口和触觉专家,数据层是 13 万小时人类数据加 100 多小时机器人和人机对齐数据。
硬件层就是上面那三种双臂配置和两款高自由度触觉灵巧手。
这三层缺一层,84% 这个成功率可能都出不来,它是一个系统工程,不是某一个算法点的突破。
两代一起来看,上一代 Motus 解决了让世界模型理解、预测并行动,这一次 Motus2 补上的是评估和反馈。
至此 行动、预测、评估、反馈、再学习,这五步在一个模型里跑通了整个闭环。
放到生数提出的通用世界模型(GWM)五级路线里,它是从 L3「在世界中行动」向 L4「自主世界智能体」迈进的一次初步尝试。
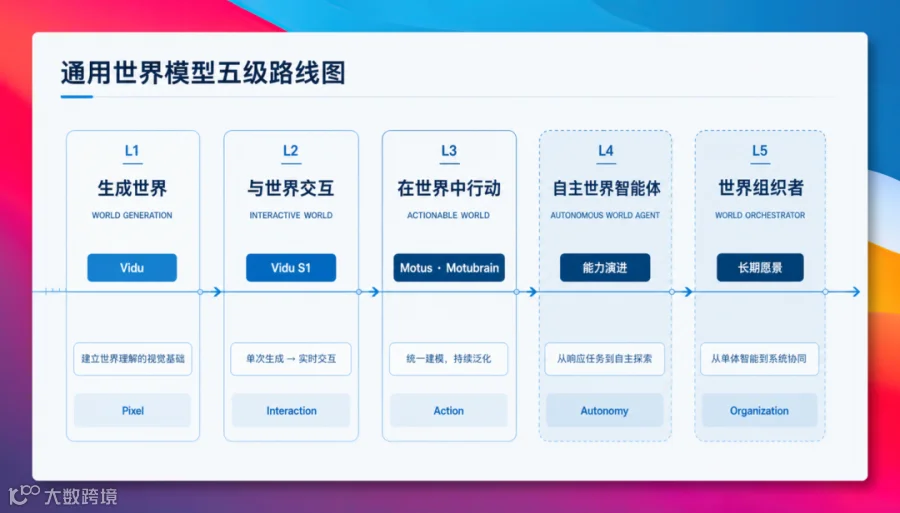
在我看来,这件事对行业的影响,比 84% 这个数字更重要的是机器人数据的用法变了。
机器人开始用自己预测的结果评价自己的行动,失败数据有了价值,采集这笔账要重新算。
另一层是人类第一视角数据被证明能大规模迁移到高自由度灵巧手上,具身智能的数据 Scaling 多了一条走得通的路。
往后看,机器人能否根据自己行动的结果改进下一次行动,这个问题开始从能不能变成能改进多少。
想看全部真机演示的朋友,项目主页上有 29 段视频可以逐个点开看。
项目主页:https://motus-robotics.github.io/motus2/
论文:https://arxiv.org/abs/2608.30237
今天的分享到此结束,感谢大家抽空阅读,我们下期再见,Respect!