


本文题为《Development and benchmark validation of PubChat for PubMed-grounded multilingual biomedical literature retrieval》,由广东省人民医院眼科、广东省眼病防治研究所联合中山大学、香港理工大学、都灵理工大学、香港大学、南方医科大学等多家单位共同完成,发表于《npj Digital Medicine》。该研究针对生物医学文献快速增长背景下传统检索方式耗时较长、筛选负担较重以及大语言模型存在虚构引用和结果难以溯源等问题,开发了以PubMed为数据基础的多语言文献检索框架PubChat。研究将大语言模型嵌入真实文献检索流程,通过研究问题拆解、动态检索式生成、多轮PubMed检索、语义预筛选和三轮大模型核验,对数据库中的真实文献进行相关性判断和分层,而非直接由模型生成参考文献,并通过Cochrane系统综述基准数据、多种语言及多种AI文献检索工具开展系统验证,评估其在文献召回、精确筛选、结果排序和跨语言检索方面的表现。
01 摘要
针对生物医学文献快速增长背景下系统综述检索效率低、文献筛选负担重以及大语言模型存在引用虚构和证据相关性判断不稳定等问题,研究团队开发了基于PubMed溯源的多语言文献检索框架PubChat。该系统采用两阶段设计,首先将研究问题拆解为五级文献相关性标准,随后通过动态检索式生成、PubMed多轮检索、文献去重、Embedding语义预筛选和三轮大语言模型核验,对真实数据库记录进行筛选和分层,而非由大语言模型直接生成文献。研究以2025年20项Cochrane系统综述中的585篇PubMed收录文献为金标准,并与多款通用大语言模型及专业文献检索工具进行比较。结果显示,PubChat-Broad模式取得最高召回率(0.734)和nDCG(0.441),PubChat-Core模式取得最高F1和F2评分;在本次基准测试中,PubChat检出的文献均可通过PubMed核验,未发现虚构引用。研究同时验证了PubChat在8种语言下的检索一致性,并通过279名生物医学研究人员的使用评价进一步考察其实际应用体验。
02 研究背景
1.为什么需要重新设计生物医学文献检索
PubMed每天持续收录大量新的生物医学文献,信息量的快速增长使系统综述的检索、筛选和证据核验越来越耗时。已有的主动学习方法能够按照相关性对文献进行排序,帮助研究人员减少人工筛选量;近年来ChatGPT、Gemini等大语言模型进一步降低了自然语言检索的门槛,但它们并没有解决“检出的文献是否真实、是否真正符合研究问题”的根本问题。论文引用的既往研究显示,部分大模型存在较高的虚构引用率,而且生成的虚假文献往往具有真实的作者、期刊甚至类似DOI的结构,人工快速检查并不容易。
因此,这篇文章真正关注的并不是“如何让大模型找到更多论文”,而是如何让大模型参与文献检索,同时把文献来源控制在可核验的数据库范围内。作者将PubChat定位为一种PubMed-grounded的AI检索框架:文献首先由PubMed检出,大模型再对已经存在的文献进行相关性判断和分层,而不是由大模型自行编造参考文献。
2.这项研究想解决什么问题
文章主要围绕三个问题展开。第一,在同一个PubMed文献池中,通过不同相关性阈值能否形成稳定的召回率—精确率权衡;第二,与通用大模型、专业文献检索工具相比,PubChat能否在保证文献来源可核验的基础上取得较好的检索性能;第三,在不同语言输入下,PubChat能否保持相对稳定的检索结果。
这三个问题分别对应检索准确性、来源可靠性和多语言一致性,也是文章后续实验设计的主线。
03 模型设计
1.整体模型架构
PubChat采用两个阶段的工作流程。
第一阶段是研究问题理解与检索标准生成。用户输入自然语言研究问题后,高推理能力的大语言模型将问题转化为五级相关性评价标准,分值从3到−1。其中3分表示高度相关,2分表示中度相关,1分表示轻度相关,0和−1表示排除。生成后的评价标准会在整个第二阶段检索过程中保持不变,使不同轮次获得的文献使用同一套判断标准。
第二阶段是多轮检索与文献筛选。系统首先根据研究问题生成PubMed兼容的检索式,执行PubMed检索并去除重复PMID,然后进入两级筛选。第一级使用embedding进行语义预筛选,第二级使用大模型进行相关性评价,并通过三轮“评分—重新评分—仲裁”降低单次模型判断带来的误差。最终保留下来的文献按照相关性等级输出,并进一步补充JCR分区、CAS分类、5年影响因子和JIF排名等信息。
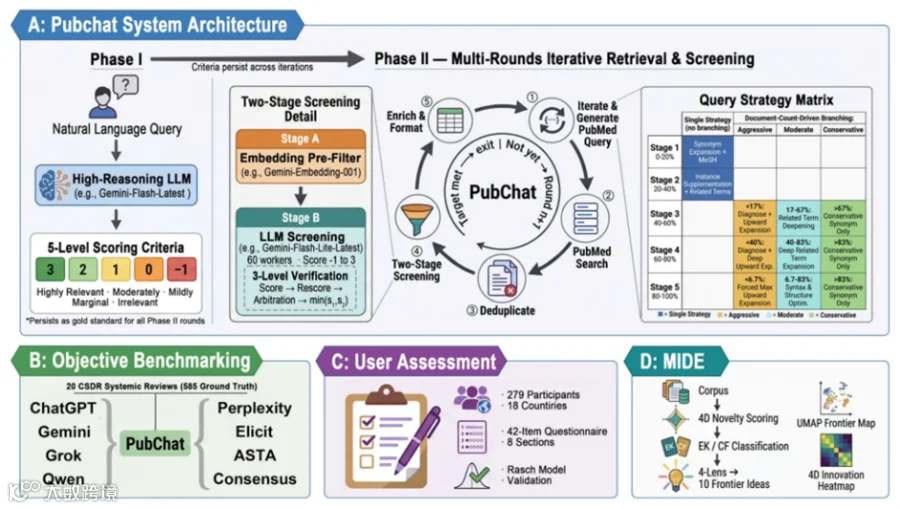
图1 PubChat系统架构与研究设计
2.动态检索如何不断扩大文献覆盖范围
PubChat并不是使用一个固定检索式搜索到底,而是设计了五阶段动态检索策略。前20%的检索轮次主要进行同义词和MeSH词扩展;20%~40%加入抽象概念对应的具体实例;40%~60%对当前检索结果进行诊断并调整;60%~80%根据当前检索数量决定继续扩大还是适当收窄;最后20%进行终末优化和漏检文献补救。
每一轮都会根据当前文献数量选择Aggressive、Moderate或Conservative三种扩展强度。如果检索式超过1500个字符,还会触发简化。系统通过累计检索量与目标数量之间的关系决定下一轮策略,而不是简单重复原来的检索式。验证实验设置为最多50轮、目标300篇文献。
3.两级筛选与三轮核验
在PubMed获得候选文献后,PubChat首先使用Gemini-embedding-001进行语义预筛选,余弦相似度阈值设置为≥0.60,以排除与研究问题明显不相关的记录。通过预筛选的文献进入第二级,由60个并行的大模型工作单元进行相关性判断。
这里最值得注意的是三轮核验机制。第一轮完成相关性评分和结构化信息提取;第二轮隐藏第一轮结果后重新评分,尽量避免前一次判断影响后一次判断;第三轮针对评分不一致的情况进行仲裁。如果仍存在差异,则采用较保守的较低评分。最终只有评分≥1的文献进入结果集。
这种设计实际上把系统综述中的“双人独立筛选”思路转化成了模型内部的多轮复核流程。它不能等同于真正的人类双人筛选,但能够减少一次模型判断造成的偶然错误。
4.三种检索模式
PubChat最终提供Broad、Standard和Core三种结果模式。Broad保留1~3分文献,重点提高召回率;Standard保留2~3分,在召回率和精确率之间取得平衡;Core只保留3分文献,重点提高精确率。
因此,这三个模式并不是三个独立模型,而是同一个检索系统在不同相关性阈值下的三个工作点。
04 实验设置
1.Cochrane金标准数据集
研究选择2025年Cochrane Database of Systematic Reviews中的20项系统综述,从每项综述的“References to studies included in this review”中提取文献,并保留能够通过PubMed PMID核验的记录,共得到585篇PubMed收录文献作为金标准。仅被Embase、CENTRAL等其他数据库收录的文献没有纳入金标准。
这一设计的优点是能够直接通过PMID进行匹配,明确判断某篇文献是否被检出。但它也带来了明显的数据库偏倚:由于金标准本身只保留PubMed可验证记录,PubChat以PubMed为核心数据库的优势可能因此被放大。
2.对照工具与评价指标
研究共比较11种工具配置,包括PubChat的3种模式,以及GPT-5.2-Thinking、Gemini 3.0 Pro、Grok-4.1-Thinking、Qwen3-Max、Perplexity-Sonar、Elicit、ASTA和Consensus。
评价指标包括Precision、Recall、F1、F2、nDCG以及来源可靠性。其中F2比F1更加重视召回率,适合系统综述这种“漏掉关键文献代价较高”的场景;nDCG则进一步评价相关文献是否能够排在结果列表的前面。
3.多语言和用户评价
研究将20项系统综述的问题分别转换为8种语言进行检索,包括中文、英文、法文、德文、意大利文、俄文、葡萄牙文和西班牙文,并通过PMID集合的Overlap Coefficient评价不同语言之间的一致性。
此外,研究还招募了279名来自18个国家和地区的生物医学研究人员进行用户评价。原始收集300份问卷,排除21份完成时间异常或存在明显机械作答模式的问卷后,最终纳入279份。问卷从可靠性、创新性、效率、用户体验和偏好五个维度进行评价,其中28个Likert条目进一步进行了Rasch分析。
05 结果与分析
1.三种模式形成了清晰的召回率—精确率梯度
在20项Cochrane综述中,PubChat-Broad取得最高召回率,为0.734±0.226;PubChat-Core的精确率最高,为0.252±0.149。从综合指标看,Core取得最高F1和F2,分别为0.30±0.15和0.37±0.17。
这一结果与系统设计预期一致:Broad检出更多文献,因此更适合尽可能扩大覆盖范围;Core虽然检出的文献数量明显减少,但保留下来的文献相关性更高;Standard则处于两者之间。

图2 PubChat不同相关性模式、多语言检索一致性及检索轮次收敛特征
2.PubChat的优势主要体现在召回和排名,而不是单纯追求精确率
与其他工具比较时,GPT-5.2-Thinking取得最高精确率0.444±0.230,但召回率只有0.153±0.126。PubChat-Broad的召回率则达到0.734±0.226,Core在召回率>0.4的工具中取得较高精确率。也就是说,GPT类工具更倾向于给出少量相对准确的结果,而PubChat更强调系统综述需要的文献覆盖。

图3 PubChat与不同AI文献检索工具的检索量、召回率、精确率及综合性能比较
3.文献来源可靠性是PubChat最明确的设计优势
本研究中,PubChat检出的文献均可以通过PubMed进行验证,没有出现虚构引用。需要注意的是,这并不意味着大模型本身已经完全解决了幻觉问题,而是因为PubChat在架构上没有让大模型承担“生成参考文献”的任务。文献先由PubMed数据库检出,大模型只负责评价这些已经存在的文献。作者明确指出,PubChat的零虚构引用主要来自这种架构约束,而不是因为PubChat所使用的大模型本身优于其他模型。
4.排名能力同样比较突出
在nDCG评价中,PubChat-Broad和Standard分别取得0.441±0.171和0.431±0.161,高于Core的0.327±0.155和Elicit的0.320±0.168。nDCG反映的不只是“有没有找到”,还反映相关文献是否能够出现在结果列表前部。
对于系统综述而言,这一点具有实际意义。如果相关文献能够更早出现,研究人员可以优先完成高价值文献的人工筛选。需要注意的是,作者并没有把这一结果直接解释为已经证实能够减少实际筛选时间,而是认为还需要进一步开展真实工作量研究。

图4 PubChat的文献排序质量及期刊来源质量分析
5.多语言检索基本保持稳定,但仍存在语言差异
8种语言测试显示,召回率在不同语言之间没有显著差异,Friedman检验P=0.322;精确率存在一定语言相关差异,P=0.011。Core模式的跨语言PMID重叠系数最高,为0.795±0.132。
这说明PubChat在当前测试范围内具有较好的多语言稳定性,但不能据此认为不同语言的检索能力完全一致。尤其需要注意,研究中的非英语问题并不是由不同语言背景的研究人员独立提出,而是将同一个Cochrane目标通过翻译得到其他语言版本,这与真实科研环境中的原生多语言问题仍有区别。
6.压力测试暴露了PubChat的主要漏检来源
PubChat并没有做到完全召回。针对4680个“病例—语言”金标准记录进行分析后,Broad模式漏掉1483条,占31.7%。其中52.5%的漏检记录根本没有进入保存的候选检索池,7.7%在embedding预筛选阶段被排除,39.8%则是在后续大模型筛选阶段被判为不相关。
进一步分析发现,检索池阶段的漏检主要与干预措施、仪器术语以及研究目的或设计表达不足有关;进入大模型筛选后被排除的记录,则更多与次要结局、特定人群或研究场景、干预或检测信号不匹配有关。
所以,PubChat目前最大的技术边界其实非常明确:数据库检索覆盖不足、embedding预筛选误排以及大模型相关性误判都会造成漏检。因此在要求穷尽检索的系统综述中,它仍然不能替代人工设计的补充检索。
7.用户对PubChat的接受度较高
279名研究人员来自18个国家和地区,其中64%每周都会进行文献检索,56%认为自己非常熟悉PubMed,26%曾作为系统综述第一作者。五个评价维度的得分均超过80/100。主观比较中,78%的参与者认为PubChat优于专业检索工具,89%认为优于通用大语言模型,72%认为优于人工检索。
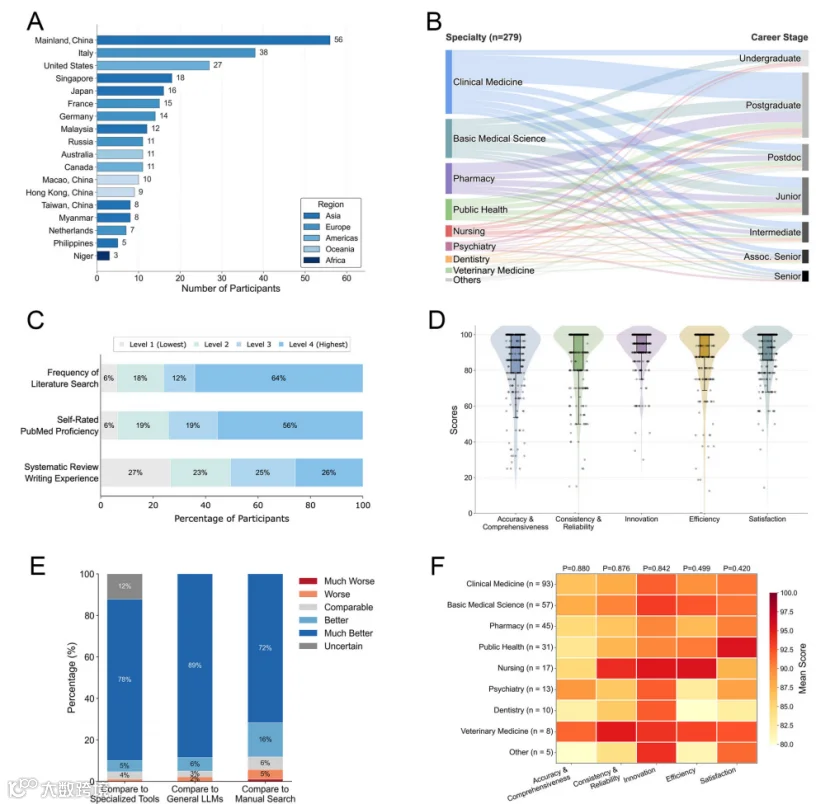
图5 PubChat用户构成及使用体验评价
8.MIDE展示了从“找文献”进一步走向“组织证据”的可能性
研究最后使用PubChat产生的文献库开展了一个牙周炎—慢性肾病的探索性案例。PubChat获得490篇PubMed文献后,MIDE进一步将文献划分为Established Knowledge和Current Frontier,并利用语义新颖性评分、UMAP、Sankey图以及概念、机制、方法和临床四个维度对潜在研究方向进行整理。
这个部分的意义更多在于展示工作流,而不是验证一个新的医学机制。作者也明确说明,MIDE输出的是研究假设优先级和研究空白候选项,需要专家进一步验证,不能直接作为新的科学发现。
06 结论
这篇文章最核心的贡献不是开发了一个“会搜索文献的聊天机器人”,而是重新设计了大语言模型参与文献检索的方式。PubChat把数据库检索和大模型判断拆开:PubMed负责提供真实文献,大模型负责理解问题、生成检索策略、判断相关性和进行分层。
实验结果显示,Broad模式在召回率和nDCG方面表现突出,Core模式则在精确率和F1/F2方面更有优势,三个模式形成了较清晰的检索范围与精度之间的调节关系。同时,8种语言测试显示整体检索结果具有较好的跨语言一致性,279名研究人员的评价也说明该系统具有较好的使用接受度。
但PubChat仍然属于辅助检索和初筛工具。它无法覆盖PubMed之外的Embase、CENTRAL、灰色文献、预印本、临床试验注册库和会议论文等来源,也存在检索式覆盖不足、语义预筛选误排以及大模型相关性误判等问题。因此,对于正式系统综述,它更适合作为人工检索之外的补充工具,而不是替代规范的数据库检索和人工筛选流程。
07 论文评价
✅方法创新亮点
1.最重要的创新是“限制LLM生成文献”。文章没有把大模型当成一个直接提供参考文献的搜索引擎,而是把文献来源锁定在PubMed,再让模型完成相关性判断。这个思路比单纯提高模型生成能力更直接,也更容易解释为什么本研究没有出现虚构引用。
2.把系统综述中的人工筛选逻辑转化成了多轮模型筛选。五级相关性标准、embedding预筛选以及“评分—盲重评分—仲裁”三轮机制,让文献筛选从一次性判断变成了一个相对完整的评价流程。
3.三种模式解决了“找全还是找准”的实际矛盾。Broad、Standard和Core不是三个不同模型,而是同一个检索池上的三个阈值,因此使用者可以根据系统综述初筛、主题探索或重点阅读等不同需求选择结果范围。
⚠方法不足
08 参考资料
Article:
https://doi.org/10.1038/s41746-026-03186-0

编辑:杨梦洁
审核:吴朝
