

导读Q、K、V、缩放、Mask、Softmax,几乎每篇 Transformer 介绍都会出现这些词;真正卡人的却常是它们的顺序。本文只做一件事:从一段 token 的隐藏状态出发,走完一次 decoder-only 自注意力计算,说明 Q/K/V 如何产生、分数为何要缩放、因果 Mask 为什么必须在 softmax 前加入,以及这条限制究竟改变了什么。
先别背 Q、K、V:它们不是三份文本
很多解释把 Q(Query)说成“我要找什么”,K(Key)说成“我有什么标签”,V(Value)说成“我真正交出去的信息”。这套比喻有用,但很容易把人带偏:在 decoder-only 的自注意力里,Q、K、V 通常都来自同一批 token 的当前隐藏状态,不是三段不同文本,也不是词典里预先写好的三种属性。
先把 X 放回整条数据流里看。X 表示当前这一层 attention 收到的隐藏状态,不是天然就等于“已经理解完上下文的语义向量”。第一层的 X₀ 首先来自 token ID 查出的 token embedding(初始词元向量)。模型还必须让位置信息在第一次 attention 中生效,具体是直接加到输入,还是在后续注意力计算中注入,取决于位置方案;这一部分留到第 10 篇展开。
第一层的 X₀ 尚未经过 Transformer block 的上下文混合。经过 attention、MLP 和残差连接后,得到下一层的 X₁;再往后的 Xₗ 已经带有前面层汇入的上下文信息,可以称作上下文语义向量(contextual representation)。同一个 token 出现在不同上下文中,后续层的 Xₗ 因而可以不同。
d_model(模型维度 / 隐藏维度)是这条主干向量的宽度。若暂时忽略 batch,序列有 T 个 token,那么 X₀、X₁ 到 Xₗ 的形状通常都是 T × d_model。模型架构先选定 d_model,token embedding 表也按同一宽度建立;不是词向量先决定模型能有多宽。为了让残差连接能逐层相加,attention 和 MLP 的输出通常都会投影回这个 d_model 宽度。
模型再用三组可学习参数做三次线性投影:
Q = XW_Q,K = XW_K,V = XW_V
在单个 attention head 中,W_Q、W_K 的形状可写为 d_model × d_k,W_V 为 d_model × d_v。因此每个 token 会得到三个临时的工作向量:Q、K 各有 d_k 维,V 有 d_v 维。Q 用来向所有可见位置发问,K 用来参与匹配,V 则是匹配成功后会被汇入结果的信息;不要把某个维度硬翻译成“主语”“语法”或“情感”。
同一层、同一个 head 内的所有 token 使用同一组 W_Q、W_K、W_V。也就是说,q_i = x_iW_Q 与 q_j = x_jW_Q 里的 W_Q 相同,变化的是 token 当前的输入 x_i、x_j,所以输出的 Q 仍然不同。反过来,W_Q、W_K、W_V 是三套不同参数;不同 head 和不同 Transformer 层通常也各有不同参数。实现中常把多个 head 的投影拼成一个大矩阵一次计算,这只是加速方式,不代表所有 head 共用同一份权重。
多头注意力会把这个投影并行做 h 次。常见配置令每头宽度 d_head = d_model / h,每头的 Q、K、V 因而比主干向量窄;各头计算结束后再拼回 d_model。MLP 内部也常会暂时扩宽、再压回 d_model。所以稳定的是 Transformer 主干中 X 的宽度,不是每一个中间张量的宽度。
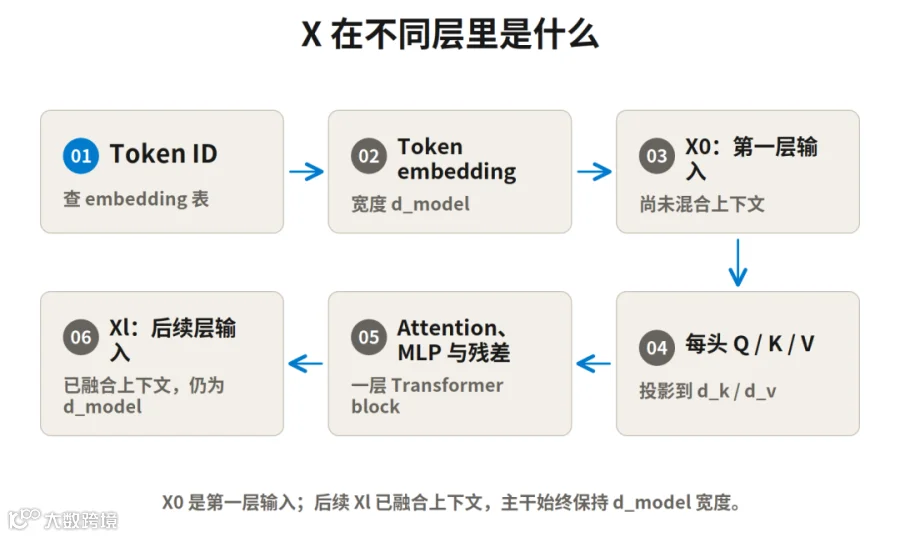
例如处理“放到”时,它的 Q 会与所有可见 token 的 K 比分,权重决定哪些 V 更多地汇入新的表示。
真正的流水线:先打分,再决定带走什么
把一组 query 和 key 相乘:QKᵀ。结果不是一个词向量,而是一张“位置对位置”的分数表。第 i 行、第 j 列的数,表示第 i 个位置的 query 与第 j 个位置的 key 在当前这一头里有多匹配。
随后,分数会除以 √dₖ,其中 dₖ 是每个 key 的维度。原始 Transformer 论文给出的原因是:维度变大时,点积的幅度也倾向变大,softmax 更容易进入梯度很小的饱和区域;缩放是为了把这个风险压下来。它不是“让分数更准确”的魔法步骤,而是为后续归一化保留更可训练的数值范围。
然后才轮到 softmax。它会把每一行分数变成和为 1 的权重:当前位置不再只是知道“谁更匹配”,而是得到一组该从各位置取多少信息的比例。最后用这组权重乘上 V,得到该位置在这个 head 的新输出。注意,模型匹配的是 K,却真正加权汇总的是 V;把 K 和 V 混成同一个东西,是读公式时最常见的断点。
这个新输出不会直接替代旧的 X。一个 Transformer block 有 attention 和 MLP 两个子层,因此通常有两次残差连接。在现在 decoder-only 常见的 Pre-Norm 写法中,数据流可简写为:H = X + Attention(LayerNorm₁(X)),再是 X_next = H + MLP(LayerNorm₂(H))。若把 attention 更新记作 A、MLP 更新记作 M,最终可写成 X_next = X + A + M;但顺序不能省略:M 是以已经得到的 H = X + A 为输入算出的,不是与 X、A 无关的第三个固定向量。也就是说,attention 前归一化一次、attention 更新后做第一次残差相加;MLP 前再归一化一次、MLP 更新后做第二次残差相加。
可以把 attention 看作“从上下文取回信息”的更新,而不是把 token 原有表示清空重写。原始 Transformer 使用的是另一种 Post-Norm 排列,LayerNorm 位于各次残差相加之后;但无论归一化放前还是放后,attention 和 MLP 各自都有一条残差更新这条主线不变。
这里要分清名字:Q/K/V → 打分 → 缩放 → Mask → softmax → 加权汇总 V 这一段叫 causal self-attention(因果自注意力)。一整层 Transformer block 则是 attention 更新、残差连接、MLP 更新和另一条残差连接的组合;MLP 不属于 attention,它负责对每个 token 已经拿到的信息做独立的非线性加工。
第二层做的不是回到原始 token embedding 重算,而是把第一层处理后的整组隐藏状态 X₁ 当作新输入,再跑同样的 block 流程,得到 X₂;第 3 层接收 X₂,依此类推。结构会重复,但参数不会:每一层都有自己的一套 LayerNorm、Q/K/V 投影、输出投影和 MLP 参数。因此,公式里的 X 应理解为“当前层拿到的 Xₗ”,它会随层数不断更新,而不是永远指最初的词元向量。
如果模型共有 L 层,最后一个 block 的输出记作 X_L。它仍是一组带上下文的 d_model 维向量,不是下一个 token ID,也还不是词表概率;本篇到这里为止。X_L 怎样经输出头变成 logits、再选出下一个 token,会在第 11 篇接着解释。
MLP 也常叫 FFN(前馈网络,feed-forward network)。典型结构是把每个 token 的向量从 d_model 扩到更宽的中间维度 d_ff,经过激活函数,再投影回 d_model:d_model → d_ff → 激活函数 → d_model。attention 负责让 token 之间交换信息,MLP 则在每个 token 自己的向量上组合、变换这些已经取回的信息。
扩宽并不自动意味着“信息更多”或“问题一定更简单”。更大的中间空间给模型更多组合特征的容量:一些原本难以区分的模式可能因此获得更容易利用的表示;但是否学到有用特征,仍取决于训练数据、目标与优化。宽度过大也会增加参数、显存和计算,并可能带来过拟合。它不是 SVM 核技巧的替代品,而是模型端到端学习到的非线性特征变换。
原始 Transformer 论文的 Figure 2 把这条顺序画得很直接:左边从 Q、K 的矩阵乘法出发,依次经过缩放、可选 mask、softmax,最后才与 V 相乘;右边则是多头并行后拼接、再投影。
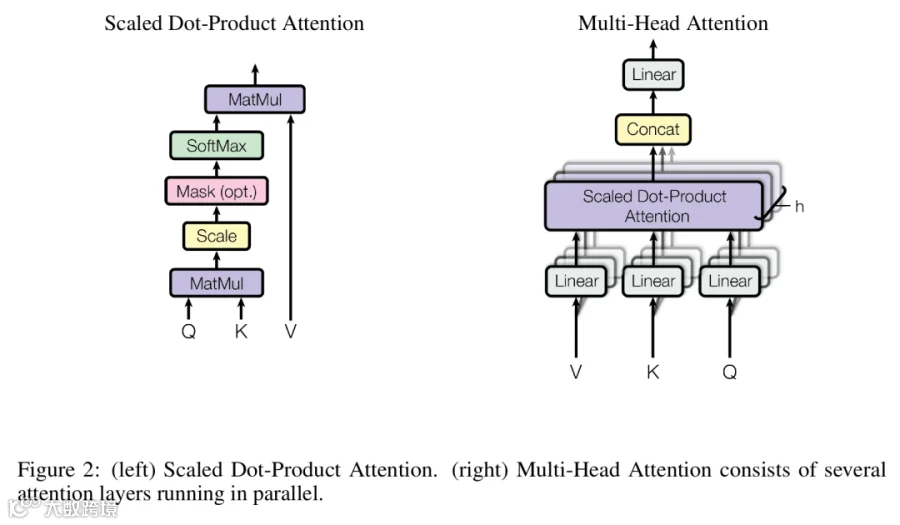 图片来源:Attention Is All You Need Figure 2
Mask 不在结果上打补丁,它改的是 softmax 看见的候选集
如果不加约束,位置 i 的 query 会和整段序列中所有 key 比分,其中也包括 i 右边、也就是训练时已经摆在显存里的正确答案。这样训练损失会很好看,生成时却无法复现:真实生成时,未来 token 根本还不存在。
因果 Mask 处理的是分数矩阵,而不是最后输出。把它写进完整公式,常见形式是:
Attention(Q, K, V) = softmax(QKᵀ / √dₖ + M) V
这里 M 在允许的位置取 0,在未来位置取一个足够小的负数,概念上通常写作 −∞。所以第 i 行只能保留第 0 到 i 列;右上三角的未来位置在进入 softmax 前就被排除。exp(−∞) 为 0,它们自然拿不到任何注意力权重。
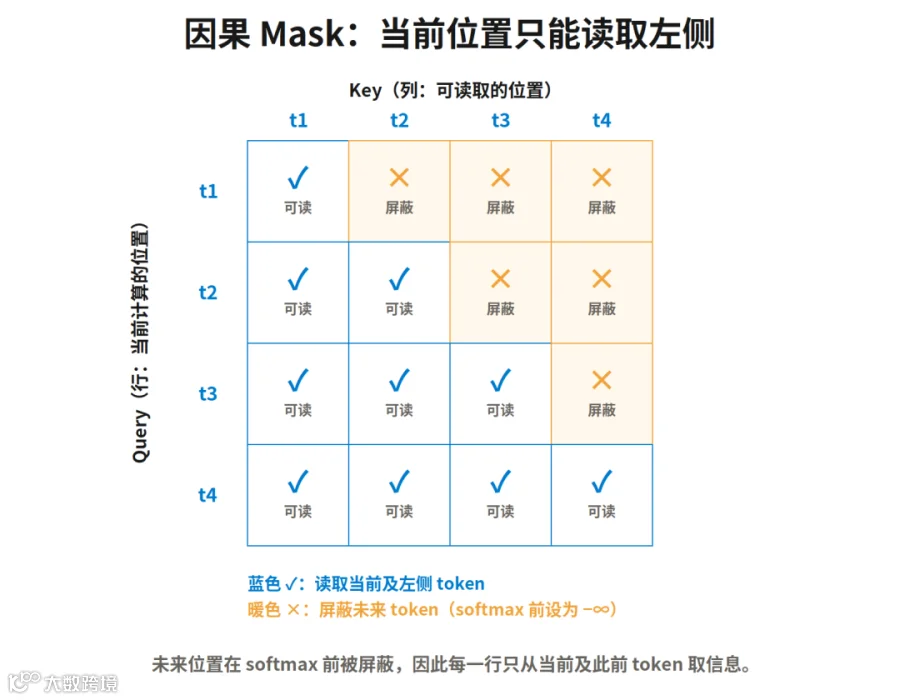
因此 mask 必须在 softmax 之前。如果你先做 softmax,再把未来位置的权重硬置零,剩下权重的和通常已经不是 1;还得重新归一化,才等价于“从一开始就不让它参与候选”。常见实现直接对 score 做 masked_fill(..., -inf),然后再 softmax;PyTorch 的 scaled_dot_product_attention(..., is_causal=True) 则把同一件事封装进算子。
这也解释了一个容易误会的点:因果 Mask 并不让模型“只看上一个 token”。第 i 个位置仍可看见所有过去位置,包括 prompt 的完整已知部分;它禁止的只是右侧未来。正因为能同时读取整段已知前缀,训练阶段可以把所有位置并行算完;而输出未来 token 时,新的条件必须等上一个 token 产生。
多头不是多写几遍公式,而是多套投影并行提问
多头注意力做的事并不神秘:同一份 X 经过多组不同的 W_Q、W_K、W_V,每一组各自跑一次上面的注意力,再把各头输出拼接并通过一个输出投影。每个头都有自己的分数矩阵,也都要遵守同一张因果 Mask。
它的价值在于,模型不必只用一套匹配坐标系决定“什么相关”。不过也别把它讲成“某个头负责语法、另一个头负责事实”的固定分工。论文说明的是多组学习到的投影可以并行关注不同表示子空间和位置;单个 head 在某个模型、某层、某个样本上到底学到什么,需要额外分析,不能从架构名称直接推出。
对写代码的人来说,最有用的定位顺序是:先找到一次线性层把 X 变成 Q、K、V 的地方;再找 Q @ K.transpose(...) 或框架等价算子;确认缩放和因果约束发生在 softmax 前;最后看权重如何与 V 相乘、各头怎样拼回模型维度。能沿这条链读通,注意力层就不再是一串 API。
用四个问题检查你有没有真的读懂
下次看最小 GPT 或 Transformer 实现,可以不用急着追所有张量形状,先问四件事。
1.
Q、K、V 从哪里来?如果它们都由同一 X 投影而来,这是 self-attention;如果 Q 与 K/V 来自不同序列,才是 cross-attention。
2. 分数矩阵的两个位置维分别是谁?行通常对应正在更新的 query 位置,列对应可被读取的 key 位置。把它们看反,Mask 的上下三角也会随之看反。
3.
Mask 加在哪里?对 causal attention,应在 score 进入 softmax 前排除未来位置;若代码用的是 is_causal=True,就去框架文档确认该算子的掩码语义。
4. softmax 之后乘的是谁?是 V,不是 K。权重表达“从哪里取”,V 承载“取什么”。
这四问能把“我知道有 Q、K、V”推进到“我能读懂一个 block,以及它如何在多层中反复把 X₀ 更新成 X_L”。而第 3 篇 decoder-only 已经讲过,Mask 让训练不偷看未来;本篇补上了它在计算图里的具体位置。下一篇先回答 token 顺序如何进入 attention;再到后续的 Prefill 与 Decode 篇,沿同一条 Q/K/V 数据流解释:X_L 为什么能给出下一个 token、为什么已知 prompt 能并行计算、为什么生成仍要逐 token 继续,以及哪些结果值得缓存。
参考资料
Attention Is All You Need: https://papers.neurips.cc/paper/2017/file/3f5ee243547dee91fbd053c1c4a845aa-Paper.pdf
PyTorch scaled_dot_product_attention 文档: https://docs.pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention
nanoGPT model.py: https://github.com/karpathy/nanoGPT/blob/master/model.py
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!