


导读Coding Agent 让“把代码写出来”越来越快,但它没有替工程团队回答:什么任务值得做、做到什么算成功、权限与架构怎样约束、失败后又该改哪里。吴恩达发布的一张 AI Engineering Skills Map 把能力分为四项。本文不把它当成课程清单,而是放回一条真实的交付链路,解释 Coding Agent 究竟放大了什么,又替代不了什么。
 图片说明:吴恩达人物画面,用于人物识别,不代表本文讨论的 AI Engineering Skills Map。图片来源:网络图片
会用 Coding Agent,为什么仍然做不好 AI 项目?
现在很容易看到一种错觉:既然 Agent 能读仓库、改代码、跑测试,工程师的核心竞争力就变成“给它一句足够好的提示词”。
可一旦任务从做出一个能演示的页面,变成把一个 AI 功能交给真实用户,问题会立刻变样:它该处理哪些请求,拒绝哪些请求?答案错了怎样被发现?连接业务系统时权限开到哪里?一次看起来成功的运行,到底是不是可重复的结果?
这些问题不是 Agent 的“使用技巧”之外的杂事,而是 AI 工程本身。Coding Agent 能把执行速度放大,却不会自动替团队定义正确的目标、补齐系统边界,或者证明结果已经可靠。
吴恩达此前发布的 AI Engineering Skills Map,把 AI 工程能力并列为四块:构建并部署 AI 应用、软件工程基础、使用 Coding Agent、定义并推动构建。这不是一条需要抢首发的消息;它今天仍值得回看,因为它把本文关心的问题,从“会不会用 Agent”推进到“怎样把系统交付出去”。最有用的不是争论四项能力该不该排位,而是看清一件事:Coding Agent 只是其中的执行层,不是整条交付链。
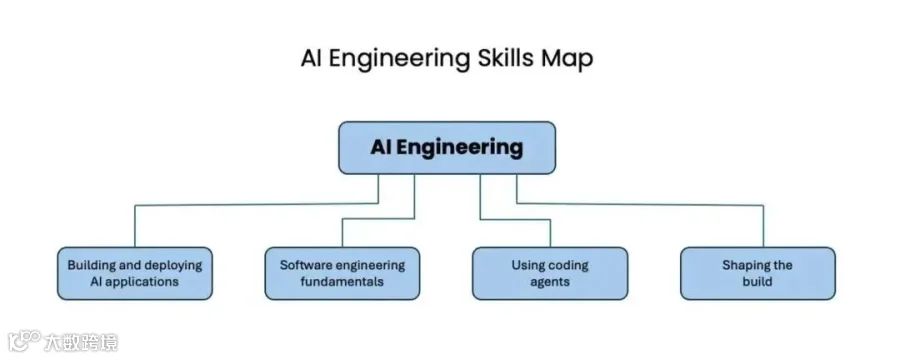 图片说明:该图列出构建与部署、软件工程基础、使用 Coding Agent、定义并推动构建四项能力。图片来源:Andrew Ng 的 AI Engineering Skills Map(经极市平台参考文转引;原帖链接见文末)
这张图也不该被读成“四门彼此独立的课”。更接近真实项目的关系是:先定义要达成的结果与约束,再把它变成可执行的任务;Agent 在这个任务里生成、修改或验证代码;工程基础决定它能接触什么数据、如何测试、怎样上线;最后由评测与反馈把结果送回下一轮决策。
下面按这条链路拆开看。
Coding Agent 擅长执行,但它需要别人给出边界
Coding Agent 不是一个会自动完成项目的“高级 IDE”。它接收的是上下文、任务、工具权限与反馈,然后在其中选择动作:读哪些文件、改哪些模块、要不要运行测试、遇到错误后如何重试。
所以“会用”不只是会下达一句自然语言命令,而是会给它一份足以行动、又不越界的工作环境。比如让它修一个登录接口,至少要说清:接口当前的异常是什么、哪些行为不能改变、可以运行哪些测试、是否允许碰数据库迁移、什么结果算修复完成。
这并不要求每个小改动都写一份冗长的 Spec。真正要补的是把模糊意图翻成可检查的约束:输入是什么,输出要满足什么,哪些副作用不能接受。
Anthropic 在工具设计的工程文章中,把 Agent 工具描述为“确定性系统”和“非确定性 Agent”之间的契约。工具的名称、参数、错误信息与测试方式,都会改变 Agent 能否正确行动。换句话说,Agent 表现不只取决于模型,也取决于人有没有把可行动的接口和反馈做出来。
因此,使用 Coding Agent 的能力更像一项执行编排能力:管理上下文,拆分可验证的任务,控制工具权限,在结果偏离时能找到该收紧提示、补文档、改工具还是交给人接管。它很重要,但它回答不了“我们为什么要做这个功能”。
“构建并部署”负责把不确定输出变成可管理的系统
传统程序在相同输入下通常应给出相同结果;生成式 AI 的输出却带有不确定性。这个区别会直接改变交付方式。
假设团队在做一个面向内部员工的知识问答助手。让 Agent 搭起检索、提示词和聊天界面,可能并不难;难的是决定系统必须在哪些问题上给出准确答案,哪些问题只能引导到人工渠道,以及如何处理过期文档、权限不同的知识库和看似流畅但没有依据的回答。
这就是“构建并部署 AI 应用”承担的职责:不是把模型 API 接进来,而是把模型放进一个可观察、可约束、可迭代的系统。它包括数据与上下文的边界、工具调用的流程、线上监控,以及最容易被跳过的 Evals(评测)。
Evals 不是发布前最后点一下的“测评”。对一个 Agent 而言,它首先要把成功定义清楚:给定什么任务、允许哪些动作、怎样判定完成。复杂 Agent 会多轮调用工具、修改环境,前一步的错误还能传到后一步;如果没有一组能复现真实任务的样本与评分方式,团队只能凭一次演示来判断它“看起来不错”。
这也是为什么“Agent 写得挺像,但产品仍不可用”并不矛盾。前者可能是一次输出的观感,后者要求在明确场景下稳定地达到结果。前者靠模型能力与提示可以改善,后者还需要系统设计与评测闭环。
软件工程基础,决定你能否看见 Agent 替你做了哪些取舍
Agent 能生成代码,并不意味着它替你承担了工程决策。
它给出一套缓存方案时,缓存失效会不会导致用户读到旧数据?它为了修复报错扩大重试次数时,会不会放大外部服务的压力?它调用一个高权限工具时,日志、鉴权和回滚在哪里?这些都不是“代码能跑”本身能回答的问题。
软件工程基础的价值,恰恰在于让人看见这些取舍:可靠性、延迟、成本、安全、可维护性之间很少存在唯一正确答案。工程师不必亲手写完每一行代码,但要能判断一个方案的假设是否成立,测试是否覆盖了真正的风险,出现故障时该看哪条链路。
这项基础也会反过来提高 Agent 的可用性。你越能准确说出模块边界、数据结构、兼容性要求与验收测试,Agent 的行动空间就越清晰;你越能读懂它的改动,就越不容易把“测试绿了”误判成“上线安全了”。
所以,Coding Agent 并没有让软件工程基础退场。它把基础能力从纯手工实现,推向了约束、审查和选择:你要负责确认 Agent 改的地方,仍然符合系统本来的承诺。
最容易被忽略的一层:谁来定义“做成了”?
如果前三层解决的是“怎样做”,最后一层解决的则是“做什么,以及何时停”。
很多 AI 项目卡住,并不是模型不够强,而是成功标准从未被说清。团队说“做个自动处理工单的 Agent”,但没有先回答:它自动处理的是哪一类工单?错分到人工的代价多大?是否允许它直接改订单?第一版要验证的是节省时间,还是提升解决率?
这些选择决定后面所有工作:Spec 写什么、给 Agent 什么权限、Evals 收集哪些任务、上线时要监控什么。也就是说,产品判断与项目推进并不是交给 Agent 的“前置行政工作”,而是为整个工程系统设定方向和终点。
一个更小、却能被清楚验证的 MVP,常常比一个泛泛的“全自动 Agent”更有价值。比如先限定它只负责归类工单、生成处理建议、由人工确认后发送;如果这一步在目标队列中稳定节省时间,再讨论是否扩大自动执行范围。这里的关键不是保守,而是让每一次扩张都有可观察的收益和可控的风险。
把四项能力接成一条工作流
如果你正在用 Coding Agent 做项目,可以不急着给自己列四份学习计划。四项能力在交付中更像下面这个反馈闭环;这只是本文用于理解项目协作的组织方式,不是原图规定的学习顺序。
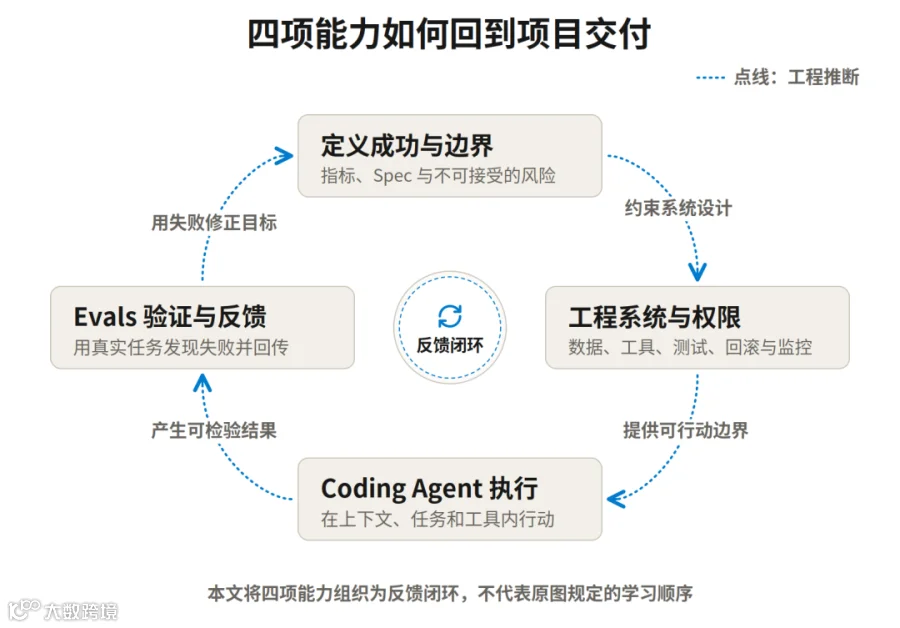
先拿一个真实需求,沿下面四个问题过一遍:
1. 结果定义:具体为谁解决什么问题?成功指标、不可接受的错误和第一版边界分别是什么?
2. 工程边界:它会读哪些数据、调用哪些工具、修改哪些状态?权限、日志、回滚和测试在哪一层兜底?
3. Agent 执行:任务能否拆成有输入、输出和验收条件的子任务?失败时,谁依据什么信号介入?
4. 评测反馈:上线前用哪些真实任务检验?线上又如何发现退化,并把失败样本送回下一轮改进?
这四个问题分别对应“定义并推动构建、软件工程基础、使用 Coding Agent、构建并部署 AI 应用”,但在项目里它们会来回循环,而不是按部门接力。
最值得警惕的情况,是只做了第三步:Agent 确实干得很快,于是团队以为项目已经前进。实际上,如果前面没有目标与边界,后面没有评测与反馈,速度只会更快地把不确定性推到用户面前。
AI 工程的变化,不是工程师从此只要会“指挥模型”。更准确的说法是:代码实现的门槛正在下降,而定义问题、设计约束、验证结果并为取舍负责的价值正在变得更显眼。
Coding Agent 很像一台效率极高的执行器。它能把一份清楚的任务推进得更快,但不会替你判断任务本身是否值得做,也不会替你为上线后的后果签字。把这三件事握在手里,Agent 才会真正成为工程能力的放大器。
参考资料
AI Engineering Skills Map 原帖: https://x.com/AndrewYNg/status/2088302050706686198
Writing effective tools for agents — with agents: https://www.anthropic.com/engineering/writing-tools-for-agents
Demystifying evals for AI agents: https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!