

哈喽,大家好~
如果训练数据没有标签,机器学习模型还能学到东西吗?
当然可以!~
只不过这一次,模型不再对着标准答案学习,而是自己观察数据之间的相似性,尝试发现隐藏的结构。
今儿我们就来聊聊无监督学习:它是什么、常见模型如何工作~
什么是无监督学习?
监督学习的数据通常长这样:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
其中“是否购买”就是标签。
而无监督学习只有前面的特征,没有最后的答案。比如我们拿到一批用户的消费金额、购买频率、访问时长,却不知道他们分别属于哪类用户。
这时候,模型会根据样本之间的距离、密度或分布,自动把相似的数据归到一起。
你可以这样理解:监督学习像“拿着答案做题”,无监督学习像“自己整理一堆没有标签的资料”。
常见的无监督学习任务包括:
-
聚类:把相似样本分组,例如 K-Means、DBSCAN。 -
降维:保留主要信息,压缩特征,例如 PCA。 -
异常检测:找出和大多数样本明显不同的数据。
K-Means 的核心原理
K-Means 是最经典的聚类算法之一。
它需要我们提前指定聚类数量 ,然后不断重复下面几步:
-
随机选择 个中心点。 -
计算每个样本与各中心点的距离,把样本分配给最近的中心。 -
重新计算每个簇的平均位置,作为新的中心点。 -
重复执行,直到中心点变化很小。
它的目标是让同一簇中的样本尽量靠近。对应的损失函数是:
这里, 表示第 个簇, 是这个簇的中心, 是某个样本。
一句话概括:K-Means 会不断调整分组,让每组数据尽量“抱团”。
比如有三类用户,消费金额分别集中在 100、500、2000 元附近,即使没有用户标签,K-Means 也有机会把这三群人分出来。
不过,K-Means 对特征尺度比较敏感。年龄和收入放在一起时,收入的数值范围可能远大于年龄,所以实际使用前通常要进行标准化。
用户分群案例
下面构造一份二维数据,把用户分成三类。第一张图展示聚类结果和决策区域,第二张图展示每个样本的轮廓系数。
轮廓系数越接近 1,说明样本越接近自己的簇、并且远离其他簇;如果接近 0,说明它处在两个簇的边界附近。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_samples, silhouette_score

X, _ = make_blobs(
    n_samples=2600, centers=[[-3, -2], [0, 3], [4, -1]],
    cluster_std=[1.2, 1.0, 1.4], random_state=42
)
X = StandardScaler().fit_transform(X)

model = KMeans(n_clusters=3, n_init=20, random_state=42)
labels = model.fit_predict(X)
score = silhouette_score(X, labels)
centers = model.cluster_centers_

fig, ax = plt.subplots(1, 2, figsize=(13, 5))

# 聚类区域
xx, yy = np.meshgrid(
    np.linspace(X[:, 0].min()-1, X[:, 0].max()+1, 300),
    np.linspace(X[:, 1].min()-1, X[:, 1].max()+1, 300)
)
grid = np.c_[xx.ravel(), yy.ravel()]
Z = model.predict(grid).reshape(xx.shape)

ax[0].contourf(xx, yy, Z, alpha=.22,
               levels=np.arange(4)-.5,
               colors=["#ff4d6d", "#00c2ff", "#ffd166"])
ax[0].scatter(X[:, 0], X[:, 1], c=labels, cmap="turbo",
              s=25, edgecolor="white", linewidth=.3)
ax[0].scatter(centers[:, 0], centers[:, 1], c="black",
              marker="X", s=180, label="cluster center")
ax[0].set_title("K-Means Clusters")
ax[0].legend()

# 轮廓系数
sil = silhouette_samples(X, labels)
y = 10
for k, color in zip(range(3), ["#ff4d6d", "#00c2ff", "#ffd166"]):
    values = np.sort(sil[labels == k])
    ax[1].fill_betweenx(np.arange(y, y+len(values)), 0, values,
                         color=color, alpha=.85)
    y += len(values) + 10
ax[1].axvline(score, color="black", ls="--",
              label=f"mean={score:.2f}")
ax[1].set_title("Silhouette Analysis")
ax[1].set_xlabel("silhouette coefficient")
ax[1].legend()

plt.tight_layout()
plt.show()
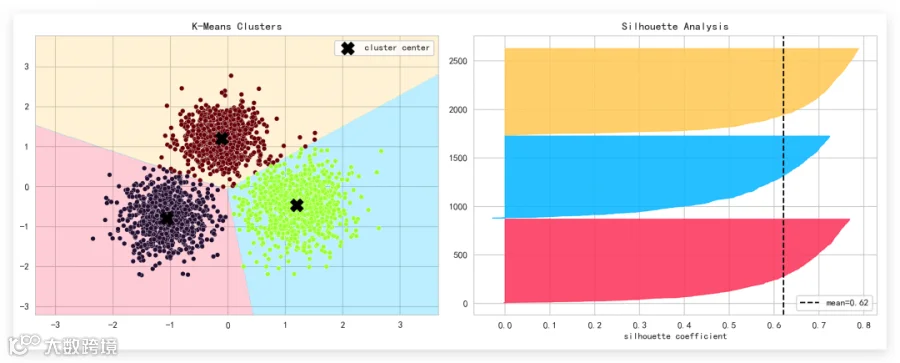
左图中背景表示模型认为各个区域属于哪个簇,黑色叉号是每个簇的中心。你可以观察样本是否形成了明显的三团,以及不同颜色之间有没有大量重叠。
右图是轮廓系数分析。每一段对应一个聚类,横向越长代表这个样本分得越自然。如果某一簇大量样本接近 0,说明当前的 可能不合适。
注意点
第一, 不是随便指定的。可以尝试不同的 ,结合轮廓系数、肘部法则和业务理解共同判断。
第二,聚类结果不一定代表真实类别。模型找到的是数据中的相似结构,最终还需要结合业务解释这些簇到底意味着什么。
第三,异常值会影响中心位置。如果数据中存在极端样本,可以考虑 DBSCAN、层次聚类,或者先进行异常值处理。
第四,特征工程同样重要。用户分群时,单纯使用原始金额不一定有效,加入“月均消费”“购买频率”“最近一次购买间隔”等特征,通常更容易得到有价值的分组。
最后
无监督学习不依赖人工标签,而是从数据本身寻找相似性、结构和异常点。K-Means 通过不断更新聚类中心,让同一组样本尽量靠近;轮廓系数则可以帮助我们判断聚类是否合理。
接下来大家可以尝试把 K-Means 换成 DBSCAN,观察它如何识别噪声;也可以增加特征,再用 PCA 将高维数据压缩到二维进行可视化。
总之就是说,无监督学习的重点不只是“分成几组”,更是理解这些组背后代表的真实含义。