

哈喽,大家好~
大家有没有遇到这样的问题,数据波动这么大,直接删掉异常值可以吗?”
事实上,有些波动是噪声,有些却是重要信号。”
在机器学习项目中,采集到的数据经常带有测量误差、随机抖动和瞬时尖峰。如果直接拿去训练,模型很容易追着噪声跑,最终出现过拟合。
今儿我们就来聊聊数据平滑:它到底在平滑什么,常见方法怎么选~
什么是数据平滑
数据平滑不是简单地“把曲线变好看”,而是尽量削弱随机噪声,同时保留趋势、周期和拐点等有效信息。
比如某个温度传感器的真实读数是:
20.1、20.3、20.5、20.6、20.8
但受设备干扰,实际采集结果变成:
20.0、20.5、25.8、20.4、20.9
这里的25.8很像瞬时尖峰。如果模型把它当成正常规律,预测结果就会被带偏。
一句话概括:平滑不是消灭波动,而是区分“真实变化”和“随机抖动”。
常见平滑方法与原理
移动平均
以当前点为中心,计算附近数据的平均值:
其中, 是原始数据, 是平滑结果, 控制窗口大小。
窗口越大,曲线越平稳,但峰值和拐点也更容易被抹掉。
指数加权平均
指数加权平均会让近期数据拥有更高权重:
越大,结果越关注当前值,响应更快; 越小,曲线越平滑。
Savitzky-Golay平滑
它会在局部窗口内拟合一个低阶多项式,而不是直接求平均。因此,它对峰形、斜率和拐点的保留通常更好。
不过,遇到特别大的异常尖峰时,Savitzky-Golay也会被影响。实战中可以先用中值滤波处理尖峰,再做平滑。
Python实现
我们构造一组传感器数据,其中包含趋势、周期、随机噪声和异常尖峰,然后比较四种方案~
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy.signal import savgol_filter
from scipy.ndimage import median_filter
from sklearn.metrics import mean_squared_error

np.random.seed(42)
n = 300
t = np.arange(n)

# 真实信号:上升趋势 + 长短周期
true_signal = (
    0.015 * t
    + 2.0 * np.sin(2 * np.pi * t / 60)
    + 0.8 * np.sin(2 * np.pi * t / 18)
)

# 加入随机噪声
observed = true_signal + np.random.normal(0, 0.65, n)

# 加入异常尖峰
spike_idx = np.random.choice(np.arange(10, n - 10), 10, replace=False)
observed[spike_idx] += np.random.choice([-1, 1], 10) * \
                       np.random.uniform(4, 7, 10)

series = pd.Series(observed)

# 四种平滑方案
rolling = series.rolling(11, center=True, min_periods=1).mean().to_numpy()
ewma = series.ewm(alpha=0.22, adjust=False).mean().to_numpy()
savgol = savgol_filter(observed, window_length=17, polyorder=3)

# 先中值滤波去尖峰,再进行SG平滑
median_sg = savgol_filter(
    median_filter(observed, size=5),
    window_length=17,
    polyorder=3
)

results = {
    "Rolling Mean": rolling,
    "EWMA": ewma,
    "Savitzky-Golay": savgol,
    "Median + SG": median_sg
}

colors = {
    "Rolling Mean": "#00B8D9",
    "EWMA": "#FF8B00",
    "Savitzky-Golay": "#6554C0",
    "Median + SG": "#00C853"
}

# 图1:全局、局部、误差和动态误差分析
fig, axes = plt.subplots(2, 2, figsize=(15, 9))

axes[0, 0].plot(t, observed, color="#FF4081", alpha=0.45, label="Observed")
axes[0, 0].plot(t, true_signal, color="#172B4D", linewidth=2.5, label="True")
axes[0, 0].scatter(spike_idx, observed[spike_idx],
                   color="#FF1744", marker="x", s=70, label="Spikes")
axes[0, 0].set_title("Raw Signal and Outliers")
axes[0, 0].legend()

for name, values in results.items():
    axes[0, 1].plot(t, values, color=colors[name], label=name)
axes[0, 1].plot(t, true_signal, "--", color="#172B4D", label="True")
axes[0, 1].set_title("Smoothing Method Comparison")
axes[0, 1].legend(fontsize=8)

start, end = 100, 180
axes[1, 0].plot(t[start:end], observed[start:end],
                color="#FF4081", alpha=0.35, label="Observed")
axes[1, 0].plot(t[start:end], true_signal[start:end],
                color="#172B4D", linewidth=2.5, label="True")
for name, values in results.items():
    axes[1, 0].plot(t[start:end], values[start:end],
                    color=colors[name], label=name)
axes[1, 0].set_title("Local Detail: Trend and Peak Preservation")

# 滑动RMSE:观察不同时间段的局部误差
for name, values in results.items():
    local_rmse = pd.Series((values - true_signal) ** 2)\
                   .rolling(21, center=True, min_periods=1)\
                   .mean() ** 0.5
    axes[1, 1].plot(t, local_rmse, color=colors[name], label=name)

axes[1, 1].set_title("Rolling RMSE Over Time")
axes[1, 1].set_ylabel("Local RMSE")
axes[1, 1].legend(fontsize=8)

for ax in axes.flat:
    ax.grid(alpha=0.2)

plt.tight_layout()
plt.show()

# 图2:误差与平滑程度联合比较
names = ["Raw"] + list(results.keys())
all_values = [observed] + list(results.values())

rmse = [
    np.sqrt(mean_squared_error(true_signal, values))
    for values in all_values
]

# 二阶差分衡量曲线粗糙程度
roughness = [
    np.mean(np.abs(np.diff(values, n=2)))
    for values in all_values
]

fig, ax1 = plt.subplots(figsize=(12, 5))
bar_colors = ["#FF4081", "#00B8D9", "#FF8B00", "#6554C0", "#00C853"]

ax1.bar(names, rmse, color=bar_colors, alpha=0.85)
ax1.set_ylabel("RMSE", color="#D50000")
ax1.set_title("Accuracy and Smoothness Trade-off")

ax2 = ax1.twinx()
ax2.plot(names, roughness, color="#172B4D",
         marker="o", linewidth=2.5, markersize=8)
ax2.set_ylabel("Roughness", color="#172B4D")

ax1.grid(axis="y", alpha=0.2)
plt.tight_layout()
plt.show()

for name, r, q in zip(names, rmse, roughness):
    print(f"{name:18s} RMSE={r:.3f}, Roughness={q:.3f}")
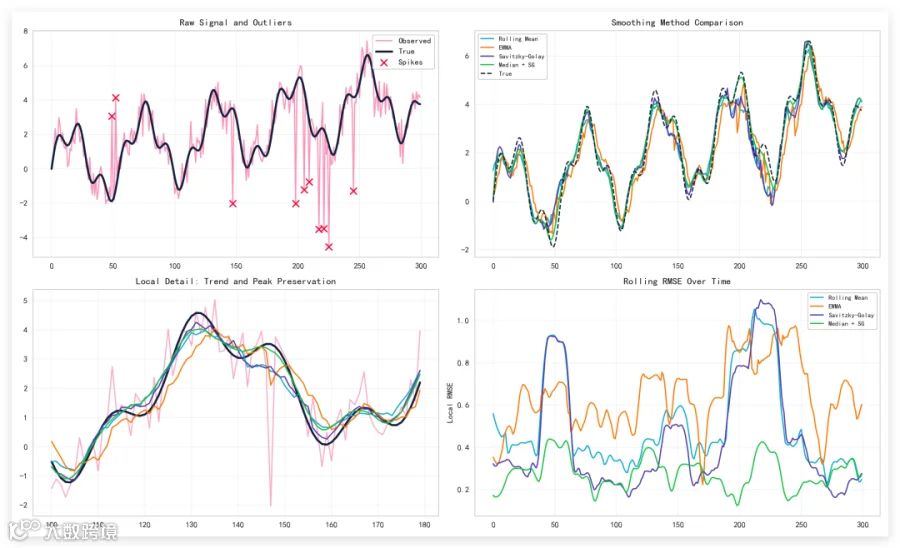
第一张图不只是比较曲线是否平滑。
左上角展示原始数据和异常尖峰;右上角比较四种方法的整体趋势;左下角放大局部区域,重点观察峰值和拐点有没有被削弱;右下角则通过滑动RMSE,检查某些时间段是否出现明显失真。

第二张图分析的是“准确度和平滑度之间的平衡”。柱子越低,说明结果越接近真实信号;折线越低,说明曲线越平稳。
在这组数据中,Median + SG通常表现更好。原因很直接:中值滤波先处理异常尖峰,Savitzky-Golay再保留局部形状,两者分工比较明确。
注意事项
窗口大小并不是越大越好。周期较短的数据使用大窗口,会把真实峰值一起抹掉,可以从周期长度的 左右开始尝试。
另外,居中移动平均使用了未来数据。如果是实时预测,容易产生数据泄漏,此时应该改用单边窗口或EWMA。
还有一点很重要:异常检测任务不要盲目平滑。因为那些看起来“不平滑”的尖峰,本身就可能是我们要找的故障信号。
总结
数据平滑的核心,是在降噪和保留信息之间找平衡。普通噪声可以尝试移动平均或EWMA,强调峰形时可以使用Savitzky-Golay,尖峰较多时则推荐“中值滤波 + SG”。
接下来大家可以继续尝试调整窗口和 ,观察误差变化;也可以把平滑前后的数据分别送入回归模型,用验证集指标判断平滑是否真的提升了模型效果~