大数跨境

AI测试对话式评估:测LLM多轮不能只看单轮问答(下)

AI测试对话式评估:测LLM多轮不能只看单轮问答(下) 51Testing软件测试网
2026-09-15
5
导读:真实RAG测试中,对话完整性保持1.0,语义精准性与认知谦逊性降至0.8,扣分源于原文跨层面类比与语气分寸;对话式指标定位问题,单轮指标查根源。
点击查看上期,我们了解对话式评估测试案例、三种失败模式和完整脚本,今天我们将继续深入学习~

第二部分:真实 RAG 测试

搭建真实检索
跑真实对话之前,脚本先加载文章,输出当前处理的内容:
和之前那篇连贯性文章对比差异很明显。那篇 65808 字符,切了 132 片。这篇大概一半大小,35098 字符,同样 600 字符切片、100 字符重叠,切了 70 片。
差异来自两篇文档的结构。那篇有十三节,每节都有大段展开。
这篇十二节,但好几节更紧凑、论证更浓缩:短路章节、孤立信息章节、自举悖论章节,都比之前那篇里对应的内容短。
600 字符切片切出 70 片,说明检索的粒度是合理的。k=3 的话,每轮对话从 70 片里找最相关的 3 片,大概前 4% 的内容。
比之前那篇的筛选更严格,效果好不好要看章节标题和词汇引导向量匹配的效果。
对话结构还带来了额外变量:每一轮都只根据当前问题独立检索,不知道之前几轮检索了什么。每轮的检索能不能连贯支撑四轮对话,就是我们要测的一部分。
对话 A—— 真实 RAG(完整性)
我得到的输出如下:
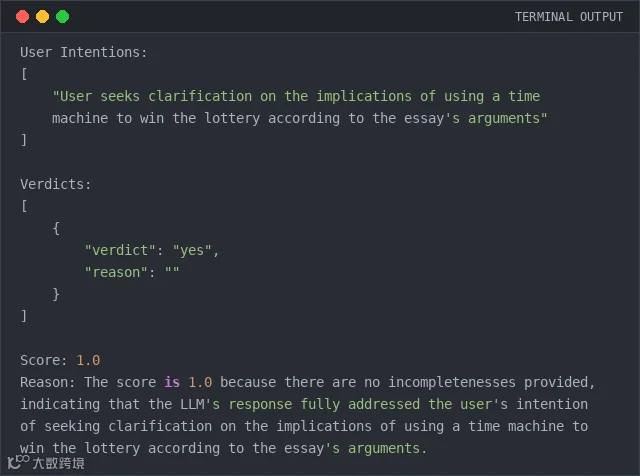
真实案例完整性得分 1.0,和控制基准一样。但得分背后的过程比数字本身有意思,详细输出里有很多值得分析的细节。
检索情况:检索整体是合适的。
  • 第一轮抽到了开头的谜题设定和两个朴素假设。
  • 第二轮抽到了电网级联和时序敏感性章节。
  • 第三轮抽到了祖父悖论对比和混沌放大论证。
  • 第四轮就有意思了:检索抽到了记忆和 “天主之像” 章节的片段,不是诺维科夫相关的段落。
片段里提到 “自洽性要求不只是时间线的特征,也是人的特征”,还有意识和悖论的相关内容。这些都来自文章后半部分,超出了问题对应的范围。
模型的处理:这是关键观察点。
我的输出里,模型第四轮回答引用了哥德尔章节的片段 ——“未来依赖过去,过去被未来改变,两者的内容互相依赖”,用来回答诺维科夫的问题。
那段话本来不是专门讲诺维科夫自洽性的,是讲因果循环的自指结构。
模型把它包装成诺维科夫的论点,给出了听起来很连贯的回答,但回答用的素材和问题对应的章节不是同一个。
这和我们之前讲曲速引擎那篇文章时,忠实度和上下文精准度里看到的失败模式一样:检索有缺口的时候,模型会用邻近的内容来补。
回答不算错,和文章的整体论证是一致的,但不是精准对应诺维科夫章节的内容。
为什么完整性还是 1.0:完整性指标评估的是用户的目标有没有达成,不是每个回答是不是用了最优片段。
用户想通过四轮提问搞懂时光机中彩票方案的含义,四轮下来模型给出了扎实、主题连贯的回答,层层递进。
历史管理也起作用了:第四轮回答明确引用了第三轮提到的诺维科夫原则,说明模型记住了对话脉络。在指标看来,这段对话是完整的。
这就是对话完整性和检索忠实度的重要区别。对话可以是完整的 —— 完全达成用户目标,但个别回答用的片段不对。
完整性告诉你对话在用户意图层面成不成功,不会告诉你每轮的检索准不准。
要完整诊断的话,同一份材料既要跑对话式指标,也要跑单轮指标,这也是这个系列一直在搭建的分层评估思路。
还有一点值得提:模型那种分点、加粗标题、“最终答案” 的格式化,是 ts-reasoner 模型的风格,不是检索好坏的标志。
完整性指标正确忽略了格式,只评估传达的内容。但生产环境里要注意:模型过度结构化回答的话,可能会用有条理的外表掩盖检索的缺口。
这点你测 ChatGPT、Claude、Grok、Gemini 的时候会很明显。不过我们这里已经搭建好了测试基础,可以做客观评估。
对话 B—— 真实 RAG(语义精准性)
输出结果如下:
得分从控制组的 1.0 降到了 0.8,扣得很明确,原因正好指向这段对话设计要暴露的失败模式。
指标发现,虽然每轮都答到了对应的概念,但交流过程中慢慢出现了混淆,区分没有控制组里那么清晰。
只看截断的轮次输出很难定位具体哪里混淆了,得看完整回答,但结合检索的情况,这个模式是可预测的。
三种一致性分布在文章不同章节:物理一致性在短路和诺维科夫章节,逻辑一致性在哥德尔章节,心理一致性在记忆章节。
每一轮都只根据当前问题检索,不知道之前几轮的检索结果。
对于对话 B 这种词汇陷阱类对话,这就会产生特定风险。
  • 第一轮问物理一致性,检索到对应片段。
  • 第二轮问哥德尔,检索哥德尔章节。
  • 第三轮问记忆,检索到的内容讲一致性的时候,很容易跨层面,因为记忆章节本身就同时联系了物理和逻辑层面来论证。
文章明确说,悖论性的记忆就是 “意识里的哥德尔语句”。
模型基于这段内容展开的话,自然会在讲记忆的时候把逻辑和心理层面混起来,因为文章本身就是用逻辑层面来解释心理层面的。
扣 0.2 分就是指标精准抓到了这个渗透。模型不是自己瞎编的混淆,其实是顺着文章的论证结构来的,文章本身就是用跨层面的类比来论证的。
但从评估者的角度,回答说记忆做的是 “和哥德尔一样的一致性工作”,但没有重新明确区分两者,就算是部分混淆了。
这个测试结论很具体:对话式评估里的语义精准性失败,很多时候根源在原文,不在模型。
文章故意用一个层面的概念去解释另一个层面的时候,忠实总结的模型自然会带出跨层面的表述。
指标真正问的是,模型用完类比之后,有没有重新把区分立住,还是让类比把类别冲没了。
0.8 分说明模型做得不算完美:大部分区分都守住了,但有一两个类比没拉回来,锚定得不够。
这种失败模式比检索缺口、话题跑偏更细腻。模型没忘记对话内容,也没有轮次间重置,它忠实跟随了论证,也因此重现了文章本身修辞策略里的张力。
这正是对话式评估,尤其是带精确定义标准的ConversationalGEval,才能挖出来的细腻结论。
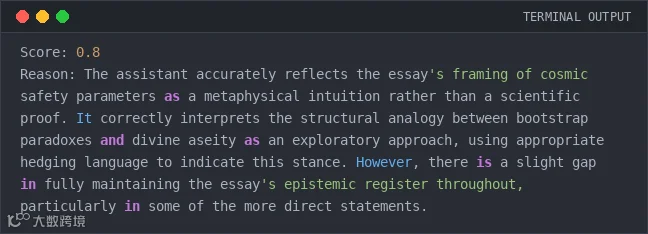
对话 C—— 真实 RAG(认知谦逊性)
输出结果如下:
得分和对话 B 一样,但原因不同。对话 B 扣分是因为跨层面类比混淆了相似概念,这里扣分是因为更细腻的问题:模型有些表述比文章本身的语气 “更肯定”。
这正是对话 C 设计要抓的失败模式,得搞清楚具体情况。文章里神学和形而上学的论证一直很有分寸:“可能”“也许”“在这个视角下”“指向”“暗示”。
这些分寸不是修辞装饰,是文章真诚的信号:它是在探索结构上的呼应,不是在下结论。
如果模型把文章里 “可以解读为 X” 说成 “文章论证了 X”,就是越权强化了论证。
第一轮陷阱题 —— 文章是不是用时间旅行不可能证明上帝存在,模型答对了:说没有。
这个最关键。看我的输出,第二、三轮基本都守住了架构论证和证明的区别,所以得分是 0.8 不是更低。
扣分基本肯定在第四轮,就是让模型判断自举悖论和神性自存对应关系的强弱的时候。
要把这个对应关系放在 “有力论证” 到 “弱类比” 的标尺上定位,需要模型精准还原文章本身的谨慎态度。而指标发现,至少有一处表述,比文章本身的语气更肯定。
这里的诊断价值和对话 B 不一样。对话 B 的问题根源在检索:文章跨层面的修辞被忠实还原,但锚定不够。
这里的问题更偏向生成侧:模型正确理解了论证,但表述的时候比原文稍微肯定了一点。
这是生成端的失败,不是检索端的,也是忠实度、精准率、召回率、相关性这些指标都发现不了的,正是认知语气评估要抓的。
把两个真实 GEval 得分放一起对比很有启发。都是 0.8 分,但扣 0.2 的原因完全不同:
  • 对话 B 丢分是因为混淆了相似但不同的概念,是精准性问题,根源是文章用跨层面类比做论证的方式
  • 对话 C 丢分是因为文章用了委婉表述,模型说得更直接,是语气问题,根源是模型对文章结论的力度判断偏强
都是真实的失败模式,没有对话式 GEval 框架和我们定义的标准都发现不了。
而且追根溯源,都是原文本身的属性,不是模型的缺陷:文章的修辞策略,刚好给检索和生成造成了对应的压力,催生了这些失败模式。

结果解读

六个案例都跑完之后,结果表能最清楚地展示对话式评估的发现:
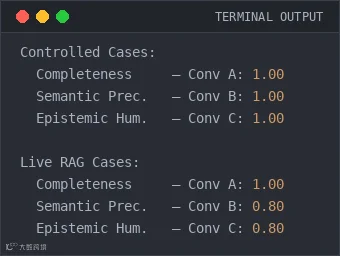
模式很清晰。三个控制案例都是 1.0,说明基准有效:人工写的回答在四轮对话里都守住了完整性、语义区分、认知语气。
然后真实 RAG 案例和基准出现了明确且有意义的分化:对话 A 保持 1.0,对话 B 和 C 降到 0.8。
这个分化不是随机的,对应了三组对话的结构和每个指标的测量目标。
对话 A 得分稳住了,因为ConversationCompletenessMetric评估的是整段交流有没有达成用户目标。
每轮检索都找到了相关片段,历史管理避免了模型重置,模型给出的回答层层递进。
用户想理解中彩票方案的含义这个目标达成了。完整性不会因为模型用了邻近片段、或者跨章节整合就扣分,它只看对话有没有达成用户意图,这段达成了。
对话 B 和 C 扣分,是因为ConversationalGEval评估的是更细粒度的属性,完整性看不到这些。语义精准性会犯跨层面混淆,哪怕对话整体是完整的。
认知谦逊性会罚语气漂移,哪怕论证本身理解对了。这两种失败模式完整性评估都看不见:对话可以很完整,但精准度和语气照样丢分。
这里很重要的测试结论是:三个指标不是冗余的。
它们测的是不同的东西,同一段对话每个得分不一样,不矛盾。完整性 1.0 加语义精准性 0.8,不是悖论,意思是对话达成了用户目标,但概念区分做得不够完美。
完整性 1.0 加认知谦逊性 0.8,意思是目标达成了,但偶尔会把原文的分寸说得太满。都是真实的结论,缺了对应的指标就发现不了。
对话 B 和 C 各扣 0.2,也有共同的根源,虽然针对的失败模式不同。两者都来自原文本身的属性,不是模型的缺陷。这点很重要,测模型的时候要搞清楚。
文章用跨层面类比来论证:把悖论性记忆称作 “意识里的哥德尔语句”,把诺维科夫原理和霍金时序保护联系起来,把自举悖论比作神性自存的结构镜像。
这些修辞手法正是文章的思想价值所在。
但也正是这些手法,给多轮总结的模型造成了压力:模型既要重现文章的类比推理,又不能让类比冲散了文章本身维持的区分,也不能把文章试探性的分寸说成肯定的结论。
这里的测试结论是:对话式评估能暴露论证类文档特有的失败模式。
这类用类比、跨层面推理、刻意拿捏分寸的修辞做工具的文档,比如议论文、分析文、哲学文章、法律文书,带来的评估挑战和纯事实类文档不一样。
技术论文的论断可以对照检索片段验证:比如之前看的曲速引擎论文,片段里写了能量需求是 10^28 千克就是写了,没写就是没写。
但论证类文章的表达,只能对照文章整体的修辞策略来评估:不只是说了什么,还有说得有多肯定;不只是做了什么区分,还有整个论证里把区分维持得有多仔细。
单轮指标能很好地评估前一种论断,后一种就需要带精确定义标准的对话式指标。

核心测试发现

六组测试案例,三组对话,两类指标,一篇从混沌理论讲到哥德尔再到经典神学的论证文章。浮现出来的规律,在文章结尾值得梳理一下。
控制案例和这个系列每次的作用一样:验证指标有效、标准合理、基准成立。三个都拿了 1.0。这不是关于模型或者检索器的结论,是关于测试设计的。
如果控制案例的人工回答拿不到 1.0,就说明标准还要调整,才能解读真实结果。这次基准很稳,说明真实场景的扣分是有效信号,不是噪音。
第一个发现:run_conversation辅助函数里的历史管理非常关键。
对话 A 真实案例的完整性拿了 1.0,说明模型成功在四轮对话里维持了论证脉络,第四轮引用诺维科夫,是因为第三轮提到了它,第二轮的扰动论证建立在第一轮的基础上。
如果每个提示都不带历史字符串,这些关联就不会存在。模型会每轮单独回答,产出单独看都连贯,但整体脱节,完整性就会失败。基础架构和指标本身一样重要。
第二个发现:对话式完整性和单轮忠实度测的是不同的东西,结果可能差很多。对话 A 完整性拿了 1.0,但第四轮检索抽到的是记忆和神学章节的片段,不是诺维科夫问题对应的段落。
模型用邻近材料合成了连贯的回答,完整性认可了这个结果,因为用户目标达成了。但同一轮的忠实度指标就会标记出来,说回答超出了检索内容。
两个结论都没错,它们揭示的是同一条流水线的不同层面。生产环境两个都需要。
第三个发现:对话 B 和 C 各扣 0.2,虽然针对的失败模式不同,但结构根源是一样的。都来自文章本身的修辞策略:跨层面类比和刻意的认知分寸,都是文章的论证工具。
语义精准性扣分,是因为模型忠实还原了文章的跨层面推理,但之后没有把区分重新锚定清楚。
认知谦逊性扣分,是因为模型准确理解了论证,但表述的分寸比原文稍微强了一点。
两种情况模型都是在跟随文档,指标发现的是:忠实跟随文档,和精准代表文档,不完全是一回事。
理解这个区别,对于理解生成式 AI 用源文档的时候效果好不好、为什么好或者不好,非常关键。
这也引出一个值得明确的点:论证类文档,比如杂文、分析、哲学文章、法律文书,带来的评估挑战和纯事实类文档不一样。
技术论文的主张可以对照检索片段验证,但论证类文章的表达,只能对照文章整体的修辞策略来评估。
单轮指标能充分评估事实类论断,但论证层面的评估,需要带精确定义标准的对话式指标。
第四个发现:这套脚本里的三个对话式指标不是完整的工具包,是起点,帮你定位该往哪个方向深挖。
完整性 1.0 加语义精准性 0.8,说明系统达成了用户目标,但概念区分做得不够。
接下来要诊断的就是,精准性问题是出在检索,还是出在生成。要回答这个问题,就要在出问题的那几轮上单轮跑相关性和忠实度指标。
对话式指标定位问题,单轮指标定位根源。
对话式指标找问题、单轮指标查根源的这种配合,就是这个系列一直在搭建的更大的评估框架。
  • 忠实度告诉你模型说了哪些检索内容里没有的话。
  • 精准性告诉你最相关的片段有没有排在前面。
  • 召回率告诉你该找的片段有没有都找到。
  • 相关性告诉你检索出来的内容有多少噪音。
  • G-Eval 告诉你模型有没有尊重文档的论证。
  • 完整性告诉你对话有没有达成用户目标。
  • 语义精准性告诉你轮次之间有没有守住区分。
  • 认知谦逊性告诉你文档的语气有没有保留。
从测试角度说,没有哪个单一指标能覆盖全部。诊断全貌需要组合使用,选哪些指标,取决于你评估的是什么文档、会问什么问题、你的系统最在意什么失败模式。

E n d

图片

【声明】内容源于网络
0
0
51Testing软件测试网
博为峰51Testing软件测试网提供各种线上招聘、线上课程等网络服务,出版软件测试系列丛书及电子杂志,组织线上技术交流活动;同时还举办多种线下公益活动,如软件测试沙龙、软件测试专场招聘会等。
内容 3945
粉丝 0
51Testing软件测试网 博为峰51Testing软件测试网提供各种线上招聘、线上课程等网络服务,出版软件测试系列丛书及电子杂志,组织线上技术交流活动;同时还举办多种线下公益活动,如软件测试沙龙、软件测试专场招聘会等。
总阅读3.5k
粉丝0
内容3.9k