

 LLM Wiki简介
AI/ML
LLM Wiki 是一款跨平台桌面应用,灵感源自 Andrej Karpathy 提出的 LLM Wiki 模式。与传统 RAG(每次查询重新检索)不同,它让大语言模型增量式地阅读你导入的文档,自动提取实体、概念和关联,构建并持续维护一个结构化的个人 Wiki 知识库。知识只需编译一次即可持久保存并保持更新。

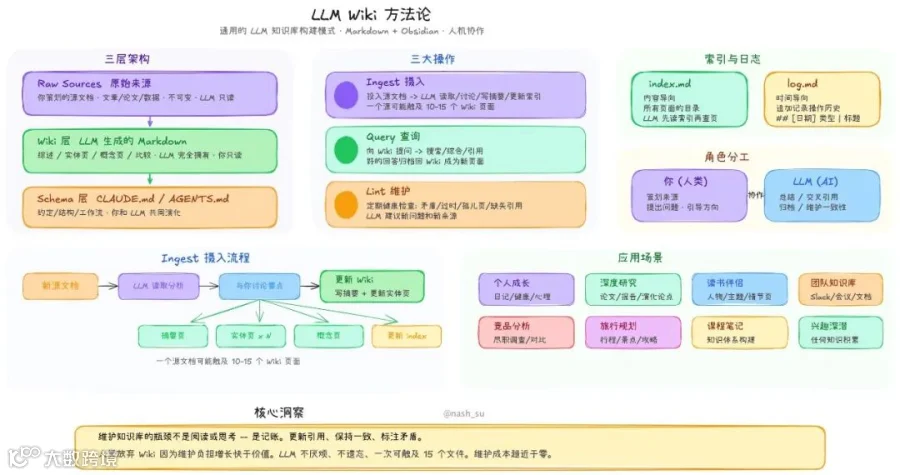
项目采用 Tauri v2 (Rust) + React 技术栈,支持 PDF、Office、EPUB 等多种格式解析,内置两步思维链摄入、四信号知识图谱、Louvain 社区发现、异步人工审核队列以及深度研究功能。同时兼容 Obsidian,并提供本地 HTTP API 和 MCP Server,方便与外部 AI Agent 无缝集成。
三层架构:Raw Sources(不可变原始资料)→ Wiki(LLM 生成内容)→ Schema(规则与配置)。
 亮点特性
01两步思维链摄入机制
将文档处理拆分为“分析”与“生成”两个独立的 LLM 调用,显著提升知识提取质量,并结合 SHA256 哈希实现增量缓存,节省 Token 消耗。
02四信号知识图谱与社区发现
综合直接链接、来源重叠、Adamic-Adar 算法和类型亲和力计算节点相关性,并利用 Louvain 算法自动发现知识聚类,直观暴露知识盲区。
03Rust 后端 Agent 与开放生态
聊天由 Rust 后端驱动,支持工具调用;内置本地 HTTP API 和 MCP Server,可通过一行命令将知识库接入 Claude Code 等外部 AI Agent。
 使用场景
场景 1学术研究与文献管理
批量导入论文 PDF,自动提取核心概念、研究方法和学者实体,通过知识图谱发现不同文献间的隐藏联系与研究空白。
场景 2个人读书笔记系统
导入 EPUB/MOBI 电子书或网页剪藏,自动生成书籍摘要和概念卡片,形成可长期积累的个人第二大脑。
场景 3企业项目知识沉淀
将项目文档、会议记录、需求文档导入系统,自动梳理业务实体与技术概念,供团队成员通过对话快速检索项目上下文。
 使用环境
 快速上手

安装步骤
方式一:下载预编译版本
前往 Releases 页面下载对应系统的安装包(支持 macOS .dmg、Windows .msi、Linux .deb / .AppImage)。
方式二:从源码构建
|
基本配置
-
启动应用后创建一个新项目(可选择 Research、Reading 等预设模板)。 -
进入 Settings,配置你的 LLM 提供商(如 OpenAI、Anthropic、Ollama 等),填入 API Key 和模型名称。 -
(可选)在设置中配置 Web Search 提供商(Tavily/SerpApi/SearXNG)以启用深度研究功能。
核心用法示例
- 导入文档
:进入 Sources 面板,拖入 PDF、DOCX 或 Markdown 文件,观察 Activity Panel 中的处理进度。 - 查看生成结果
:LLM 会自动在 wiki/目录下生成实体页、概念页及来源摘要,可通过左侧树状图浏览。 - 对话检索
:在 Chat 面板向知识库提问,系统会结合分词搜索、图谱扩展和向量检索给出带引用的回答。 - 图谱探索
:切换到 Graph 面板,可视化查看知识点之间的关联,点击 Insights 发现意外的知识连接。
 替代方案
对比 1Obsidian + 智能插件
Obsidian 是强大的本地 Markdown 笔记工具且本项目生成的 Wiki 兼容 Obsidian,但 Obsidian 原生不具备 LLM 自动提取实体和构建图谱的能力,需要依赖大量第三方插件手动配置。
对比 2AnythingLLM
一款流行的本地 RAG 知识库工具,侧重于文档上传后的即时问答,而 LLM Wiki 侧重于将文档转化为持久化、结构化的 Wiki 页面网络,更适合长期的知识沉淀而非单次检索。
对比 3Logseq
基于大纲的双链笔记软件,适合碎片化记录,但缺乏 LLM 驱动的自动化文档解析、多模态图片处理和深度研究能力。
 相关资源
项目地址github.com/nashsu/llm_wiki
官网x.com/nash_su