


我花了整整两周,把最近半年后训练方向的新论文几乎翻了一遍。翻完之后最大的感受是:配方变了,而且不是小修小补,是范式级别的更换。
最典型的信号是——现在你问一个做后训练的人「你们怎么训的」,答案不再是「一个大模型 + 一套 RL pipeline」,而是「先训 N 个领域专家,再蒸馏合并回一个通用模型」。
这句话在 2025 年底说出来,会被认为是奇技淫巧。在 2026 年说出来,是标准答案。
下面我把这半年的变化,梳理成 5 条路径。每条路径我都附上了必读论文。
如果你不想一篇篇找这些论文,也可以用我这个可交互的在线学习资料:
·22 篇论文,全部核验过 arXiv 编号和开源仓库
·5 条路径拆解,每篇配一句话核心贡献
·可勾选的学习进度表,读完一篇打一个勾
·按依赖关系排好的推荐阅读顺序

需要的朋友,加小助理微信,发送「后训练」获取

变化 01
从一个模型,到一群专家
过去我们默认:后训练就是拿一个基座模型,数学 RL、代码 RL、agent 能力 RL 全都塞进同一个 run 里一起训。
问题在于,这三种能力会互相打架。
数学要求模型严谨收敛,代码希望它多探索不同实现,agentic 任务又需要它长程规划——放在一起训,就是典型的跷跷板:这边涨了那边掉,成本还高得离谱。
2026 年的解法很反直觉:别放在一起训了,分开训。
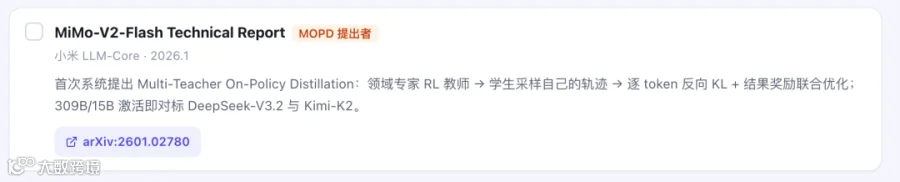
这个范式的提出者是小米的 MiMo-V2-Flash 技术报告,叫 MOPD(Multi-Teacher On-Policy Distillation)。它的做法是:领域专家作为教师,学生模型采样自己的轨迹,用逐 token 的反向 KL 加上结果奖励联合优化。
变化 02
在线蒸馏,正在成为 RL 的"廉价替代"
RL 的问题是奖励太稀疏——模型吭哧吭哧写 2000 个 token,最后只拿到一个"对/错"的信号。中间那么多步推理,哪些走对了、哪些走偏了,全都没反馈。
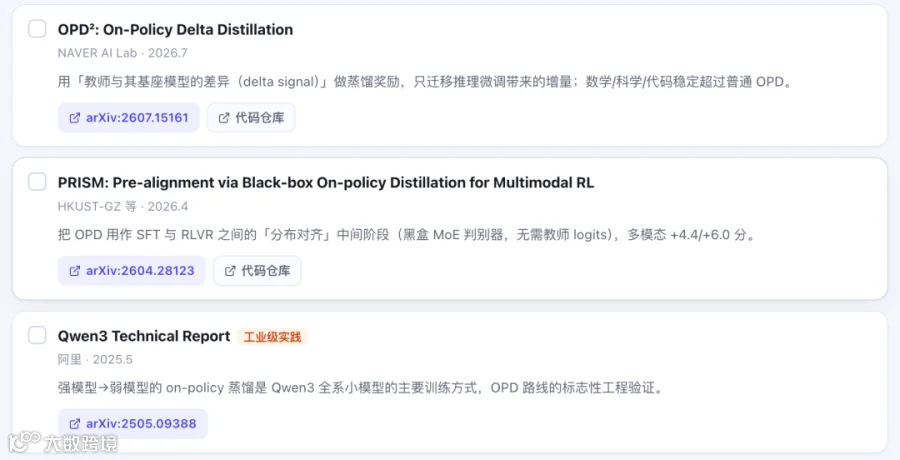
在线蒸馏不一样:教师模型对学生的每一个 token 都给出密集反馈。
一次 RL run 大概 17,920 GPU 时,而在线蒸馏只需约 1,800 GPU 时。差不多是 10 倍的差距。
变化 03
RLVR 进入"精细化"阶段
如果说 2025 年 RLVR 的关键词是"堆算力",2026 年上半年就换成了三个字:更聪明。
具体聪明在哪?六个小方向,一个一个说。
①熵坍缩——模型越训越窄
训着训着,模型的输出越来越同质化,多样性掉光,最后只会一种解法。这是 RLVR 最普遍的病。
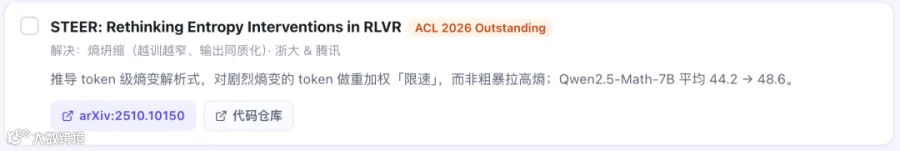
主流做法是"把熵拉高",但粗暴拉高会让模型开始胡说。STEER 换了个思路:推导出 token 级别的熵变解析式,只对"熵变剧烈"的那些 token 做重加权限速。
Qwen2.5-Math-7B 上,平均分从 44.2 提到 48.6。这篇拿了 ACL 2026 杰出论文。
②探索不够——轨迹都长一个样
同一个 prompt 采样 16 次,16 条轨迹几乎一模一样,等于白采样。
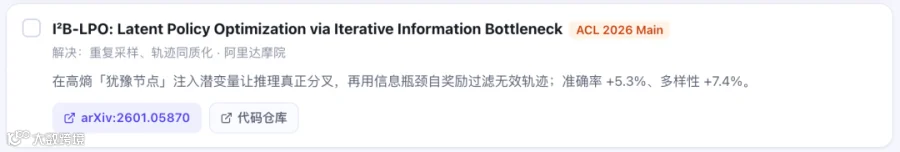
I²B-LPO 的做法很有意思:找到推理中的"高熵犹豫节点"(模型真正纠结的地方),在那里注入潜变量,逼推理分叉;再用信息瓶颈给自己发奖励,把无效轨迹过滤掉。
准确率 +5.3%,多样性 +7.4%。
③选题——哪些题值得花算力
rollout 太贵,但大部分题对模型来说要么太简单(学不到)、要么太难(学不会)。
GPS 训了一个只有 20M 的小模型,跨 prompt 共享"难度知识",按"中等难度优先 + 多样性"选题。最多省 69% 的 rollout。

④能力边界坍缩——pass@1 涨了,pass@256 反而降
你在训练集上 pass@1 一直涨,很开心。但去看 pass@256,可能反而比基座模型还低。模型没变强,只是把已经会的东西概率调高了,原来有希望做对的难题,现在彻底不会了。
Boundary-Aware Curriculum RL 用 pass@256 定位模型真正的能力边界,对"边界上的题"做定向引导。pass@256 平均 +9.8 个百分点。

⑤遗忘——推理涨了,通用能力掉了
推理能力上去了,但写文案、做翻译、日常对话都变笨了。
RECAP 的做法是回放通用数据,再按"目标收敛度"和"不稳定性"动态重加权。通用能力保住了,推理还更好。

⑥参数效率——0.5% 参数干全参的活
GeoRA 有个很漂亮的观察:RLVR 带来的参数更新是稀疏的,而且系统性地避开预训练已经学好的主方向。
于是它先用几何先验定位这个子空间,再用 SVD 压成低秩稠密适配器。0.5% 的参数,接近全参效果。这篇同样是 ACL 2026 杰出论文。

变化 04
SFT 不再是"无害的热身"
以前我们默认:SFT 就是把模型调到"能听懂人话",然后 RL 接管,SFT 只是个热身,好坏无所谓。
现在这个假设被推翻了。
PEAR 这篇工作证明了一件反直觉的事:一个"更强的 SFT 检查点",在做完同样的 RL 之后,可能反而更差。
原因是分布错配——SFT 是离线数据训练,RL 是在线采样,两者分布对不上。SFT 阶段学得越"深",偏离 RL 需要的分布就越远。
它的解法是用重要性采样重加权 SFT 损失,AIME-2025 的 pass@8 最高 +14.6%。
BRIDGE 更进一步,直接用双层优化让 SFT 阶段"学会监督 RL"——只把对奖励优化有用的知识传下去,没用的别塞。Qwen2.5-3B 上训得快 44%,性能 +13%。

变化 05
数据质量,是绕不过去的硬约束
这条我放在最后,因为它是这半年最"打脸"的一篇。
此前有工作声称:即使数据 100% 是噪声,RLVR 依然鲁棒,模型照样能学。
2026 年的这篇工作把那些数据集重新严格核验了一遍,发现——所谓"纯噪声"数据集里,至少混进了 16% 的干净数据。
在真正错误的标注上训练,结果是什么?数学基准掉 8–10%,Text2SQL 掉 5–12%。
Dr.GRPO、DAPO、TIS、SAPO、PGFC……这些 SOTA 级别的算法改进,一个都补不回来。
结论很朴素,算法再花哨,也补不回数据质量。高质量数据依然是硬约束。

这半年的变化,本质上是这个领域从"堆资源"走向"拼理解"。
以前是「谁的卡多谁赢」,现在是「谁更理解训练动态谁赢」。
熵怎么变、边界在哪、分布对不对得上、数据干不干净——这些以前没人细看的细节,现在成了胜负手。
对从业者来说,这其实是好消息:理解力的杠杆,第一次超过算力的杠杆。