

编辑 | 李叶霖
审核 | 王紫嫣

今天给大家分享一篇发表在 Nature Communications 上的文章,题目为:“Mol-CADiff: text-conditional molecule generation via causality-aware autoregressive diffusion”。
本文提出了一种面向文本条件分子生成的因果感知自回归扩散框架 Mol-CADiff。该方法将潜空间扩散、自回归生成和因果注意力机制结合起来,通过显式建模文本条件与分子结构之间、以及分子内部不同潜在表示之间的依赖关系,使模型能够根据自然语言描述生成具有特定性质的分子。相比现有文本到分子生成方法,Mol-CADiff并不单纯追求生成结构与参考分子的高度相似,而是更加关注在满足文本条件的同时提高分子的Novelty和Diversity,从而在条件一致性与新化学空间探索之间取得更好的平衡。
背景
利用人工智能根据特定性质要求直接生成分子结构,是近年来药物发现和材料设计中的重要研究方向。传统分子设计通常依赖实验试错、虚拟筛选或者已有化学空间中的搜索,不仅效率有限,而且难以覆盖规模巨大的潜在化学空间。随着深度学习的发展,VAE、自回归模型、Flow模型以及扩散模型等生成方法逐渐被用于分子设计,使模型能够从已有分子数据中学习结构分布,并进一步产生新的候选分子。
与此同时,大语言模型和多模态学习的发展推动了text-to-molecule generation,即直接使用自然语言描述所需的分子性质或结构特征,再由模型生成对应分子。例如,可以输入“The molecule is insoluble in water”,要求模型生成疏水性较强的结构;也可以输入“The molecule is a member of the class of flavones”,要求模型生成具有黄酮类结构特征的分子。MolT5、ChemT5、Mol-Instructions、MolReGPT等工作已经尝试将分子视为一种特殊语言进行建模,而3M-Diffusion则进一步采用latent diffusion连接文本和分子两种模态。
然而,现有方法仍然存在一个核心问题:如何在准确满足文本条件的同时,保证生成结果具有足够的新颖性和多样性。基于语言模型的方法通常能够较好地学习文本与分子之间的对应关系,但容易生成与参考分子高度相似甚至重复的结构,因此虽然Similarity较高,却可能牺牲Novelty和Diversity。另一方面,潜空间扩散模型具有较好的化学空间探索能力,但传统扩散过程通常对整个潜在表示同时进行去噪,没有显式考虑已经生成的分子信息如何影响后续结构生成。
作者认为,分子结构本身具有明显的依赖关系,不同局部结构并不是相互独立存在的,已经形成的结构会限制后续可以出现的原子连接和结构模式。因此,如果能够在扩散模型中进一步加入类似语言模型的自回归依赖,让当前分子片段的生成受到此前已生成结构的约束,就有可能同时获得扩散模型的探索能力和自回归模型的结构依赖建模能力。基于这一思路,作者提出了Mol-CADiff。
方法
Mol-CADiff:因果感知的自回归扩散分子生成框架

图1:Mol-CADiff整体框架
Mol-CADiff的整体思路可以概括为:先将文本和分子映射到潜在空间,再在分子潜空间中进行由文本条件控制的自回归扩散生成,最终将生成的潜在表示解码为分子图。
首先,对于分子结构,作者使用GIN作为Graph Encoder,将分子图G编码为潜在表示Lg;对于文本描述,则使用SciBERT作为Text Encoder,将自然语言条件C编码为文本潜在表示Lc。随后利用对比学习对齐文本和分子的潜在空间,使匹配的分子-文本pair具有更加接近的表示,而不匹配的pair彼此远离。与此同时,作者使用HierVAE作为Graph Decoder,使分子潜在表示能够重新恢复成完整分子图。这样一来,后续扩散过程就不需要直接在离散的原子和化学键上进行,而可以在更加紧凑、连续的molecular latent space中进行。
获得分子的干净潜在表示Lg0后,模型首先采用标准扩散过程逐步加入Gaussian noise,使其得到不同时间步下的noisy latent Lgt。训练过程中,模型学习相反的去噪过程,即从受到噪声扰动的潜在表示逐渐恢复干净的分子latent。最终在推理阶段,可以从随机噪声出发,通过多步去噪得到新的分子潜在表示,再经过Graph Decoder生成最终分子结构。
Mol-CADiff与普通latent diffusion最大的区别在于,作者没有让整个分子latent完全同时生成,而是将分子潜在表示划分成多个autoregressive step。假设一个分子latent被划分为若干片段,那么模型在生成当前片段时,不仅能够使用文本条件,还能够参考此前已经生成完成的clean molecular latent,但不能提前看到未来尚未生成的部分。换句话说,分子生成不再是一次性从噪声恢复整个结构,而是按照一定顺序逐步完成,不同片段之间形成类似语言模型next-token prediction的依赖关系,只不过每一个token或片段内部仍然通过diffusion完成去噪生成。
Causal Attention控制分子生成中的信息流
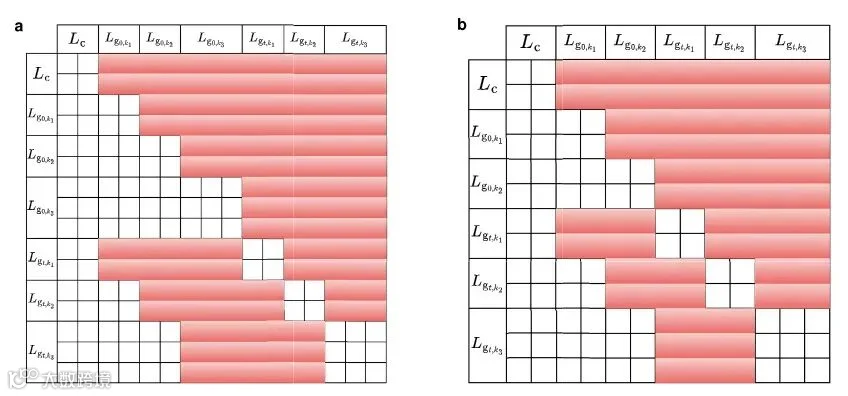
图2:Mol-CADiff中的causal attention mask
为了实现上述自回归生成过程,Mol-CADiff设计了causal attention机制。在每一个autoregressive step中,模型同时接收三种信息:文本条件Lc、此前autoregressive steps中已经恢复完成的clean molecular latent,以及当前正在去噪的noisy molecular latent。
Causal mask规定了不同token之间允许访问的信息范围。文本条件始终可以被所有分子token看到,因此能够作为整个生成过程的全局约束;此前已经生成完成的clean tokens可以用于指导当前片段的去噪;而当前分子token不能访问未来尚未生成的latent,从而避免训练过程中出现信息泄漏。
因此,当前分子片段的生成实际上由三类信息共同决定:
文本描述 + 已经生成的分子信息 + 当前的noisy latent → 当前的clean molecular latent
这种设计使模型能够同时捕获跨模态依赖和分子内部依赖:一方面,自然语言决定生成分子应该具有什么性质或结构;另一方面,前面已经生成的分子结构进一步约束后续结构应该如何形成。作者认为,这种方式比单纯对整个latent进行无约束去噪更加适合分子生成。
分子latent中是否真的存在顺序依赖?
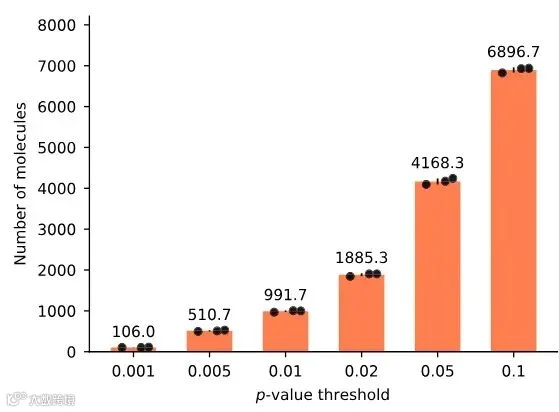
图3:ChEBI-20分子latent中的Granger causal links
为了进一步验证在分子latent中引入causal dependency是否合理,作者首先在ChEBI-20数据集上进行了latent space causality analysis。具体而言,他们将每个分子的latent vector划分为连续的多个group,并采用Granger causality test判断不同latent group之间是否存在预测依赖。
结果显示,即使在较严格的p-value阈值下,仍然存在部分分子具有显著的latent causal links;随着显著性阈值逐渐放宽,具有显著预测关系的分子数量持续增加。在p < 0.1时,接近一半的分子至少存在一条显著连接。
作者据此认为,分子latent并不是彼此完全独立的一组表示,不同潜在片段之间存在可以用于预测后续结构的信息,因此使用causal attention约束扩散过程具有一定合理性。需要说明的是,这里的causality主要指Granger predictive dependency以及attention中的causal masking,并不等同于真实化学体系中的物理因果关系。
实验结果
Mol-CADiff在四个条件分子生成数据集上取得最佳综合性能
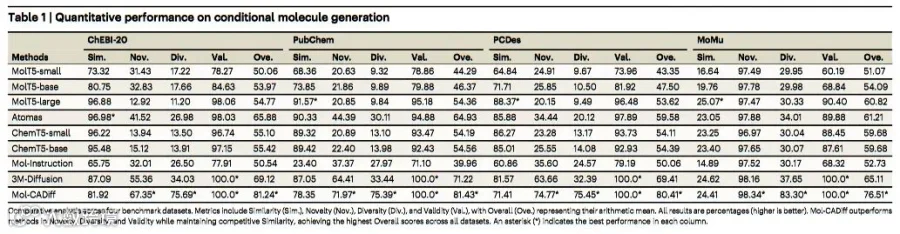
表1:Conditional molecule generation performance
作者在ChEBI-20、PubChem、PCDes和MoMu四个文本-分子数据集上评估Mol-CADiff,并与MolT5、ChemT5、Mol-Instruction、Atomas和3M-Diffusion等方法进行比较。为了与已有工作保持一致,实验主要针对原子数少于30的小分子进行。
条件分子生成主要使用Similarity、Novelty、Diversity和Validity四个指标。Similarity衡量生成分子与参考分子的结构一致程度,Novelty衡量生成结构是否区别于参考分子,Diversity评价同一条件下不同生成分子之间的差异,而Validity表示生成结果是否为有效化学结构。作者进一步将四项指标取平均得到Overall score,用于评价模型综合性能。
实验结果显示,Mol-CADiff在四个数据集上均取得了最高Overall score。在ChEBI-20上,Mol-CADiff的Similarity为81.92%,Novelty为67.35%,Diversity为75.69%,Validity达到100%,Overall为81.24%。作为对比,3M-Diffusion的Similarity为87.09%,高于Mol-CADiff,但Novelty仅为55.36%,Diversity仅为34.03%,Overall为69.12%。
类似现象同样出现在PubChem和PCDes中。Mol-CADiff并不一定获得最高Similarity,但在Novelty和Diversity上具有明显优势。这说明该模型并不是尽可能复制与ground truth接近的分子,而是在满足文本条件的基础上探索更加丰富的新结构。对于de novo molecule generation而言,这一点尤为重要,因为真正有价值的生成模型并不是反复恢复已知分子,而是需要探索满足设计要求但此前尚未出现的化学空间。
文本描述能够有效指导分子性质和结构生成

图4:不同文本条件下Mol-CADiff、MolT5-large和3M-Diffusion的生成结果
作者进一步通过两个典型prompt比较不同模型的条件生成能力。
第一个条件是“This molecule is insoluble in water”。由于水中不溶通常对应较高的疏水性,作者使用logP评价生成结果。Mol-CADiff生成的多个分子具有较高logP,其中最高达到7.51,而MolT5-large多次生成几乎相同的分子,表现出较明显的结构重复现象。
第二个条件是“The molecule is a member of the class of flavones”。在该任务中,Mol-CADiff生成的多个分子均保持了较明显的flavone结构特征,与reference molecule的Similarity可达到0.88–0.93。相比之下,部分基线模型生成结构与参考黄酮骨架的偏离更加明显。
这些案例说明,Mol-CADiff不仅能够根据文本生成化学有效结构,还能够将自然语言中的性质描述和结构类别信息转化为具体的分子结构约束。
Intervention实验验证文本条件真正影响了生成轨迹
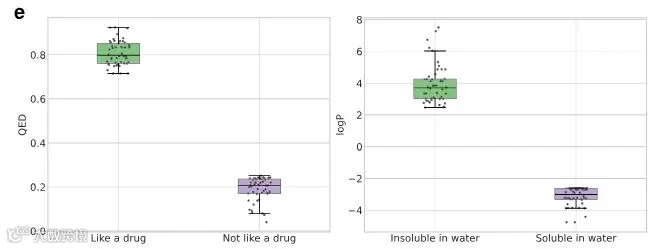
图5:不同文本条件对QED和logP的影响
为了进一步判断模型是否真正理解文本,而不是简单利用训练集中的相似结构,作者设计了相互对立的文本条件进行干预实验。
在drug-likeness实验中,作者分别使用“The molecule is like a drug”和“The molecule is not like a drug”两个prompt生成分子,并计算QED。结果显示,“like a drug”条件下生成分子的QED整体明显更高,而“not like a drug”条件下QED显著降低。
类似地,在solubility实验中,作者分别输入“The molecule is insoluble in water”和“The molecule is soluble in water”。结果显示,insoluble条件下生成分子的logP明显更高,而soluble条件下logP明显降低。
这些结果说明,文本条件能够系统性地改变分子生成方向,而且这种变化与基本化学规律一致。因此,Mol-CADiff中的文本并不是简单作为一个附加embedding输入,而是真正参与并控制了整个分子去噪和生成过程。
生成分子的药物相关性质与真实分子保持一致

图6:生成分子与参考分子的QED、SA、logP及EGFR结构相似度分布
仅仅具有较高Novelty和Diversity并不足以说明生成分子具有实际价值。如果模型通过生成大量不合理结构获得很高的新颖性,这种结果对于药物发现并没有意义。因此作者进一步分析了生成分子的药物相关性质。
作者使用RDKit计算生成分子和reference molecules的QED、Synthetic Accessibility和logP,并比较其整体分布。结果显示,Mol-CADiff生成分子的三类性质分布与真实分子总体保持较高一致性,其中SA score分布尤其接近。这表明模型在探索新结构的同时,并没有明显偏离真实小分子的基本理化性质空间。
作者还以EGFR为例进行了ligand-based target-relevant validation。他们分别计算Mol-CADiff生成分子和ChEBI-20真实分子与已知EGFR inhibitors之间的ECFP4 Tanimoto similarity。两组相似度分布基本重叠,说明Mol-CADiff生成的分子保留了与参考数据相似的target-relevant chemical patterns。不过,这一实验本质上仍然属于基于fingerprint的计算验证,并不能直接说明生成分子具有真实EGFR抑制活性。
Mol-CADiff同时能够进行无条件分子生成

表2:Unconditional molecule generation performance
除了text-conditioned generation之外,Mol-CADiff还可以通过移除文本condition实现unconditional molecule generation。作者在ChEBI-20和PubChem上与VAE、HierVAE、PS-VAE、DiGress、GruM和3M-Diffusion等方法进行了比较。
在ChEBI-20上,Mol-CADiff的Uniqueness达到85.90%,Novelty达到79.11%,Validity达到100%,Overall为86.83%;在PubChem上,其Uniqueness为87.79%,Novelty为83.23%,Validity同样达到100%,Overall为87.57%。在两个数据集上,Mol-CADiff均获得最高Overall performance。
这些结果说明,Mol-CADiff的causality-aware autoregressive diffusion并不只是一个依赖文本条件的特殊结构,其本身也可以作为通用分子生成框架使用。
消融实验验证模型关键设计

图7:Mol-CADiff消融实验和参数分析
作者进一步分析了autoregressive step decay、attention block数量、sampling timestep以及partial clean latent等设计对模型性能的影响。
在autoregressive step decay实验中,Novelty和Diversity在中等decay设置下表现较好,说明每个autoregressive step过大或过小都可能影响生成结构的平衡。对于attention block数量,增加网络深度能够提高Similarity,但Novelty和Diversity会出现一定下降,最终作者选择8个attention blocks作为默认设置。
对于sampling timestep,作者测试了25、50、75和100步。Similarity在50步时达到最高,而随着sampling step继续增加,Novelty和Diversity总体继续上升,但Similarity略有下降。因此,作者最终选择50 steps作为conditional generation中的默认设置,以平衡结构一致性、创新性和计算成本。
作者还比较了full clean graph latent与partial clean graph latent。结果表明,仅输入前面autoregressive steps已经完成的clean latent,就可以获得与完整latent相当甚至更好的综合性能,同时降低token处理量。这进一步支持了Mol-CADiff的核心假设:当前结构的生成可以依赖已经生成的分子信息,而没有必要访问未来结构。
总体而言,实验结果表明,Mol-CADiff通过在latent diffusion中引入autoregressive causal dependency,在保持分子化学有效性和文本条件一致性的同时,显著提高了生成结构的Novelty和Diversity。相比单纯追求ground-truth similarity的文本到分子方法,该模型更倾向于在符合条件的前提下探索新的化学空间。
总结
本文提出了Mol-CADiff,一种面向文本条件分子生成的causality-aware autoregressive diffusion框架。其核心创新在于将传统latent diffusion进一步改造成具有自回归依赖的生成过程,使当前molecular latent在去噪时能够同时利用文本条件、此前已经生成的clean molecular tokens以及当前的noisy tokens,并通过causal attention mask阻止模型访问未来信息。
在ChEBI-20、PubChem、PCDes和MoMu四个文本条件分子生成数据集上,Mol-CADiff均取得了最高的Overall performance,尤其在Novelty和Diversity方面表现突出,同时保持100%的Validity。针对drug-likeness和solubility等条件的干预实验进一步证明,文本信息能够按照符合化学规律的方向调控生成分子的QED和logP,说明模型能够真正利用自然语言条件控制分子生成。
Mol-CADiff的一个重要价值在于,它不再将“尽可能接近参考分子”作为唯一目标,而是尝试在condition fidelity和chemical space exploration之间寻找平衡。这与实际药物发现中的需求更加一致,因为分子生成真正希望得到的是满足设计要求、化学合理,同时又不同于已知结构的新候选物。
该方法目前仍存在一定局限。首先,论文主要研究原子数少于30的小分子,其对大型分子、宏环、肽类或其他复杂体系的泛化能力尚不明确;其次,生成结构虽然具有较好的SA等计算指标,但模型并不能直接给出可执行的逆合成路线;此外,EGFR相关验证仍然停留在fingerprint similarity层面,尚未通过docking、分子动力学或实验活性进一步验证。未来如果能够进一步融合3D结构约束、逆合成预测、多目标优化以及实验反馈,Mol-CADiff有望进一步向真实药物设计流程靠近。
论文链接:https://doi.org/10.1038/s41467-026-75702-5
代码链接:https://doi.org/10.5281/zenodo.21108095

扫描二维码获取
更多精彩
AI in Graph
本公众号主要介绍应用于图、知识图谱的人工智能算法和研究进展,及其在生物信息、医学健康领域的应用。欢迎关注本公众号获取领域最新文献解读。

点个在看+赞支持一下