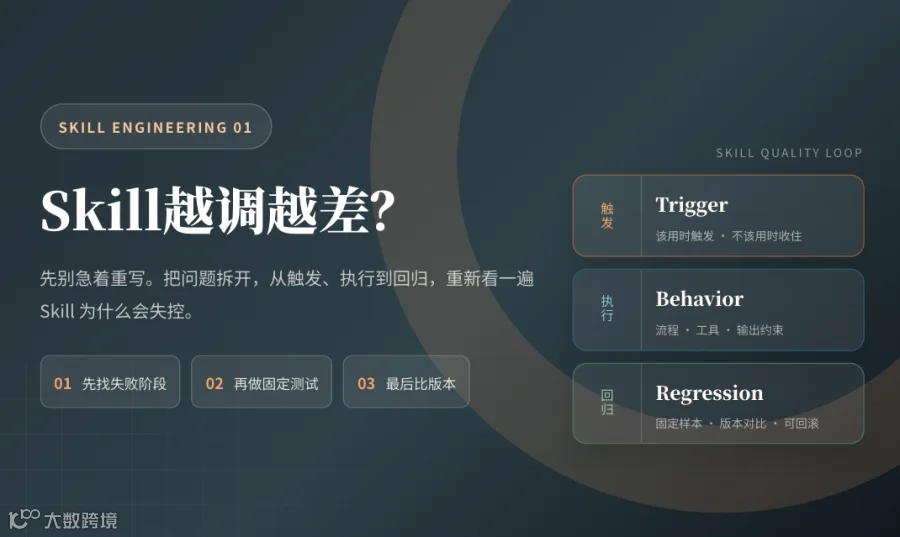

如果你写过 Agent Skill,大概率遇到过这种情况:一开始只是想补充一个边界条件,后来又加了输出格式、异常处理、工具限制、引用规范、风格要求。看起来越来越完整,实际运行却越来越拧巴。
它开始在该触发的时候不触发,在不该触发的时候乱触发;有时照着流程走,有时直接跳到最终答案;有时输出很漂亮,但中间根本没读该读的资料。你继续补规则,它继续长歪。最后你怀疑是模型不稳定,或者怀疑 Skill 这种东西本身就不可维护。
我的判断刚好相反:Skill 不是不能维护,而是很多人把它当成一段可以无限追加的 Prompt 在维护。
Skill 不是 Prompt 的高级写法,而是 Agent 的可版本化行为规范。
既然是行为规范,就不能只靠“看起来更详细”来判断质量。它需要固定样本、失败分类、版本记录和回归测试。否则每一次修改都像在重新抽签,偶尔抽到一个好结果,就误以为方向对了。
一、越调越差的根因不是“写得不够多”
很多 Skill 变差,不是因为约束少,而是因为约束之间开始互相打架。
比如你先写:“生成测试方案前,必须先分析需求。”后来又补一句:“用户要求直接输出时,不要啰嗦。”再后来又加:“输出必须包含背景、风险、步骤、结论。”这三句话单独看都没问题,放在一起就开始制造冲突。
模型会面临一个隐含选择:到底是先分析,还是少啰嗦?到底要完整,还是要直接?到底按流程走,还是听用户的即时指令?如果 Skill 里没有优先级,模型只能现场猜。
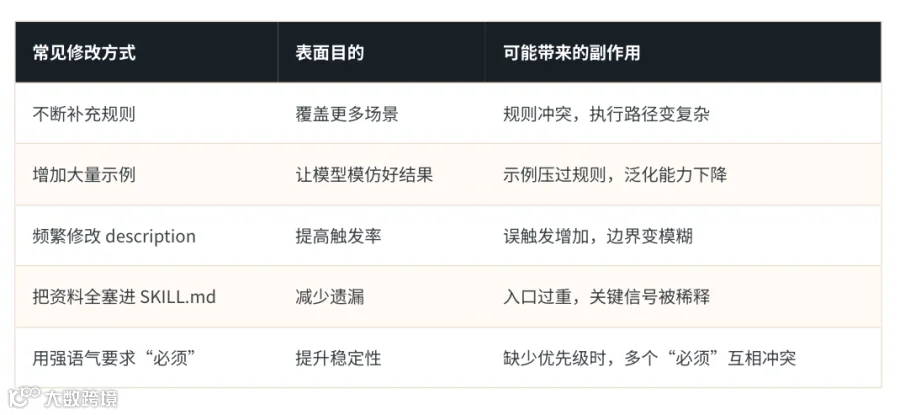
所以,Skill 调试的第一步不是继续加字,而是先问:这次失败到底发生在哪个阶段?
二、Skill 失败至少分成五层
很多人调 Skill 时,只看最终结果。最终结果不好,就回去改整篇 Skill。这个动作太粗了,因为最终结果只是最后一层表现,前面任何一层出错,都会让结果变差。
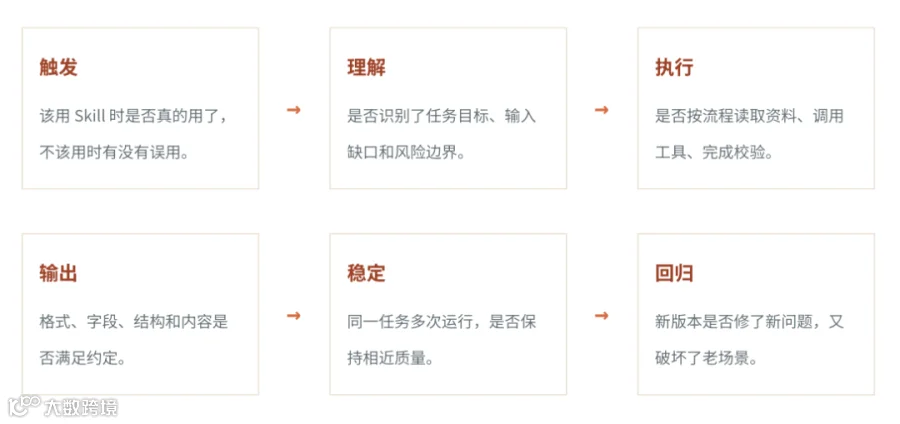
举个例子:你写了一个“测试用例生成 Skill”。用户输入需求后,结果缺少异常场景。这个问题看起来是“输出不完整”,但背后可能有三种完全不同的原因。
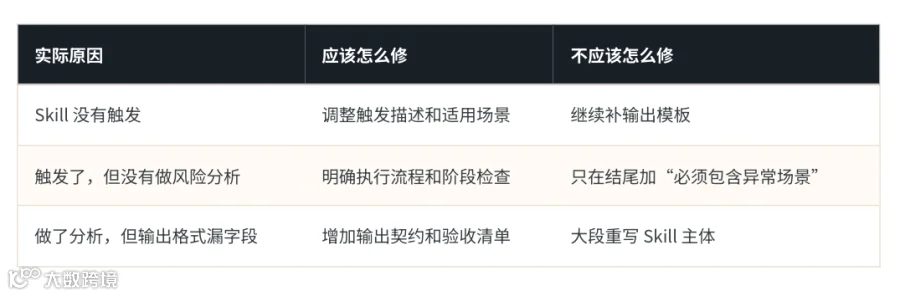
同一个表象,修法完全不同。如果不先分类,调试就会变成一种很努力的破坏。
三、为什么重新生成的 Skill 反而更好
这是一个很值得拆开的现象。很多人会得出结论:既然新生成的更好,那旧的调试都白费了。其实不一定。
新 Skill 变好,常见原因不是它更“聪明”,而是它更干净。它可能无意中删除了旧版本里的冲突规则、重复要求、过多例外和不必要的上下文噪声。

但这并不代表“推倒重来”就是最佳策略。新 Skill 只是帮你暴露了一个事实:旧版本已经失去结构了。真正应该做的,是把新旧版本拿来对比,看看新版本到底删掉了什么、合并了什么、简化了什么。
如果没有版本记录,这个发现就留不下来。下一次你继续调,新 Skill 也会慢慢变成另一个旧 Skill。
四、没有测试基线,就没有真正的优化
Skill 调试最常见的误区,是拿不同任务比较不同版本。
今天拿 A 需求测试,效果不好,于是改了 Skill。明天拿 B 需求测试,效果变好了,于是觉得修改有效。但 A 和 B 本来难度不同、输入完整度不同、风险点不同,这个对比没有意义。
真正的基线至少要回答三个问题:
-
固定用哪些任务测试? -
每个任务预期 Skill 做什么? -
什么情况算通过,什么情况算失败?
起步阶段不用复杂。先准备 15 条任务就够了:
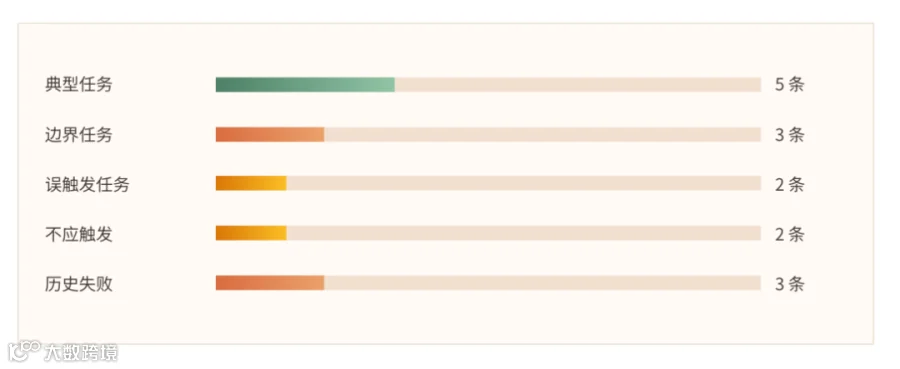
每条任务不需要写得很复杂,但必须有预期。比如:
{
  "id": "case-001","query": "请根据这份需求生成接口测试用例","should_trigger": true,"must_include": ["测试范围","前置条件","正常场景","异常场景"  ],"must_not_do": ["直接修改代码","跳过需求分析"  ]}
有了这样的基线,你才能比较 v0.1 和 v0.2:到底是触发更准了,还是输出更完整了?到底是新场景好了,还是旧场景退化了?
五、调试 Skill,要先记录问题而不是先修改
很多 Skill 被改坏,是因为每次失败后都立刻动手改。更稳的做法是先记录问题,让失败变成可分析的数据。

这张表看起来简单,但它会强迫你从“我感觉它不行”转向“它在哪个版本、哪个输入、哪个阶段失败了”。这一步很关键。
六、调试时最该避免的三个动作
1. 不要一次改太多地方
如果你同时改了触发描述、执行步骤、输出模板和示例,结果变好或变坏都很难解释。正确做法是一次只验证一个假设。
假设:Skill 没有触发,是因为 description 太泛。
修改:只调整 description。
验证:运行触发测试集和误触发测试集。
结论:触发率提升,但误触发是否增加,需要同时记录。
2. 不要把所有失败都写进主文件
历史失败很有价值,但不应该全部变成 SKILL.md 里的正文规则。否则入口文件会越来越重。
更好的方式是:高频、稳定、通用的规则放进主文件;低频、长篇、领域相关的内容放进 references/;可以确定性检查的内容交给 scripts/。
3. 不要只保留最新版本
最新版本不一定是最佳版本。Skill 调试应该保留可以回退的稳定点。
versions/
├── v0.1-initial/
├── v0.2-add-output-check/
├── v0.3-change-trigger/
└── best/
有了版本,调试才会变成实验;没有版本,调试就是覆盖。
七、一个最小可用的检查清单
如果你现在手上已经有一个越调越差的 Skill,不建议立刻重写。可以先按这张清单做一次盘点。

八、第一篇先给结论
Skill 越调越差,通常不是单点问题,而是工程过程问题。
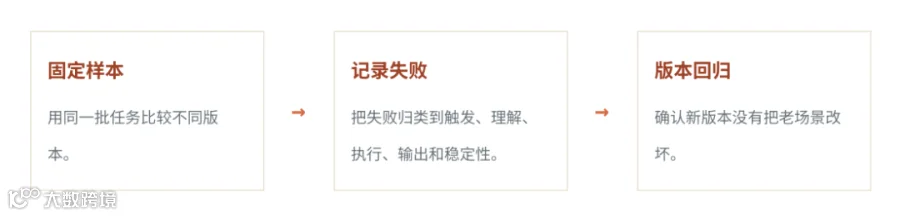
如果没有测试基线,你无法判断修改是优化还是碰巧。如果没有失败分类,你不知道应该改触发、改流程、改输出还是改资料组织。如果没有版本记录,任何一次修改都可能把之前有效的经验覆盖掉。
所以,Skill 工程化的第一步不是写一个更长的 SKILL.md,而是建立一套最小闭环:
下一篇再聊一个更具体的问题:一个规范化的 Skill 到底应该长什么样?哪些内容应该放进 SKILL.md,哪些内容应该拆到 references/、scripts/ 和模板资产里。
最后留一句话: