

用一句人话概括:Mechanize给“AI程序员”建训练场。
它不直接给普通用户卖聊天机器人,也不靠一款编程助手收费。它服务的是训练大模型的实验室:把真实的软件工作做成一套套可以反复练习、自动打分的任务。
可以把它理解成AI领域的“驾校考场”。自动驾驶汽车需要在不同道路、天气和突发状况里练习;AI程序员也要进入陌生代码库,面对需求、报错和部署问题。Mechanize负责搭场景、定规则、看过程、判结果。

Mechanize由Tamay Besiroglu、Ege Erdil和Matthew Barnett创办。三人都曾参与AI研究机构Epoch AI,其中Besiroglu还是Epoch AI的联合创始人。

Mechanize做三件事:给AI出实战题、搭考场、判卷。
比如,题目可以是“在这套陌生系统里增加支付功能”。AI拿到完整代码和开发工具后,要自己找入口、修改文件、运行命令、处理报错,最后把功能真正跑起来。整个过程可能持续几小时,远比补全几行代码复杂。
任务结束后,自动评分程序会检查:功能是否可用、测试能否通过、有没有破坏原来的系统。分数和失败记录再送回模型训练,让AI下一次少犯同类错误。
一套训练任务,实际是这样运转的
|
|
出题
|
|
|
开工
|
|
|
验收
|
|
|
回炉
|
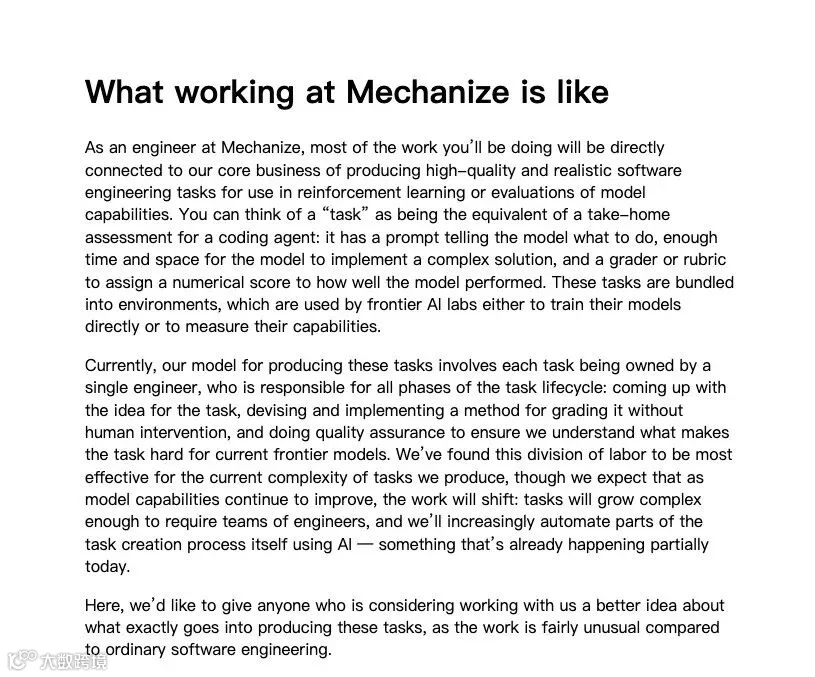
Mechanize的产品,核心就是这些任务和背后的考场。按照公司公开的工作说明,一名工程师会从头负责一道题:先找出模型最容易卡住的地方,再设计任务、写自动评分程序,最后反复试跑。
一道题大约要做一周,最费时间的是验题。工程师要确认AI失败是因为能力不够,不能是题目含糊、工具坏了,或者评分规则留了漏洞。这些看似琐碎的判断,决定训练出来的模型是真会干活,还是只会刷分。
它发布的GBA Eval,把这门生意展示得很具体:给不同AI模型24小时,让它们从零写出一个Game Boy Advance游戏机模拟器。AI要用Rust写代码、编译成网页可运行的版本,还要让游戏真的能玩。
页面上的折线记录各个模型在24小时里的得分变化;下面直接放出它们做出来的游戏画面。哪一个模型只是“写得像”,哪一个真的跑通,一眼就能看到。
页面上的折线记录各个模型在24小时里的得分变化;下面直接放出它们做出来的游戏画面。哪一个模型只是“写得像”,哪一个真的跑通,一眼就能看到。

这就是Mechanize的价值:它把“AI到底能不能独立完成工作”变成可训练、可观察、可比较的过程。模型公司得到的不只是一张排行榜,还能拿到失败发生在哪里、下一轮该练什么。
它先做软件工程,是因为结果容易验收:代码能不能编译、测试能不能通过、应用有没有部署成功,都有明确答案。长期看,Mechanize想把这套方法扩展到电脑操作、长时间任务和多人协作,让AI逐步接手更多办公室工作。
为什么能进入15亿美元级谈判
Mechanize官网写得很清楚:公司大约35人。2026年4月,它只完成了一轮910万美元融资。几个月后,交易讨论却到了15亿美元级别。
这个价格差,无法用员工数量或已融资金额解释。Google看的是三项可以直接进入模型研发的资产。
|
|
人被AI放大
|
|
|
失败会留下来
|
|
|
环境可以持续生产
|
在大公司,设计任务、训练模型和检查结果可能分属不同部门。Mechanize把这几步放在很近的位置。哪里出了问题,修改可以马上回到下一轮实验。
Google当然能自己搭建训练环境。难点是先走过同样的弯路:哪些任务看着难却没有训练价值,哪些自动评分器会被模型钻空子,哪些失败值得继续投入。
这些判断没有完整说明书。把原团队带进来,比移交一套代码省时间。

类似的团队交易,国内也已经出现。
先看硅谷。大厂已经多次使用“技术许可加团队加入”的结构。
|
|
|
|
|
|
|
|
|
国内公开案例中,和Mechanize结构最接近的是零一万物与阿里云。
它们有一个共同点:买方都没有从社会招聘重新拼团队。现成的负责人、研究员和工程能力被一次性接入。
AI人才战的最小单位,
正在从“一个人”变成“一支队伍”。
如果您遇到消费AI方面的问题与困惑,欢迎各位与我们一起学习交流!

-END-
📍关注消费AI进化体|赋能组织AI转型
我们聚焦大消费行业(餐饮、零售、快消)的AI转型升级,坚信人在AI技术变革下起关键作用,以最精炼的方式帮助管理者掌握推动AI组织团队升级的框架、方法、工具,从而更好推动 AI 在团队中的真实落地,提升团队效能和组织上限。

业务合作:贝老师13392164760(微信同号)

媒体·投资·培训·峰会