作者 | 张建imest
来源 | 至顶AI实验室
2026年9月的一个清晨,一份来自SemiAnalysis的报告悄悄上线。里面没有炸裂的新芯片发布,也没有任何耸动的标题,只有一堆密密麻麻的性能对比图和成本曲线。但如果你在AI基础设施圈子里泡过一段时间,你会知道这份报告问的是一个已经被讨论了十几年、却始终没有确切答案的问题。
谷歌用TPU支撑起了搜索、广告、YouTube和一代又一代的Gemini模型,这件事本身从来不是秘密。真正让人好奇的是另一件事,如果把TPU这套体系搬到谷歌之外,交给一个普通客户,用一个大家都熟悉的开源推理引擎去跑一个开源模型,它还能不能打得过英伟达。
这个问题在过去很长时间里几乎无解,原因很简单。TPU的软件栈长期只服务于谷歌内部,外部开发者想用好TPU,几乎等于要重新学一套完全陌生的工具链。而这次的报告,第一次拿出了第三方视角下、用真实开源推理引擎跑出来的TPUv7 Ironwood对比数据。
一场十年悬而未决的较量:TPU到底能不能打
在这份报告发布之前,业内对TPU外部化这件事的默认预期是悲观的。
原因是谷歌此前一直依赖一套叫TorchAX的翻译层,把用PyTorch写的推理引擎硬生生转换成JAX能执行的代码。这套方案能跑,但每多一层翻译,就多一层性能损耗和调试黑箱。业内普遍认为,TPU在训练场景里表现出色,但要靠外部软件栈去挑战英伟达在推理侧的统治地位,还差得很远。
这份报告给出的答案和这个预期正好相反。在拿Qwen3.5 397B这个模型做同口径测试时,在用户交互速度为每秒100个token的场景下,Ironwood的成本约为每百万token 0.181美元,B200是0.222美元,B300是0.276美元。换算下来,比B200便宜大约19%,比B300便宜大约34%,而生成速度完全一致。
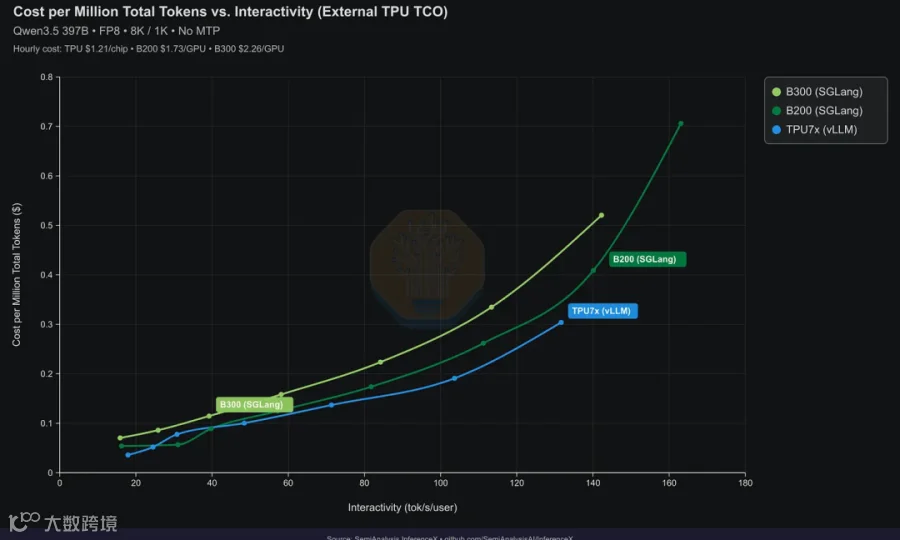

如果只看这一个数字可能还不够有冲击力。报告里还给出了另一个角度的对比,在并发数为256、用谷歌内部TCO口径计算时,TPU的每美元token产出优势扩大到比B200高76.7%,比B300高130.2%。
Ironwood:谷歌第七代TPU的代号,也是这次对比测试里TPU一方的主角。
TCO:全称Total Cost of Ownership,指的是购买、部署、运维一套硬件的全部成本,而不只是采购价。
这里要澄清一件容易被误读的事。这些数字不代表TPU在原始算力上碾压了英伟达的芯片。事实上报告里明确写到,在大部分原始性能曲线上,TPU并不比英伟达GPU更快,在并发数为20时,Ironwood的吞吐量是每芯片每秒9364个token,B200是8903,B300是8925,只领先大约5%。
真正拉开差距的是价格。
把差不多的性能除以更低的小时租用成本,才得到了前面那50%到96%的每美元token优势。这也是为什么报告里特意强调,买TPU的人真正在意的不是跑分谁快,而是同样一笔钱能换来多少收入。
如果你觉得这套逻辑有点绕,可以想象你在纠结买一辆车用来跑网约车。A车百公里加速比B车快两秒,但A车百公里油耗高出一大截,长期租用成本也贵得多。作为网约车司机,你真正关心的从来不是谁零百加速更快,而是跑满一年之后账户里剩下多少钱。如果你只盯着加速数据买了A车,你会发现自己每个月都在往油箱里倒钱,却没有换来更多订单收入。这正是这份报告反复强调性能功耗比而不是单纯跑分的原因,如果只比算力峰值,TPU这次测试的故事根本讲不下去。
不过这个优势也不是没有代价。在高并发场景下,TPU的延迟表现要弱一些。并发256时,TPU的平均首字延迟是5.41秒,B200是3.75秒,B300是2.40秒。这说明前面那些漂亮的性价比数字,是有特定延迟区间的前提条件的,不是在所有场景下都成立。
从翻译层到原生支持:TorchAX为什么不够用了
要理解这次测试结果是怎么跑出来的,得先搞清楚谷歌这套推理软件栈经历了什么。
早期谷歌想让开源推理引擎vLLM和SGLang跑在TPU上,用的办法是TorchAX。开发者照常用PyTorch写模型,但真正执行计算的是JAX,TorchAX在中间充当翻译官,把PyTorch的张量操作实时转换成JAX的操作。
TorchAX:谷歌早期用来让PyTorch代码在TPU上通过JAX执行的翻译层,本质上是一层兼容适配器。
JAX:谷歌自研的一套数值计算框架,长期以来是TPU上性能最成熟的软件生态。
这套方案当时是务实的选择,因为JAX在TPU上的底层优化已经很成熟,谷歌不想为了兼容PyTorch重写一遍所有内核。但翻译层天然有代价,任何一次张量操作的拦截和转换,都会引入额外的开销和潜在的兼容性坑。报告里提到,正是这些翻译层带来的一堆问题,推动谷歌和PyTorch、vLLM、SGLang社区一起搞出了新方案,叫TorchTPU。
TorchTPU的思路是把框架边界直接挪进PyTorch内部。它让开发者拿到的就是一个普通的torch.Tensor,只是运行设备写成了"tpu",不再是一个包着JAX数组的壳子。PyTorch的调度器直接把底层操作路由到TPU后端,编译路径下由TorchDynamo和AOTAutograd生成计算图,再交给XLA编译成TPU可执行代码。
XLA:谷歌的深度学习编译器,负责把计算图编译成TPU真正能跑的机器指令。
Pallas:专门为TPU写的底层内核语言,用来实现性能最关键的算子。
这个变化听起来像是纯粹的工程重构,但它解决的是一个实际的效率矛盾。翻译层越薄,中间损耗越小,但完全抛弃翻译层去重写所有算子又不现实。TorchTPU给出的答案是把框架层和内核层拆开,框架层原生化,内核层继续复用Pallas和JAX已经写好的成熟实现。
这就像搬家时你面对两个选择,一是把所有家具都拆开重新买新的,保证风格统一但极其费钱费时,二是继续用原来的沙发和柜子,只是换一辆更合适的卡车来搬运。TorchTPU选的是后一种思路,外壳换成PyTorch原生的搬运方式,但里面那些精心打磨过的内核家具原封不动地搬过去。如果谷歌选择了第一条路,把所有Pallas内核推倒重写,报告里描述的那几百个PR和几百个工程小时可能要再翻上好几倍,TPU的外部化进度也不会是现在这个"全速前进"的状态。
截至这份报告发布时,TorchTPU还处于内测阶段,计划在10月的PyTorch大会上开源。
优化深潜:为了挤出每一个百分点,工程师做了什么
Qwen3.5-397B作为第一个正式上线基准测试的模型,背后是数百个PR和数百小时的工程投入。这一节把报告里公开的具体优化手段拆开讲。
第一类优化和注意力机制的并行方式有关。Qwen3.5用的是GQA注意力,32个查询头只对应2个共享的KV头。在八卡张量并行下,查询头可以均匀分到8张卡上,但KV头没法整除,每个KV头要被4张卡共用。谷歌引入了DP attention,把每张卡负责的请求拆开,而不是把每个请求的注意力计算都摊到全部8张卡上,这样每张卡只需要保留自己那部分请求的KV缓存,不用来回复制。
DP attention:一种让不同芯片处理不同请求子集,而不是让每个请求都摊到所有芯片上计算注意力的并行方式。
MoE:全称Mixture of Experts,混合专家模型,指模型内部由多个专家子网络组成,每次只激活其中一部分。
通信层面也做了大量优化。谷歌把原本分开的两次数据收集操作合并成一次,在DeepSeek-V3的测算里,单层节省了大约80微秒,58层叠加起来,单次前向传播就能省下4.64毫秒。这个数字单看很小,但要知道大模型推理里每一次生成一个token都要走一遍这个流程,积少成多之后就是实打实的吞吐提升。
在专家路由环节,报告描述了一个很直观的矛盾。混合专家模型每次只激活一小部分专家,但不同专家分到的token数量并不均匀,这些参差不齐的数据要重新整理成TPU矩阵单元能高效处理的规整形状。团队把这部分数据搬运工作转移到SparseCore上处理,让TensorCore专心做矩阵乘法,报告里给出的数字是吞吐提升12%。
SparseCore:TPU芯片上专门处理不规则数据搬运和稀疏运算的协处理单元,和负责矩阵乘法的TensorCore分工不同。
TensorCore:TPU上负责密集矩阵运算的核心计算单元。
还有一类优化专门针对低并发场景。InferenceX的测试场景恰好卡在只有4到8个请求同时在跑的区间,这时候如果还用为几百个并发请求调优的配置,编译出来的计算形状会大得离谱,充斥着大量无意义的填充数据。团队针对这个场景做了专门的分桶调优,并发数为4时,8k1k场景吞吐提升13.3%,1k1k场景提升15.5%。
硬件的脾气:为什么模型形状会直接决定利润
这一节要讲的是这份报告里最容易被普通读者忽略、却可能是影响最深远的一个发现,TPU对模型的内部形状极其敏感,敏感到会直接决定一个模型能不能赚钱。
TPU真正做矩阵乘法的部件叫MXU,是一个二维的脉动阵列,从TPU v6e开始,这个阵列从128x128扩大到256x256,单个周期能处理的乘加运算数量翻了四倍。听起来阵列越大性能越强,但报告里点出了一个反直觉的代价,阵列越大,塞满它的门槛也越高。
MXU:Matrix Multiply Unit的缩写,是TPU芯片里真正执行矩阵乘法的硬件单元。
如果一个矩阵的某个维度小于阵列的边长,编译器会自动把它填充到256,多出来的部分全部乘以零,白白占用一个计算周期却什么都没算出来。报告里举了Llama 3 8B的例子,它的注意力头维度是128,正好是Ironwood这块256宽阵列的一半,这就把两个注意力矩阵乘法的利用率硬生生锁死在50%的上限,不是因为代码写得不好,而是形状天生就吃了一半的亏。
这个矛盾在GPU上几乎不存在。GPU的矩阵核心处理的是小瓦片,头维度是64还是128对H100或B200来说差别很小,都能跑到接近峰值。这意味着模型研究者过去在设计头维度、专家宽度这些超参数时,完全可以只考虑训练效果,不用管硬件形状。但放到TPU的256宽阵列上,头维度64直接把利用率砍到25%,gpt-oss就是64,DeepSeek的MLA把维度拆成128加64拼成192,这个数字既不是2的整数次幂,对任何宽阵列都不友好。
架构选择过去可以被当成纯粹的超参数来调,放到TPU上却变成了直接税在吃掉利润。
这就像你开了一家做定制家具的工坊,新买了一台功率翻倍的巨型切割机,理论上效率应该大幅提升。可如果客户订单的板材尺寸和机器的最优切割宽度对不上,机器每切一刀都要浪费掉一大截边角料。功率越大的机器,浪费的边角料反而越贵。如果你继续按照老机器时代的下料方式接单,不去调整板材规格,新机器带来的效率提升可能大半都被浪费掉了。TPU工程团队现在面对的正是这个局面,芯片越做越强,但模型形状如果不跟着调整,白白浪费掉的算力也会跟着水涨船高。
这也解释了报告里的一句判断,模型适配TPU的难度和它的受欢迎程度关系不大。形状天生规整的模型只需要几周的调度和调优工作,形状别扭的模型在追平性能之前就得先重新写内核。工程师人手有限,谁先适配谁后适配,某种程度上是被硬件形状而不是模型热度决定的。
芯片之间怎么说话:从环形网络到Boardfly
除了单芯片内部的设计,TPU真正的杀手锏一直被认为是芯片之间的组网方式。
Ironwood延续了从TPU v4开始的三维环面拓扑,每颗芯片直接连接周围6个邻居,最小的组网单元是一个4x4x4的立方体,正好对应一个物理机柜。这套拓扑的关键在于首尾相连的环绕链路,把一条直线的两端接起来变成一个环,最坏情况下的跳数直接从N降到N的一半。
ICI:Inter-Chip Interconnect的缩写,谷歌自研的芯片间高速互联网络,绕开了主机CPU直接让芯片之间交换数据。
报告里用了一个很生动的比方,说这和吃豆人游戏的迷宫是一个道理,屏幕左边走出去会从右边冒出来,地图看起来更大,实际移动距离却更短。如果没有这种环绕设计,一颗芯片想把数据传到拓扑另一端的芯片,可能要经过两倍甚至更多的中转跳数,每多一跳就多一份延迟,成千上万颗芯片协同训练或推理时,这些延迟会层层叠加,最终拖慢整个集群的有效带宽。这也是为什么在NVLink把8卡塞进一个节点之前,模型一旦超出单机容量就必须用流水线并行去拆分层,而TPU的环面网络提前很多年就把这个问题绕开了。
再往后看,谷歌新发布的第八代TPU把训练和推理拆成了两颗独立设计的芯片,用于推理的TPU 8i放弃了环面拓扑,换成了一种叫Boardfly的扁平化高基数网络,网络直径从大约16跳压缩到7跳。
Boardfly:TPU 8i采用的新型网络拓扑,用高基数交换机构成的扁平网络代替了此前的近邻环面网络。
跳数减半意味着尾延迟大幅下降,这一点在多轮对话或者需要频繁跨层路由的智能体场景里格外重要,因为每多一跳延迟都会被后续步骤放大。TPU 8i还把片上互联带宽翻倍到19.2Tb/s,片上SRAM扩大到原来的3倍,专门用来把推理和智能体场景的KV缓存尽量留在芯片内部,减少往返HBM的次数。
核心数据一览
|
|
|
|
|
|---|---|---|---|
|
|
$0.181 |
|
|
|
|
9,364 |
|
|
|
|
|
|
|
|
|
|
|
2.40秒 |
|
|
$0.098 |
|
|
这份报告并非孤立出现。它的上一篇姊妹文章发布于2025年11月,那篇《TPUv7: Google Takes a Swing at the King》第一次系统介绍了Ironwood的芯片设计,为这次的第三方推理测试打下了硬件背景。而报告里也明确交代了谷歌的下一步计划,等TorchTPU在10月正式开源,团队会继续把Kimi K3和GLM5.3这两个开源模型接入同一套优化流程,同时着手把预测解码和分离式推理这两项内部已经成熟多年的技术开放给外部用户。这些都是建立在这份报告基础上、明确写进路线图里的后续工作。
写在后面
读完这份报告,最让我意外的不是TPU比GPU便宜多少,而是那张关于MXU利用率的图。一个模型的注意力头维度选64还是128,这种听起来纯属训练阶段的超参数选择,竟然会在推理阶段直接决定利润率的上限。这说明模型设计和硬件设计之间的耦合,比大多数人想象得更紧。过去大家习惯把模型架构和硬件当成两个独立的话题分开讨论,这份报告提醒我们,至少在TPU这套系统上,二者早就绑在了一起。
另一个让我反复琢磨的细节,是谷歌用光交换机重新布线来应对故障芯片这件事。传统数据中心出了硬件故障,技术员要跑到机房重新接线,谷歌用镜面反射光路,几秒钟就能物理绕开一个坏掉的节点。这种把网络拓扑变成可以动态重构的物理层,而不是固定死的硬件连接,某种程度上像是给数据中心装上了一层可以自我修复的神经系统。
这份报告没有解决的问题也很明显,分离式推理在TPU上还没跑通,预测解码还在路上,智能体场景的完整基准测试也还没发布。TPU这次交出的答卷更像是半程成绩单,剩下的那一半,才是真正决定它能不能撼动英伟达护城河的部分。
那道被讨论了十几年的护城河,这次算是第一次被人认真量了尺寸。它到底有多深,可能还得再等几个月才能知道答案。