

递归自我改进(RSI)让大模型能够根据失败经验修改自己的 Prompt、工作流,甚至生成训练数据,再反过来提升下一轮表现。
今天的 AI 系统能力不只是依赖模型权重。完整系统由三部分共同决定:Data、Model 和 Harness。
如果只优化其中一层,很容易出现“局部最优”。比如把规则不断塞进 Prompt 和 Memory,虽然短期有效,却会让推理上下文越来越重。只做训练的话,就可能把本来可通过 Harness 解决的问题变成昂贵的 GPU 训练。
因此,CosmosMind联合清华大学、北京大学、斯坦福大学等高校研究者提出 MetaRSI-v1。不再把 RSI 看成某一种固定的自我修改方法,他们把整个 AI 系统拆成三个可以组合的改进面,并设计 Data-RSI、Harness-RSI 和 Model-RSI 三个算子,分别负责修改数据、执行框架和模型参数。
在此之上,再用 RSI² Agent 自动决定“下一步改哪里、按什么顺序改”,MetaRSI² Agent 则进一步学习“怎样更好地调度这些改进算子”。
实验中,在 Qwen3.5-35B-A3B 上,MetaRSI-v1 在四项测试上的平均提升达到 10.9 个百分点,比最强的固定组合策略进一步高出 3.6 个百分点。

其中,研究团队已经将 Harness-RSI 的运行时和 Genome 格式以 RSI-Harness 的形式开源。
01
核心方法:一个 Kernel,
三个 RSI 算子
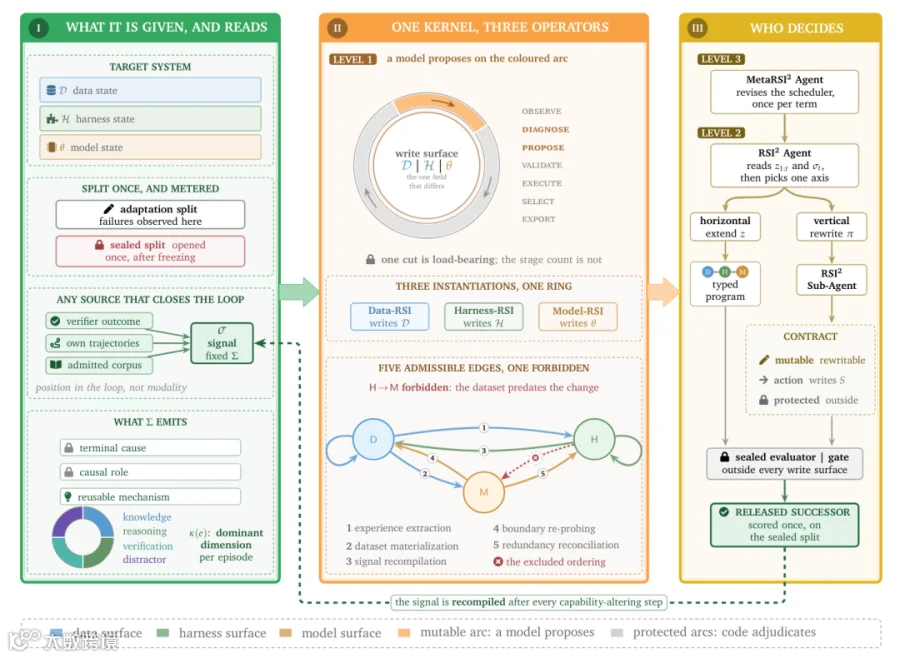
MetaRSI-v1 首先把待改进系统表示成:S =(D,θ,H)
其中 D 是数据状态,θ 是模型参数与训练状态,H 则是模型运行时使用的 Harness。
(1)RSI Kernel
为了让三种完全不同的修改方式能够组合,研究团队给它们规定了相同的执行内核:
Observe → Diagnose → Propose → Validate → Execute → Select → Export
Diagnose 和 Propose 由模型完成;Observe、Validate、Execute、Select 和 Export 则由确定性代码执行。
模型负责判断哪里出了问题、应该怎么改,但是否接受修改、如何执行以及修改是否真的有效,都由外部代码控制。
算子的输入是学习信号 σ,该信号由系统执行轨迹、验证器输出编译得到。
每次发生改变系统能力的操作后,学习信号会重新编译更新。
内核设置了一条不可改动的权限边界:模型仅负责提出修改,是否采纳修改、评估修改效果由外部确定性代码完成,禁止算子修改封闭评估器Q*、测试集、发布规则、资源账本,避免通过篡改评判标准虚增性能。

(2)Data-RSI,把运行经验变成训练数据
该算子负责修改数据状态 D。
从模型自身执行轨迹提取经验,生成经过验证的训练记录,放大模型已具备的能力,同时标记模型能力边界。
算子会输出四维学习签名,分别定位知识缺失、推理缺陷、验证步骤缺失、干扰项敏感四类失败成因。
合成流水线分为经验提取、指令生成、对抗生成、验证四道流程。
采用 “生成者‑验证者” 隔离校验机制:同一个目标模型分别扮演 Operator 和 Anchor,但 Anchor 看不到 Operator 给出的答案,需要独立重新求解;仅当两者输出一致,记录才被保留。
记录还要经过 schema 合约校验、语义重解校验双重闸门,过滤不合格样本,输出数据集工件供给另外两个算子使用。该算子不会改变模型行为,仅产出工件。
(3)Harness-RSI,直接改造 Agent 的运行环境
该算子不改动模型权重 θ,直接编辑执行脚手架 H。
脚手架分为五个可编辑槽位:系统提示词、持久化记忆、内置工具、技能库、MCP 挂载工具资源。算子输出 HarnessPatch,补丁必须写明修复假设、槽位修改操作、预期效果、风险声明。
候选补丁会在对应失败分片上重放评估,在复杂度预算约束下合并,只有新 Harness 严格超过历史最好结果,才会被正式替换。
它的优势是不用训练,修改后立即生效,代价则是新增 Prompt、Memory、Skills 等内容每次推理都会重复消耗上下文。
Model-RSI 则负责修改 θ。
它接收 Data-RSI 产生的数据,通过一个受约束的训练 Recipe 搜索空间决定 LoRA 的目标模块、Rank、学习率、Batch Size、序列长度和 Checkpoint 策略等,再训练多个候选模型。
训练始终从同一个固定基础 checkpoint (θ₀ )出发,使用累积数据集,避免多轮训练误差累积。
所以 Harness-RSI 和 Model-RSI 实际形成了一种成本互换:Harness 把能力放在上下文里,每次推理付费;Model-RSI 则通过一次训练,把这种能力内化到权重中。
(5)三个算子怎么组合?
MetaRSI-v1规定:只要系统能力发生变化,旧的学习信号就会“过期”。
因此三种算子之间并不是任意连接。
例如 H→M 被禁止。因为 Harness-RSI 修改系统之后,之前 Data-RSI 生成的数据已经对应的是“旧系统”,如果立刻拿这些数据训练模型,就等于用过期数据去内化新能力。
因此必须先 H→D,重新运行系统、生成最新数据,再执行 D→M。
最终论文定义了五种跨算子的合法转换,包括 D→H、D→M、H→D、M→D 和 M→H。

在此之上,RSI² Agent负责两条优化轴。横向决定下一步调用哪个算子、怎么排列;纵向则不改系统本身,修改某个 RSI 算子“如何分析失败、如何提出修改”的策略。
再往上一层,MetaRSI² Agent会在一个完整 Improvement Term 结束后复盘整个过程,调整 RSI² Agent 的调度策略。
于是形成“底层算子(Data、Model 和 Harness)修改系统本身;RSI² 层同时优化算子的提案策略与算子组合顺序;MetaRSI² 再进一步修改 RSI² Agent 的调度策略”的三级递归结构。
02
动态调度更有效,
只调 API 也能实现 RSI
实验主要覆盖两类任务。一类是可以执行程序自动验证的 Terminal-Bench 2.1 和 SWE-bench Pro;另一类是封闭式科学与数学推理,包括 GPQA-D-hard100 和 AIME 2025/2026,共 60 道 AIME 题。
核心实验使用 Qwen3.5-35B-A3B,整个过程中没有更强模型充当教师,诊断、数据生成、Harness 修改和调度都由目标模型自己完成。
实验结果如下表所示,MetaRSI-v1 将 Terminal-Bench 2.1 从 23.6 提升至 31.9,SWE-bench Pro 从 10.3 提升至 19.5;GPQA-D-hard100 从 71.2 提升至 83.8,AIME 则从 55.0 提升至 68.3。
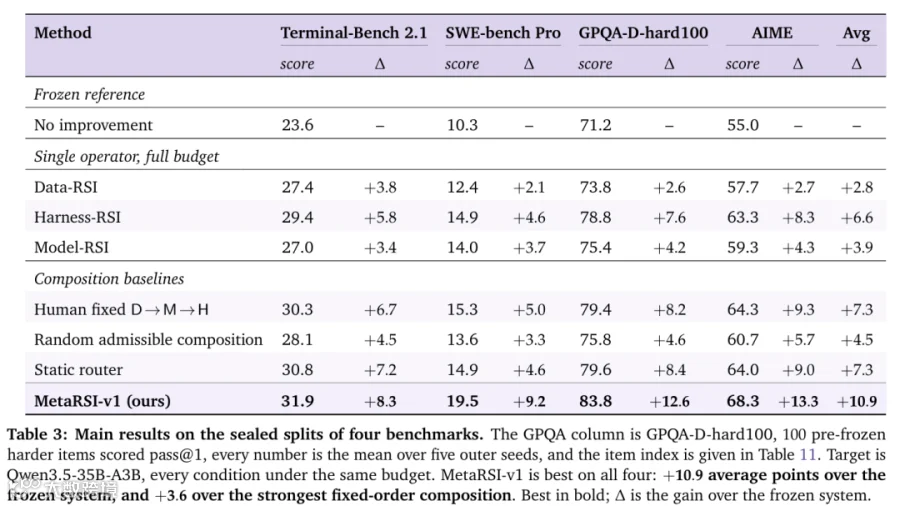
这里最重要的并不是“组合三个方法肯定比一个方法强”。因为固定 D→M→H 和 Static Router 同样拥有三个算子,也只获得 +7.3;MetaRSI-v1 达到 +10.9,额外的 3.6 个百分点来自动态调度本身。
Harness-RSI 虽然在四项测试中都是表现最好的单一算子,但它在 GPQA、AIME 等封闭式推理任务上的优势更加明显,在 Terminal-Bench 2.1、SWE-bench Pro 等可执行任务上,三个算子的差距明显缩小。
这说明不同失败模式适合不同的改进路径,也体现出三个算子之间的互补性。
如图10所示,研究团队还测试了只允许 Data-RSI + Harness-RSI 的 API 路线。
GPT-5.6 Sol、Claude Opus 5、Gemini 3.1 Pro、DeepSeek V4 Pro、Kimi K3、GLM-5.2 六个前沿模型全部在 Terminal-Bench 2.1 上实现自我提升,增幅 5.6~9.2 个百分点,平均 +7.3。
即便拿不到模型权重,只要能调用模型 API,依然可以沿着 Data-RSI ↔ Harness-RSI 这条 Harness Route,在不更新模型权重的情况下完成 RSI。

END
关注+星标,获取AI前沿进展与开源一线动态