


背景
4年前不知道用什么方式,就加入了智源社区的微信群,里面经常发内容。4年前,当时DeepSeek还没有火,智源就像布道者一样,为AI大模型打下产业和社区基础。
北京智源人工智能研究院(简称智源/BAAI)是2018年11月在科技部和北京市支持下成立的非营利性新型AI研发机构,是国内人工智能领域的核心原始创新平台。
基础核心信息
-
成立背景:由北京大学、清华大学、中国科学院、百度、小米、字节跳动等国内AI领域优势单位联合共建,首任院长为黄铁军,现任院长为王仲远,地址位于北京市海淀区成府路150号。 -
核心定位:聚焦AI基础理论与核心技术攻关,打造全球人工智能学术思想、顶尖人才、产业创新的源头,支撑国内AI产业的底层技术自主可控。
最近要研究文本大模型,DeepSeek推荐BGE-M3,并生成了第一版本代码,第一版本代码觉得不好用,转头仔细研究,发现第一版本代码就时套了个壳,没实际按我的思路来做,就研究了新版本,新版本基本满足了思路要求。DeepSeek推荐时BGE-M3,我看了性能要求, 不过印象不深,今天写文章,再读下细节,也发给观众。
BGE-M3是北京智源人工智能研究院(BAAI)在2024年1月正式发布的开源通用文本向量化模型,是BGE系列中定位全场景多能力的旗舰版本,相关核心论文于2024年2月公开上线。它基于BERT架构迭代优化而来,前期经过RetroMAE预训练、无监督对比学习两个阶段的技术铺垫,最终通过对密集、稀疏、多向量三种检索能力的统一微调完成最终版本打磨,后续还持续迭代了适配不同部署场景的衍生版本。
✨ 核心特点
-
M3核心特性
-
多功能性:单模型同时支持密集检索、稀疏检索、多向量检索三种主流检索模式,无需部署多个不同模型,就能同时实现语义匹配、关键词精确匹配、细粒度段落定位,天然适配混合检索管道。 -
多语言性:训练覆盖170余种语言的海量语料,正式支持100+种工作语言,可实现同语言检索和跨语言检索,适配跨国多语言业务场景。 -
多粒度性:最大支持8192 tokens的长文本输入,可从短句、段落到完整长文档全粒度处理,远超过常规嵌入模型512 tokens的上下文上限。
-
基础参数规格
-
总参数量569M,模型体积2.27GB,输出向量维度1024,采用MIT开源协议,支持完全本地化部署,无商用授权限制。
-
落地适配优势
-
在RAG系统、企业知识库问答、智能客服FAQ匹配、多语言内容检索、长文档去重等场景下表现突出,是目前开源混合检索方案的主流默认选型。 -
稀疏检索模式可精准匹配医药、法律、金融等专业领域术语,多向量模式能从长文档中直接定位到具体句子,大幅提升答案溯源的准确率。
⚠️ 局限性
相比仅支持密集检索的轻量模型,它的内存占用更高,在亿级以上的超大规模向量库场景下检索性能会受限,对毫秒级以下极低延迟的业务场景适配性一般。
看了介绍,我就对昨天使用huggingface下载BGE-M3大模型,一次下载文件500多M,一次下载2个多G有理解了,原来这和BGE-M3的基础参数有关系。
代码
初始化代码。
self.model = SentenceTransformer("./models/bge-m3-gguf/", device=self.device)
注意第一个参数是目录,目录下要有完整的参数文件,不全就会报错误,具体错误在huggingface网页里有。下面是目录文件清单图形:
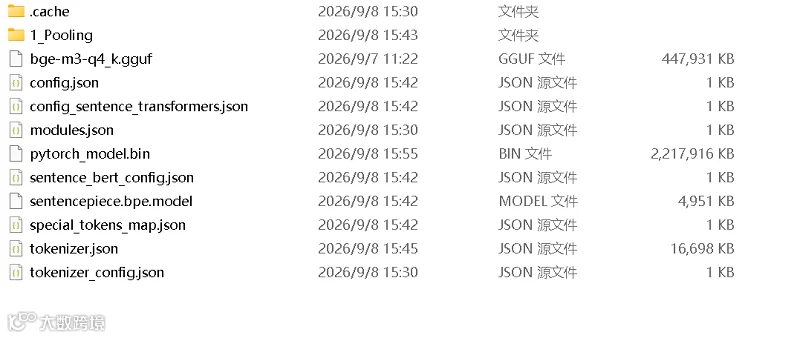
在第一版本代码不理想时,我想着改这些文件里的参数,比如config.json里的,
"_name_or_path": "",
"architectures": [
"XLMRobertaModel"
],
"attention_probs_dropout_prob": 0.1,
"bos_token_id": 0,
"classifier_dropout": null,
"eos_token_id": 2,
但被警告了,这些是和BGE-M3思考密切相关的参数,改了后,BGE-M3就不能正常工作了。
编码转换代码:
sentence_embeddings = self.model.encode(sentences, show_progress_bar=True)
encode是编码的意思,相当于把句子转换成Transformer形式的数据,下面是数据截图:

里面数据有三项,对应三段话,里面的浮点数就是文本大模型对文本的向量度的表达值。在一些视频里讲Transformer,提到KPV值,这些原理对初学者来说有距离,把数据直观看到,初学者就好有感觉,再加上几步调用,就对文本大模型的用法和结果有直观印象,比只学理论不敢动手强。