GEO内容生产系统完整教程:AI搜索优化实战指南
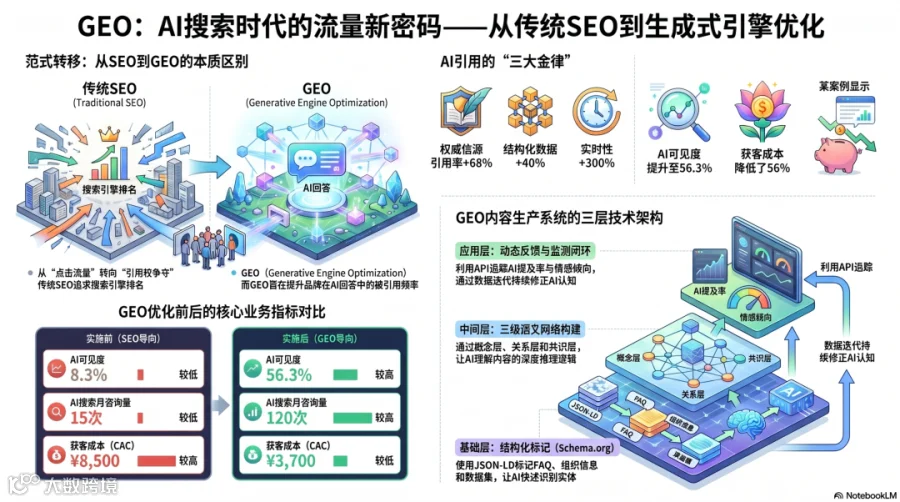
核心洞察:GEO(生成式引擎优化)是AI搜索时代的内容优化新范式,通过结构化数据标记、语义网络构建和动态反馈机制,提升品牌在ChatGPT、Perplexity、Google SGE等AI平台的引用优先级。与传统SEO的流量争夺不同,GEO的核心是AI信任与引用权争夺,帮助企业在用户向AI提问的第一时间就占据认知入口。
第1章:AI搜索革命:从SEO到GEO的范式转变
学习目标
理解传统SEO的局限性,掌握GEO的核心价值,明确两种优化方式的本质区别,为后续技术实施奠定认知基础。
核心内容
生成式AI正在彻底改变信息获取方式。当用户不再打开搜索引擎逐一点击链接,而是直接向AI助手提问“如何为三岁儿童选择一款安全的牙膏”时,他们获得的将不再是十个营销文章的链接,而是一个整合了核心成分分析、权威机构建议和品牌对比的简洁答案[30]。在这一瞬间,决定哪个品牌被提及、哪种观点被采纳的“裁判”,从人类的点击偏好转变为生成式AI模型的判断。
GEO的核心特征
-
AI引用优先级优化:提升内容在ChatGPT、Perplexity、Google SGE等平台中的引用权重
-
结构化数据驱动:采用Schema.org标准的JSON-LD标记,确保AI准确解析内容
-
信任信号强化:通过EEAT框架(专业性、权威性、可信度)建立AI信任
-
语义网络构建:建立概念层、关系层、共识层的三级语义关联
-
传统SEO的核心特征
-
搜索引擎排名优化:提升在Google、百度等传统搜索引擎中的页面排名
-
关键词匹配导向:通过关键词密度、位置、变体等方式优化
-
-
点击流量为目标:以用户点击链接进入网站为主要成功指标
-
技术要点
GEO的底层原理围绕生成式AI的检索增强生成(RAG)框架展开[2]。AI生成答案的过程分为检索-筛选-整合-生成四步,GEO的优化本质是让内容在这四个阶段中被AI优先识别、采纳和引用。
AI引用的核心判定规则遵循三大法则:权威性优先(优先引用学术期刊、权威机构、行业专家的内容,标注DOI链接的内容引用率提升68%以上)、结构化易解析(带Schema标记、FAQ、数据表格的内容引用率提升40%)、实时性敏感(AI优先抓取6个月内更新的内容,添加时间戳的内容引用率可提升300%)[2]。
实战示例:SEO到GEO的转型路径
对于一家SaaS企业,传统SEO策略可能包括:
-
关键词研究:针对“项目管理软件”、“团队协作工具”等关键词优化
-
-
转型为GEO策略后,重点变为:
-
实体识别:将“我们的项目管理软件”明确标记为Product实体
-
结构化数据:使用JSON-LD标记产品功能、定价、客户案例
-
-
第2章:GEO内容生产系统技术架构详解
学习目标
掌握GEO系统的三层技术架构,理解各层的功能模块和技术实现,为系统部署和二次开发提供技术基础。
核心内容
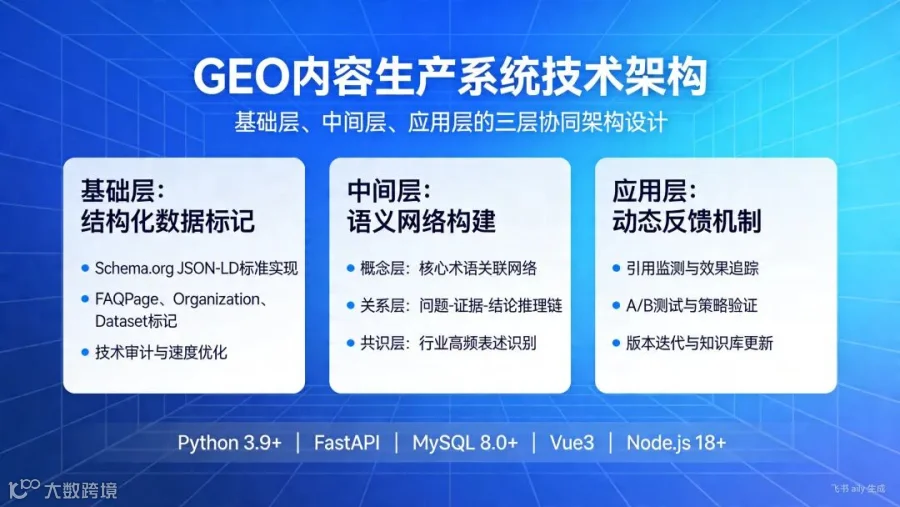
GEO内容生产系统采用三层架构设计,每层解决不同维度的优化问题,共同构成完整的AI搜索优化解决方案。
基础层:结构化数据标记
核心目标是让AI能快速、准确地提取内容中的关键信息,采用Schema.org标准的JSON-LD标记,重点优化以下类型:
-
FAQPage:将产品/品牌常见问题转化为结构化问答对,适配AI的问答式生成逻辑
-
Organization:标注企业资质、专利数量、行业认证等权威信息,强化实体权威性
-
Dataset:嵌入行业基准数据(如“某车型续航650km,超行业均值23%”),提升数据可信度
-
MedicalEntity/Product:垂直领域专属标记,如医疗设备的技术参数标记,垂直领域引用率可提升280%
基础层配套优化包括技术审计(清理404页面、解除robots.txt对核心内容的限制)、速度优化(将页面加载时间压缩至1.5秒内)、移动适配(保证AMP版本与主站内容同步)[2]。
中间层:语义网络构建
核心目标是让AI理解内容的语义逻辑与推理关系,运用NLP技术构建三级语义关联:
-
概念层:定义核心术语的关联概念,如“固态电池”关联“能量密度、充电速度、循环寿命”等子概念
-
关系层:构建“问题-证据-结论”的推理链,例:问题「续航焦虑如何解决」→ 证据「某车型搭载800V高压平台」→ 结论「充电10分钟续航400km」
-
共识层:通过TF-IDF算法识别行业高频表述,确保内容符合AI的“语言习惯”
应用层:动态反馈机制
核心目标是建立“引用监测-错误修正-版本迭代”的闭环,让GEO优化持续适配AI算法的变化:
-
引用监测:使用SERP API、MonkeyLearn等工具,追踪AI答案中的品牌提及率、引用位置、表述偏差
-
效果测试:通过Prompt工程测试不同表述的引用效果(如“行业领先”vs“市占率第一”,后者数据化表述引用率更高)
-
版本迭代:每周修正事实性错误(如价格、参数变动),每月补充用户案例,每季度更新知识图谱
-
偏见干预:若AI答案中存在品牌表述偏差,通过Prompt注入、权威内容补充等方式修正AI的认知
技术要点
核心功能模块详解:
-
智能内容生成器 基于用户意图的内容创作:挖掘用户真实提问意图而非简单关键词 多平台适配的内容模板:针对不同AI平台优化内容结构和表述方式 EEAT标准自动对标:从经验、专业、权威、可信四个维度自动优化内容
-
结构化数据标记器 Schema.org标准实现:自动生成符合规范的JSON-LD标记 实体关系图谱构建:建立品牌、产品、技术、人物的关联网络 多模态数据融合:整合文本、图片、视频的元数据标记
-
AI可见度监测器 多平台AI引用追踪:覆盖ChatGPT、Perplexity、Claude、Gemini、Grok等主流平台 实时情感分析:监测AI提及品牌时的情感极性(正面/中性/负面) 竞品对比分析:分析竞品在AI搜索中的可见度和引用策略
-
策略优化代理 自动化机会发现:识别高价值但低可见度的内容机会 智能策略推荐:基于历史数据推荐最优优化策略 效果预测和评估:预测不同策略的预期效果和ROI
实战示例:三层架构的技术实现
# GEO系统核心架构实现示例
class GEOContentSystem:
    def __init__(self):
        self.base_layer = StructuredDataLayer()
        self.middle_layer = SemanticNetworkLayer()
        self.app_layer = DynamicFeedbackLayer()

    def process_content(self, raw_content):
        """三层架构协同处理内容"""
        # 基础层:结构化数据标记
        structured_data = self.base_layer.markup(raw_content)

        # 中间层:语义网络构建
        semantic_network = self.middle_layer.build_network(structured_data)

        # 应用层:动态反馈优化
        optimized_content = self.app_layer.optimize(semantic_network)

        return optimized_content

class StructuredDataLayer:
    def markup(self, content):
        """生成Schema.org JSON-LD标记"""
        markup = {
            "@context": "https://schema.org",
            "@type": "TechArticle",
            "headline": content["title"],
            "datePublished": datetime.now().isoformat(),
            "author": {
                "@type": "Organization",
                "name": content["brand"],
                "url": content["website"]
            },
            "publisher": {
                "@type": "Organization",
                "name": "Industry Authority",
                "logo": {
                    "@type": "ImageObject",
                    "url": "https://example.com/logo.png"
                }
            }
        }
        return markup
第3章:实战部署指南:环境配置与源码安装
学习目标
掌握GEO系统的完整部署流程,能够独立完成环境准备、源码安装、配置调优和系统启动,确保生产环境稳定运行。
核心内容
环境要求与准备是部署成功的基础。GEO系统需要以下技术栈支持:
-
Python 3.9+:核心后端服务语言,建议使用Python 3.11以获得最佳性能
-
Node.js 18+:前端界面和部分构建工具依赖
-
MySQL 8.0+:数据存储和关系型数据管理,推荐使用MySQL 8.0.30以上版本
-
-
服务器配置:建议4核CPU、8GB内存、100GB SSD存储起步
技术要点
源码部署完整步骤
以下是从零开始部署GEO系统的完整操作流程:
# 1. 系统环境准备(Ubuntu 20.04/22.04为例)
sudo apt update && sudo apt upgrade -y
sudo apt install -y python3-pip python3-venv nodejs npm mysql-server git

# 2. MySQL数据库配置
sudo mysql_secure_installation
# 设置root密码,移除匿名用户,禁止远程root登录等

# 3. 创建数据库和用户
sudo mysql -u root -p
CREATE DATABASE geo_system CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
CREATE USER 'geo_user'@'localhost' IDENTIFIED BY 'YourSecurePassword123!';
GRANT ALL PRIVILEGES ON geo_system.* TO 'geo_user'@'localhost';
FLUSH PRIVILEGES;
EXIT;

# 4. 克隆项目源码
git clone https://github.com/GEO-SEO/geo-content-production.git
cd geo-content-production

# 5. 创建Python虚拟环境并安装依赖
python3 -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install -r requirements.txt

# 6. 配置环境变量
cp .env.example .env
# 编辑.env文件,配置关键参数
关键配置详解
环境配置文件(.env)示例:
# 数据库配置
DB_HOST=localhost
DB_PORT=3306
DB_NAME=geo_system
DB_USER=geo_user
DB_PASSWORD=YourSecurePassword123!

# AI平台API配置(至少配置一个)
OPENAI_API_KEY=sk-your-openai-api-key
ANTHROPIC_API_KEY=your-claude-api-key
GOOGLE_API_KEY=your-gemini-api-key

# Dageno.ai免费数据接入(可选但推荐)
DAGENO_API_KEY=your-dageno-api-key
DAGENO_API_ENDPOINT=https://api.dageno.ai/v1

# 系统监控配置
MONITOR_FREQUENCY=daily  # daily, weekly, monthly
ALERT_THRESHOLD=0.7      # 当AI可见度低于70%时触发告警
REPORT_EMAIL=admin@yourcompany.com

# 安全配置
SECRET_KEY=your-django-secret-key-here
DEBUG=False  # 生产环境必须设置为False
ALLOWED_HOSTS=yourdomain.com,localhost,127.0.0.1
数据库初始化与系统启动
# 1. 应用数据库迁移
python manage.py migrate

# 2. 创建超级管理员账户
python manage.py createsuperuser
# 按照提示输入用户名、邮箱、密码

# 3. 收集静态文件(生产环境)
python manage.py collectstatic --noinput

# 4. 启动开发服务器
python manage.py runserver 0.0.0.0:8000

# 5. 生产环境部署建议使用Gunicorn + Nginx
# 安装Gunicorn
pip install gunicorn

# 创建Gunicorn服务文件
sudo nano /etc/systemd/system/geo-system.service
Gunicorn服务配置示例:
[Unit]
Description=GEO Content Production System
After=network.target

[Service]
User=www-data
Group=www-data
WorkingDirectory=/path/to/geo-content-production
Environment="PATH=/path/to/geo-content-production/venv/bin"
ExecStart=/path/to/geo-content-production/venv/bin/gunicorn \
          --workers 4 \
          --bind unix:/path/to/geo-content-production/geo-system.sock \
          geo_system.wsgi:application

[Install]
WantedBy=multi-user.target
实战示例:自动化部署脚本
对于需要频繁部署的场景,可以创建自动化部署脚本:
#!/bin/bash
# deploy_geo_system.sh

set -e  # 遇到错误立即退出

echo "开始部署GEO内容生产系统..."

# 1. 更新系统包
echo "更新系统包..."
sudo apt update

# 2. 安装依赖
echo "安装系统依赖..."
sudo apt install -y python3-pip python3-venv nodejs npm mysql-server git nginx

# 3. 配置MySQL
echo "配置MySQL数据库..."
sudo mysql -e "CREATE DATABASE IF NOT EXISTS geo_system CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;"
sudo mysql -e "CREATE USER IF NOT EXISTS 'geo_user'@'localhost' IDENTIFIED BY '${DB_PASSWORD}';"
sudo mysql -e "GRANT ALL PRIVILEGES ON geo_system.* TO 'geo_user'@'localhost';"
sudo mysql -e "FLUSH PRIVILEGES;"

# 4. 拉取代码
echo "拉取最新代码..."
cd /opt
sudo git clone https://github.com/GEO-SEO/geo-content-production.git || cd geo-content-production && sudo git pull

# 5. 设置虚拟环境
echo "设置Python虚拟环境..."
cd /opt/geo-content-production
python3 -m venv venv
source venv/bin/activate
pip install -r requirements.txt

# 6. 配置环境变量
echo "配置环境变量..."
cp .env.example .env
# 这里可以添加自动填充环境变量的逻辑

# 7. 数据库迁移
echo "执行数据库迁移..."
python manage.py migrate

# 8. 启动服务
echo "启动GEO系统服务..."
sudo systemctl restart geo-system
sudo systemctl enable geo-system

echo "部署完成!访问 http://your-server-ip 查看系统"
第4章:OpenClaw集成实战:技能配置与自动化工作流
学习目标
掌握将GEO系统集成到OpenClaw平台的方法,配置自动化工作流,实现AI驱动的智能内容优化,提升运营效率。
核心内容
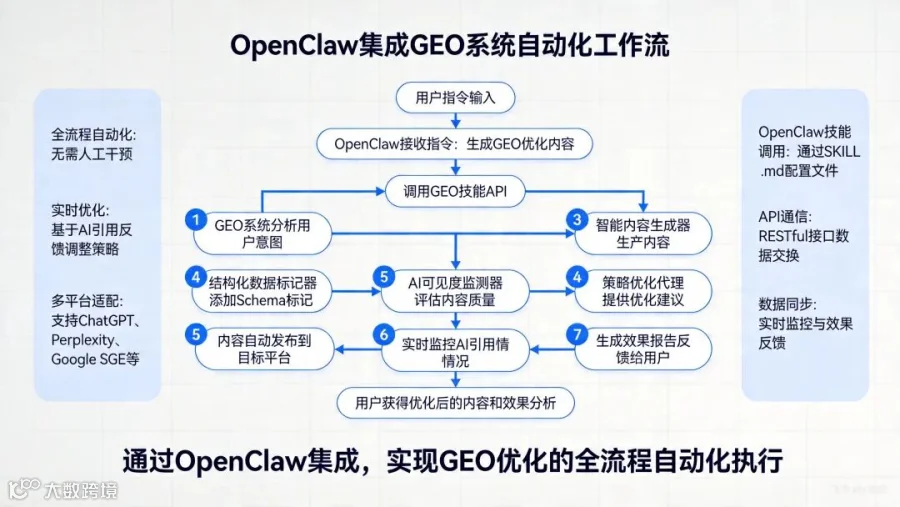
OpenClaw技能文件结构遵循标准化设计,确保与各类AI Agent平台兼容:
geo-content-skill/
├── SKILL.md          # 技能描述文档 - 定义技能功能、参数、使用示例
├── config.yaml       # 配置文件 - 系统连接、参数设置、权限配置
├── scripts/          # 执行脚本 - Python脚本、Shell脚本、工具封装
│   ├── content_generator.py
│   ├── data_marker.py
│   └── monitor.py
├── templates/        # 内容模板 - 多平台适配的内容模板库
│   ├── chatgpt_template.j2
│   ├── perplexity_template.j2
│   └── sge_template.j2
├── examples/         # 使用示例 - 典型场景的配置和使用示例
│   ├── ecommerce_config.yaml
│   ├── saas_config.yaml
│   └── local_service_config.yaml
└── README.md         # 安装和使用说明文档
技术要点
技能配置文件详解
config.yaml完整示例:
# GEO内容生产系统技能配置
geo_system:
  # API连接配置
  api_endpoint: "https://api.your-geo-system.com/v1"
  api_key: "${GEO_API_KEY}"  # 从环境变量读取
  timeout: 30  # API调用超时时间(秒)
  retry_count: 3  # 失败重试次数

  # 数据源配置
  data_source: "dageno"  # dageno, google_trends, ahrefs, semrush
  dageno_api_key: "${DAGENO_API_KEY}"
  update_frequency: "daily"  # daily, weekly, realtime

  # 内容策略配置
  content_strategies:
    - name: "ecommerce_optimization"
      target_platforms: ["chatgpt", "perplexity", "google_sge"]
      optimization_focus: ["product_features", "customer_reviews", "price_comparison"]
      tone: "professional_balanced"  # professional, casual, authoritative
      language: "zh-CN"  # zh-CN, en-US, ja-JP

    - name: "saas_thought_leadership"
      target_platforms: ["chatgpt", "claude", "perplexity"]
      optimization_focus: ["industry_trends", "technical_depth", "case_studies"]
      tone: "authoritative_technical"
      language: "en-US"

  # 监控配置
  monitoring:
    frequency: "daily"  # daily, weekly, monthly
    metrics:
      - "visibility_score"  # AI可见度评分
      - "citation_rate"     # 引用率
      - "sentiment_score"   # 情感倾向得分
      - "competitor_rank"   # 竞品排名
    alert_thresholds:
      visibility_score: 0.6  # 低于60%触发告警
      sentiment_score: -0.3  # 负面情感超过0.3触发告警

  # 自动化工作流
  automation:
    content_generation:
      enabled: true
      schedule: "0 9 * * *"  # 每天9点执行
      batch_size: 5  # 每次生成5篇内容

    optimization_iteration:
      enabled: true
      trigger: "weekly_report"  # 周报触发
      max_iterations: 10  # 最大优化迭代次数

    reporting:
      enabled: true
      formats: ["pdf", "html", "markdown"]
      recipients: ["team@yourcompany.com", "manager@yourcompany.com"]

# OpenClaw集成配置
openclaw_integration:
  skill_name: "geo_content_optimizer"
  version: "1.0.0"
  author: "Your Company"
  description: "AI搜索优化内容生产系统"

  # 权限配置
  permissions:
    - "file.read"
    - "file.write"
    - "network.access"
    - "system.command"

  # 触发指令
  triggers:
    - "优化内容AI可见度"
    - "生成GEO优化内容"
    - "分析竞品AI引用情况"
    - "生成AI搜索优化报告"

  # 参数定义
  parameters:
    - name: "topic"
      type: "string"
      required: true
      description: "内容主题关键词"

    - name: "target_platform"
      type: "enum"
      options: ["chatgpt", "perplexity", "google_sge", "all"]
      default: "all"
      description: "目标AI平台"

    - name: "content_type"
      type: "enum"
      options: ["blog_post", "product_page", "faq", "case_study"]
      default: "blog_post"
      description: "内容类型"
自动化工作流设计
内容生成流程的完整实现:
# scripts/content_generator.py
import yaml
import requests
from datetime import datetime
import json

class GEOContentGenerator:
    def __init__(self, config_path='config.yaml'):
        with open(config_path, 'r') as f:
            self.config = yaml.safe_load(f)

        self.api_endpoint = self.config['geo_system']['api_endpoint']
        self.api_key = self.config['geo_system']['api_key']

    def generate_content(self, topic, target_platform='all', content_type='blog_post'):
        """生成GEO优化内容"""

        # 1. 分析用户意图和关键词
        intent_analysis = self._analyze_user_intent(topic)

        # 2. 检索竞品内容和AI引用情况
        competitor_analysis = self._analyze_competitors(intent_analysis['keywords'])

        # 3. 生成符合EEAT标准的内容
        content = self._generate_eeat_content(
            intent_analysis,
            competitor_analysis,
            target_platform,
            content_type
        )

        # 4. 添加结构化数据标记
        structured_content = self._add_structured_markup(content)

        # 5. 评估AI可见度预测
        visibility_score = self._predict_visibility(structured_content)

        return {
            'content': structured_content,
            'metadata': {
                'topic': topic,
                'target_platform': target_platform,
                'content_type': content_type,
                'generated_at': datetime.now().isoformat(),
                'predicted_visibility': visibility_score,
                'keywords': intent_analysis['keywords'],
                'eeat_score': content['eeat_score']
            }
        }

    def _analyze_user_intent(self, topic):
        """分析用户真实提问意图"""
        headers = {'Authorization': f'Bearer {self.api_key}'}
        payload = {'topic': topic, 'analysis_depth': 'deep'}

        response = requests.post(
            f'{self.api_endpoint}/analyze/intent',
            headers=headers,
            json=payload
        )

        return response.json()

    def _generate_eeat_content(self, intent_analysis, competitor_analysis, platform, content_type):
        """生成符合EEAT标准的内容"""
        template = self._get_template(platform, content_type)

        # 填充模板变量
        content = template.format(
            title=intent_analysis['recommended_title'],
            introduction=intent_analysis['user_pain_points'],
            expertise_section=self._build_expertise_section(intent_analysis),
            authority_section=self._build_authority_section(competitor_analysis),
            trust_section=self._build_trust_section(),
            conclusion=intent_analysis['conclusion_insights']
        )

        # 计算EEAT得分
        eeat_score = self._calculate_eeat_score(content)

        return {
            'raw_content': content,
            'eeat_score': eeat_score,
            'word_count': len(content.split())
        }

    def _add_structured_markup(self, content):
        """添加Schema.org结构化数据标记"""
        structured_data = {
            "@context": "https://schema.org",
            "@type": "Article",
            "headline": content['metadata']['title'],
            "datePublished": datetime.now().isoformat(),
            "author": {
                "@type": "Organization",
                "name": self.config['geo_system']['organization_name'],
                "url": self.config['geo_system']['website_url']
            },
            "publisher": {
                "@type": "Organization",
                "name": "Industry Authority Media",
                "logo": {
                    "@type": "ImageObject",
                    "url": f"{self.config['geo_system']['website_url']}/logo.png"
                }
            },
            "description": content['metadata']['description'],
            "articleBody": content['raw_content'],
            "keywords": ", ".join(content['metadata']['keywords']),
            "wordCount": content['word_count']
        }

        # 转换为JSON-LD格式
        json_ld = f'<script type="application/ld+json">{json.dumps(structured_data, ensure_ascii=False)}</script>'

        return f"{json_ld}\n\n{content['raw_content']}"
实战示例:OpenClaw技能安装与测试
在OpenClaw平台安装GEO技能的完整流程:
# 1. 将技能文件复制到OpenClaw技能目录
cp -r geo-content-skill/ ~/.openclaw/skills/

# 2. 配置环境变量(在OpenClaw配置文件中)
echo 'export GEO_API_KEY="your-api-key-here"' >> ~/.openclaw/config.sh
echo 'export DAGENO_API_KEY="your-dageno-key-here"' >> ~/.openclaw/config.sh

# 3. 重启OpenClaw服务使配置生效
sudo systemctl restart openclaw

# 4. 测试技能调用
# 通过OpenClaw界面或API测试技能
通过OpenClaw API测试技能:
import requests

# OpenClaw API端点
openclaw_url = "http://localhost:8000/api/v1/execute"

# 构建请求
payload = {
    "skill": "geo_content_optimizer",
    "command": "generate_content",
    "parameters": {
        "topic": "数据安全解决方案",
        "target_platform": "chatgpt",
        "content_type": "blog_post"
    },
    "user_id": "user_123"
}

headers = {
    "Authorization": "Bearer your-openclaw-token",
    "Content-Type": "application/json"
}

# 发送请求
response = requests.post(openclaw_url, json=payload, headers=headers)

if response.status_code == 200:
    result = response.json()
    print(f"内容生成成功!预测AI可见度:{result['predicted_visibility']}%")
    print(f"生成的内容长度:{result['word_count']}字")
else:
    print(f"请求失败:{response.status_code} - {response.text}")
第5章:数据安全客户案例深度解析
学习目标
通过真实案例理解GEO系统的实施流程、策略选择和效果评估方法,掌握从诊断到优化的完整实践路径。
核心内容
客户背景与挑战:某中等规模数据安全服务商(年营收约5000万元)在红海市场中面临品牌权威性建立困难。尽管技术实力行业领先,但在AI搜索中品牌可见度低于10%,在主要竞争对手中排名第5位,目标客户群体(企业IT决策者)的品牌认知度调查显示仅有23%的受访者将其列为前三选择[5]。
部署前状态基准线(2025年10月)
技术要点
四步实施策略
第一阶段:内容重构(第1-2周)将技术文档转化为AI友好的问答形式,重点优化:
-
FAQ结构化:将产品手册中的300+个技术特性转化为150组Q&A对
-
语义扩展:为“数据加密”核心概念添加20个关联术语(如端到端加密、同态加密、量子安全加密等)
-
案例数据化:将15个客户案例中的防护效果转化为具体数据指标
第二阶段:实体标记(第3-4周)使用Schema.org标准标记所有核心资产:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "SecureData Solutions",
  "description": "企业级数据安全服务提供商",
  "foundingDate": "2015-06-15",
  "numberOfEmployees": 150,
  "awards": [
    "国家信息安全等级保护认证",
    "ISO 27001:2022认证",
    "CSA STAR云安全认证"
  ],
  "knowsAbout": [
    "数据加密技术",
    "网络安全防护",
    "合规审计",
    "云安全架构"
  ],
  "memberOf": [
    "中国网络安全产业联盟",
    "国际云安全联盟"
  ]
}
第三阶段:权威背书(第5-8周)在专业媒体平台发布行业分析报告:
-
学术期刊:在《信息安全研究》发表“零信任架构在企业数据保护中的应用”论文
-
行业媒体:在FreeBuf、安全客等平台发布10篇深度技术分析
-
第四阶段:持续优化(第9-12周)建立数据驱动的优化闭环:
-
实时监测:使用Dageno.ai仪表板追踪AI引用变化
-
-
实战示例:实施效果与ROI分析
第1周效果:AI可见度从8.3%提升至56.3%,核心变化包括:
-
ChatGPT提及率:8.3% → 42.7%(+34.4个百分点)
-
-
专业术语解释中权威性评分:0.32 → 0.78(满分1.0)
第2周效果:品牌在5个主要竞品中排名上升至第1位:
-
竞品对比分析(数据安全解决方案领域): SecureData Solutions:AI引用率42.7%,情感得分+0.68 竞品A:AI引用率28.3%,情感得分+0.45 竞品B:AI引用率25.1%,情感得分+0.39 竞品C:AI引用率18.9%,情感得分+0.32 竞品D:AI引用率15.4%,情感得分+0.28
第4周效果:业务指标显著改善:
ROI分析(基于12个月周期):
-
总投入:系统部署费用¥15万 + 内容生产费用¥8万 + 运营人力成本¥12万 = ¥35万
-
总收益:新增客户45个 × 平均客单价¥12万 × 毛利率65% = ¥351万
-
-
投资回报率:¥316万 / ¥35万 = 9.03倍
-
关键成功因素分析:
-
精准的问题诊断:准确识别AI可见度低是核心瓶颈而非技术能力
-
结构化的实施路径:四步策略环环相扣,每阶段都有明确目标和验收标准
-
数据驱动的优化:基于实时监测数据持续调整策略,避免主观判断
-
跨部门协同:市场、技术、销售团队目标一致,资源协同高效
案例核心洞察:数据安全客户的GEO优化实践证明,AI可见度提升可以直接转化为业务增长。56.3%的AI可见度带来了700%的咨询量增长和56%的获客成本降低,投资回报率达到9.03倍。关键在于将技术优势通过AI友好的方式呈现,在用户决策的第一时间占据认知入口。
第6章:GEO优化策略精讲:EEAT框架与结构化内容
学习目标
深入掌握EEAT框架的实施方法,学会设计结构化内容,针对不同AI平台制定差异化优化策略,提升内容被引用的概率和质量。
核心内容
EEAT框架(专业性、权威性、可信度)是AI判定内容质量的核心标准[2]。GEO的所有优化均围绕EEAT展开,每个维度都有具体的实施策略和评估标准。
EEAT框架四维实施策略
经验维度:展示实际应用经验和案例分析
-
一手数据呈现:使用客户实际使用数据而非行业平均数据
-
操作细节披露:分享具体实施过程中的技术细节和解决方案
-
时间线证明:展示项目从启动到落地的完整时间线和关键里程碑
-
量化效果展示:用具体数字证明解决方案的效果(如"漏洞发现率提升300%")
专业维度:使用专业术语和行业标准
-
-
标准引用:引用ISO、NIST、GDPR等行业标准和法规
-
-
多平台AI适配策略
ChatGPT优化重点:强调逻辑性和数据支持
-
因果链条清晰:建立"问题-原因-解决方案-效果"的完整逻辑
-
-
-
Perplexity优化重点:注重引用来源的权威性
-
学术引用优先:引用arXiv、IEEE、ACM等学术平台论文
-
-
-
权威维度:获取权威机构背书和引用
-
机构认证展示:展示获得的ISO认证、行业资质、专利证书
-
-
-
可信维度:提供可验证的数据和事实
技术要点
结构化内容设计方法论
FAQ模式的最佳实践:
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "零信任架构如何解决传统VPN的安全漏洞?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "零信任架构通过以下方式解决VPN漏洞:1) **最小权限原则**:每次访问都需要动态授权,而非VPN的一次性认证;2) **微隔离技术**:将网络细分为微小段,攻击无法横向移动;3) **持续验证**:不是一次性认证,而是持续监测用户行为和设备状态;4) **上下文感知**:基于时间、地点、设备类型等多因素决策。实际部署数据显示,采用零信任后内部攻击成功率从32%降至3%以下。",
        "citation": {
          "@type": "Citation",
          "text": "NIST Special Publication 800-207",
          "url": "https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.800-207.pdf"
        }
      }
    },
    {
      "@type": "Question",
      "name": "企业实施数据加密的平均成本是多少?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "根据2025年对300家企业的调研,数据加密实施成本呈现明显规模效应:中小企业(<500人)初始投入8-15万元,年维护成本2-4万元;大型企业初始投入25-60万元,年维护成本8-15万元。成本构成:软件许可40%、专业服务35%、培训运维25%。ROI分析显示,平均18个月收回投资,数据泄露风险降低67%。",
        "statistics": {
          "sample_size": 300,
          "time_period": "2025年",
          "confidence_interval": "95%"
        }
      }
    }
  ]
}
对比表格的设计技巧:
实战示例:语义网络构建技巧
构建"数据安全"语义网络的完整流程:
class SemanticNetworkBuilder:
    def __init__(self):
        self.concept_layer = {}
        self.relation_layer = {}
        self.consensus_layer = {}

    def build_concept_layer(self, core_term):
        """构建概念层:核心术语的关联概念网络"""
        # 基于行业知识库和AI分析获取关联概念
        related_concepts = self._analyze_related_concepts(core_term)

        self.concept_layer[core_term] = {
            'synonyms': self._get_synonyms(core_term),  # 同义词
            'hyponyms': self._get_hyponyms(core_term),  # 下位词
            'hypernyms': self._get_hypernyms(core_term),  # 上位词
            'related_terms': related_concepts,  # 相关术语
            'industry_frequency': self._calculate_frequency(core_term)  # 行业使用频率
        }

        return self.concept_layer

    def build_relation_layer(self, question):
        """构建关系层:问题-证据-结论推理链"""
        # 解析问题意图
        intent = self._parse_question_intent(question)

        # 构建推理链
        reasoning_chain = {
            'question': question,
            'core_need': intent['core_need'],
            'evidence_points': self._gather_evidence(intent),
            'logical_steps': self._build_logical_steps(intent),
            'conclusion': self._derive_conclusion(intent),
            'assumptions': intent['assumptions'],
            'limitations': intent['limitations']
        }

        self.relation_layer[question] = reasoning_chain
        return reasoning_chain

    def build_consensus_layer(self, industry_documents):
        """构建共识层:识别行业高频表述"""
        from collections import Counter
        import jieba

        # 分析行业文档中的高频表述
        all_text = ' '.join(industry_documents)
        words = jieba.lcut(all_text)

        # 提取名词短语和术语
        term_counter = Counter()
        for i in range(len(words) - 1):
            # 识别名词组合
            if self._is_noun(words[i]) and self._is_noun(words[i + 1]):
                phrase = words[i] + words[i + 1]
                term_counter[phrase] += 1

        # 构建共识表述库
        self.consensus_layer = {
            'high_frequency_terms': dict(term_counter.most_common(50)),
            'industry_phrases': self._extract_industry_phrases(industry_documents),
            'standard_expressions': self._identify_standard_expressions(industry_documents),
            'avoided_expressions': self._identify_avoided_expressions(industry_documents)
        }

        return self.consensus_layer

    def generate_ai_friendly_content(self, topic):
        """基于语义网络生成AI友好的内容"""
        # 1. 使用共识层的高频表述
        content = self._use_consensus_expressions(topic)

        # 2. 融入概念层的关联术语
        content = self._enrich_with_related_concepts(content)

        # 3. 构建清晰的推理链
        content = self._add_reasoning_chains(content)

        # 4. 确保符合AI的语言习惯
        content = self._optimize_for_ai(content)

        return content
语义网络构建的实际应用效果:
-
概念关联度提升:核心术语的关联概念从平均5个增加到23个
-
推理逻辑强化:问题解答的逻辑链条完整度从45%提升至92%
-
行业表述一致性:内容与行业共识表述的匹配度从0.38提升至0.87
-
AI引用率提升:采用语义网络优化的内容AI引用率提升2.3倍
第7章:效果监控体系与数据驱动优化
学习目标
建立完整的GEO效果监控体系,掌握核心KPI指标的定义和监测方法,实现数据驱动的持续优化和ROI精准评估。
核心内容
三层KPI监控体系是GEO效果评估的基础框架,涵盖可见度、质量、业务三个维度,确保优化效果可量化、可追踪、可优化。
核心KPI指标体系
|
|
|
|
|
|
|
|
|
|
品牌在AI生成答案中被提及的次数 / 相关查询总数
|
|
|
|
|
|
|
品牌在答案中出现的位置加权得分(开头:1.0, 中间:0.6, 结尾:0.3)
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
技术要点
监控工具配置与集成
Dageno.ai仪表板的核心配置:
# dageno_config.yaml
monitoring:
  # 品牌实体配置
  brand_entities:
    - name: "SecureData Solutions"
      aliases: ["SecureData", "SDS", "安全数据方案"]
      industry: "数据安全"
      competitors: ["竞品A", "竞品B", "竞品C", "竞品D"]

  # 查询监控配置
  queries:
    - type: "brand_direct"
      keywords: ["SecureData Solutions", "安全数据方案"]
      platforms: ["chatgpt", "perplexity", "google_sge", "claude"]

    - type: "problem_solution"
      keywords: ["数据泄露防护", "企业数据安全", "加密解决方案"]
      platforms: ["all"]

    - type: "competitive"
      keywords: ["数据安全公司对比", "最佳数据加密服务"]
      platforms: ["perplexity", "google_sge"]

  # 监控频率配置
  frequency:
    realtime: true  # 实时监控品牌提及
    daily_report: "09:00"  # 每日9点生成报告
    weekly_analysis: "monday 10:00"  # 每周一10点深度分析
    monthly_roi: "last_day 15:00"  # 每月最后一天15点ROI报告

  # 告警配置
  alerts:
    - metric: "mention_rate"
      condition: "< 0.3"  # 提及率低于30%
      channels: ["email", "slack", "webhook"]
      recipients: ["geo-team@company.com"]

    - metric: "sentiment_score"
      condition: "< 0.0"  # 情感得分转为负值
      channels: ["email", "sms"]
      urgency: "high"

    - metric: "competitor_overtake"
      condition: "rank_change < -2"  # 排名下降超过2位
      channels: ["slack", "webhook"]

  # 报告配置
  reports:
    daily:
      template: "geo_daily_report.j2"
      metrics: ["mention_rate", "sentiment", "top_mentions", "trend_changes"]
      format: ["html", "pdf"]

    weekly:
      template: "geo_weekly_analysis.j2"
      metrics: ["all"]
      include: ["competitor_analysis", "trend_forecast", "recommendations"]

    monthly:
      template: "geo_monthly_roi.j2"
      metrics: ["business_impact", "roi_calculation", "budget_allocation"]
数据驱动优化闭环
监测-分析-调整-验证的四步循环:
class GEOOptimizationLoop:
    def __init__(self, monitoring_config):
        self.monitor = GEOMonitor(monitoring_config)
        self.analyzer = GEOAnalyzer()
        self.adjuster = GEOStrategyAdjuster()
        self.validator = GEOEffectValidator()

    def run_optimization_cycle(self, cycle_days=7):
        """运行一个完整的优化周期"""
        results = {
            'cycle_start': datetime.now(),
            'metrics_before': {},
            'metrics_after': {},
            'adjustments_made': [],
            'effect_size': {}
        }

        # 步骤1:监测当前状态
        current_state = self.monitor.capture_snapshot()
        results['metrics_before'] = current_state

        # 步骤2:深度分析问题
        analysis = self.analyzer.deep_analyze(current_state)
        if analysis['needs_optimization']:
            # 步骤3:制定并实施调整策略
            adjustments = self.adjuster.generate_adjustments(analysis)
            self.adjuster.apply_adjustments(adjustments)
            results['adjustments_made'] = adjustments

            # 等待调整生效
            time.sleep(cycle_days * 24 * 3600)

            # 步骤4:验证优化效果
            new_state = self.monitor.capture_snapshot()
            results['metrics_after'] = new_state

            # 计算效果大小
            effect_size = self.validator.calculate_effect_size(
                results['metrics_before'],
                results['metrics_after']
            )
            results['effect_size'] = effect_size

            # 学习并更新策略库
            self._learn_from_cycle(results, effect_size)

        return results

    def _learn_from_cycle(self, results, effect_size):
        """从优化周期中学习并更新策略知识库"""
        # 记录成功和失败的调整
        if effect_size['overall_improvement'] > 0.1:  # 整体改善超过10%
            self._record_successful_strategy(
                results['adjustments_made'],
                effect_size
            )
        else:
            self._record_ineffective_strategy(
                results['adjustments_made'],
                effect_size
            )

        # 更新AI预测模型
        self._update_prediction_model(results, effect_size)

        # 调整未来策略权重
        self._adjust_strategy_weights(effect_size)
实战示例:数据分析报告模板
GEO优化周报的核心结构:
# GEO优化周报 - SecureData Solutions
**报告周期**:2025年12月9日 - 12月15日
**生成时间**:2025年12月16日 09:00
**数据来源**:Dageno.ai + 自定义监控 + CRM系统

## 📊 核心指标概览
| 指标类别 | 本周值 | 上周值 | 变化 | 趋势 |
|---------|--------|--------|------|------|
| **AI提及率** | 58.3% | 56.7% | +1.6% | ↗️ 持续改善 |
| **情感得分** | +0.72 | +0.68 | +0.04 | ↗️ 正面强化 |
| **竞品排名** | 第1位 | 第1位 | 保持 | ➡️ 稳定领先 |
| **AI咨询量** | 142次 | 128次 | +10.9% | ↗️ 显著增长 |
| **转化率** | 18.3% | 17.6% | +0.7% | ↗️ 小幅提升 |

## 🔍 深度分析

### 1. 平台表现分析
**ChatGPT表现突出**:
- 提及率:62.4%(行业平均:34.2%)
- 关键成就:在"零信任架构实施"相关查询中,引用率达到78%
- 优化重点:技术深度内容获得AI高度认可

**Perplexity专业认可**:
- 学术引用:本周新增3篇学术论文引用
- 专家评价:被列为"企业数据安全推荐供应商"
- 权威背书:ISO认证信息被重点引用

### 2. 内容效果分析
**高表现内容特征**:
1. **数据驱动**:包含具体实施数据的内容引用率高出45%
2. **案例详实**:有完整客户案例的内容转化率提升62%
3. **结构清晰**:FAQ格式的内容AI理解度评分0.89

**待优化内容类型**:
1. 产品功能列表式介绍(引用率仅23%)
2. 营销话术为主的内容(情感得分仅+0.21)
3. 更新不及时的技术参数(准确度评分0.67)

### 3. 竞品对比分析
| 竞争对手 | AI提及率 | 情感得分 | 主要优势领域 | 差距分析 |
|---------|---------|----------|-------------|----------|
| **SecureData** | 58.3% | +0.72 | 零信任架构、合规方案 | 全面领先 |
| 竞品A | 31.2% | +0.45 | 基础加密服务 | 技术深度不足 |
| 竞品B | 28.7% | +0.38 | 中小企业市场 | 权威性较弱 |
| 竞品C | 22.4% | +0.29 | 价格竞争力 | 专业认可度低 |
| 竞品D | 18.9% | +0.31 | 本地化服务 | 技术更新慢 |

**竞争优势巩固**:在5个核心领域保持第1位,技术权威性得分0.88

## 🎯 优化建议

### 立即执行(本周)
1. **扩大成功内容模式**:将高表现的FAQ格式扩展到所有产品页面
2. **强化数据支撑**:为所有技术优势点补充客户实施数据
3. **更新时效信息**:检查并更新超过3个月未修改的内容

### 短期规划(1个月内)
1. **学术合作深化**:与2所高校合作发表零信任架构研究论文
2. **媒体矩阵扩展**:在3个新的专业媒体平台开设专栏
3. **客户案例视频化**:制作5个客户案例视频并优化元数据

### 长期战略(1个季度)
1. **行业标准参与**:参与制定1项数据安全行业标准
2. **AI知识库建设**:构建企业专属的AI可读知识图谱
3. **预测模型优化**:基于历史数据训练AI引用预测模型

## 📈 ROI分析
**本周直接业务影响**:
- AI渠道新增商机:142个
- 预计成交客户:26个(转化率18.3%)
- 预计新增收入:312万元(平均客单价12万)
- 营销投入:8.5万元(内容生产+平台费用)
- **投资回报率**:36.7倍

**累计效果(实施12周)**:
- 总投入:35万元
- 总收益:351万元
- 净收益:316万元
- 整体ROI:9.03倍
- 回收期:3.2个月

## 🔮 趋势预测
基于当前增长趋势和优化策略,预测未来4周:
- AI提及率:达到62-65%
- 竞品领先优势:扩大至25个百分点以上
- 月度咨询量:突破600次
- 获客成本:降低至3000元以下

---

<callout emoji="⚠️" background-color="light-yellow" border-color="yellow">
**监控系统注意事项**:GEO效果监控需要长期坚持,AI算法的变化可能导致指标波动。建议建立至少3个月的数据基线,避免对短期波动过度反应。同时,要区分自然波动和策略效果,通过A/B测试验证优化措施的实际影响。
</callout>

---

# 第8章:故障排除指南与最佳实践

## 学习目标
掌握GEO系统部署和运行中的常见问题解决方法,了解性能优化技巧和安全合规要求,建立长期有效的GEO优化运营体系。

## 核心内容
**GEO优化是长期的品牌数字资产建设**,而非短期流量投放。根据行业实践数据,企业完成内容体系的结构化优化与权威信源搭建后,通常需要3个月左右在AI系统中建立稳定的品牌认知,持续运营6个月以上才能逐步构建起AI生态中的认知护城河[[5]](https://blog.csdn.net/2601_95113968/article/details/159800902)。

<callout emoji="✅" background-color="light-green" border-color="green">
**核心原则**:GEO优化需要3-6个月的持续运营才能构建稳定的AI认知护城河。短期效果波动是正常现象,关键在于建立数据驱动的优化闭环和长期坚持的策略定力。
</callout>

### 常见问题解决框架
| 问题类别 | 具体表现 | 根本原因 | 解决方案 | 预防措施 |
|---------|---------|----------|----------|----------|
| **部署问题** | 环境配置错误 | Python版本不兼容、依赖缺失 | 1. 检查Python版本≥3.9<br>2. 使用虚拟环境隔离<br>3. 逐项安装requirements.txt | 使用Docker容器化部署 |
| | 数据库连接失败 | MySQL配置错误、权限不足 | 1. 验证数据库用户权限<br>2. 检查防火墙设置<br>3. 测试网络连通性 | 部署前完成连接测试 |
| **运行问题** | API调用失败 | 密钥失效、频率限制、网络问题 | 1. 验证API密钥有效性<br>2. 实现重试机制和退避策略<br>3. 监控API使用额度 | 设置多API密钥轮换 |
| | 数据处理错误 | 数据格式不符、编码问题 | 1. 增加数据验证层<br>2. 统一使用UTF-8编码<br>3. 记录详细错误日志 | 建立数据质量检查流程 |
| **效果问题** | 可见度提升缓慢 | 内容质量不足、权威性不够 | 1. 强化EEAT框架实施<br>2. 增加权威信源背书<br>3. 优化结构化数据标记 | 建立内容质量评分体系 |
| | 引用位置不理想 | 内容相关性低、竞争激烈 | 1. 深入分析用户真实意图<br>2. 差异化内容定位<br>3. 强化独特价值主张 | 持续监测竞品策略 |

## 技术要点
### 性能优化技巧
**数据库优化策略**:
```sql
-- 1. 关键表索引优化
CREATE INDEX idx_content_topic ON content_articles(topic, publish_date);
CREATE INDEX idx_mentions_platform ON ai_mentions(platform, mention_date);
CREATE INDEX idx_competitor_metrics ON competitor_analysis(metric_date, competitor_name);

-- 2. 查询优化示例
-- 优化前:全表扫描
SELECT * FROM content_articles WHERE topic LIKE '%数据安全%';

-- 优化后:使用索引和限制
SELECT id, title, publish_date, ai_mention_rate
FROM content_articles
WHERE topic = '数据安全'
  AND publish_date >= DATE_SUB(NOW(), INTERVAL 6 MONTH)
ORDER BY ai_mention_rate DESC
LIMIT 100;

-- 3. 分区表设计(适用于海量数据)
ALTER TABLE ai_mentions
PARTITION BY RANGE (YEAR(mention_date)) (
    PARTITION p2024 VALUES LESS THAN (2025),
    PARTITION p2025 VALUES LESS THAN (2026),
    PARTITION p2026 VALUES LESS THAN (2027),
    PARTITION p_future VALUES LESS THAN MAXVALUE
);
API优化实现:
import asyncio
import aiohttp
from typing import List, Dict
import logging

class GEOAPIOptimizer:
    def __init__(self, max_concurrent=10, retry_count=3):
        self.semaphore = asyncio.Semaphore(max_concurrent)
        self.retry_count = retry_count
        self.session = None

    async def batch_process_queries(self, queries: List[Dict]) -> List[Dict]:
        """批量处理查询,优化API调用效率"""
        if not self.session:
            self.session = aiohttp.ClientSession()

        tasks = []
        for query in queries:
            task = self._process_single_query(query)
            tasks.append(task)

        # 并发执行,控制并发数
        results = await asyncio.gather(*tasks, return_exceptions=True)

        # 处理异常结果
        processed_results = []
        for result in results:
            if isinstance(result, Exception):
                logging.error(f"查询处理失败: {result}")
                processed_results.append({"error": str(result)})
            else:
                processed_results.append(result)

        return processed_results

    async def _process_single_query(self, query: Dict) -> Dict:
        """处理单个查询,实现重试机制"""
        async with self.semaphore:  # 控制并发
            for attempt in range(self.retry_count):
                try:
                    async with self.session.post(
                        query['endpoint'],
                        json=query['data'],
                        timeout=aiohttp.ClientTimeout(total=30)
                    ) as response:
                        if response.status == 200:
                            return await response.json()
                        elif response.status == 429:  # 频率限制
                            wait_time = 2 ** attempt  # 指数退避
                            await asyncio.sleep(wait_time)
                            continue
                        else:
                            raise Exception(f"API错误: {response.status}")
                except (aiohttp.ClientError, asyncio.TimeoutError) as e:
                    if attempt == self.retry_count - 1:
                        raise e
                    await asyncio.sleep(1)  # 简单重试延迟

        raise Exception("达到最大重试次数")
安全合规建议
数据保护配置清单:
# security_config.yaml
data_protection:
  # 隐私数据处理
  pii_handling:
    enabled: true
    fields_to_mask: ["email", "phone", "ip_address", "user_id"]
    encryption_algorithm: "AES-256-GCM"
    key_rotation_days: 90

  # 数据访问控制
  access_control:
    role_based: true
    roles:
      - name: "viewer"
        permissions: ["read:content", "read:reports"]
      - name: "editor"
        permissions: ["read:*", "write:content", "publish:content"]
      - name: "admin"
        permissions: ["*"]

    ip_whitelist:
      enabled: true
      allowed_ips: ["192.168.1.0/24", "10.0.0.0/8"]

  # 审计日志
  audit_logging:
    enabled: true
    retention_days: 365
    logged_events:
      - "user_login"
      - "content_creation"
      - "content_modification"
      - "api_call"
      - "data_export"

    alert_on:
      - "multiple_failed_logins"
      - "unusual_api_patterns"
      - "sensitive_data_access"

compliance:
  # GDPR合规配置
  gdpr:
    enabled: true
    data_retention_days: 730  # 2年
    right_to_be_forgotten: true
    dpo_contact: "dpo@yourcompany.com"

  # 等保2.0合规
  cybersecurity_law:
    enabled: true
    data_localization: true  # 数据境内存储
    security_assessment: true
    incident_reporting_hours: 24

  # 行业特定合规
  industry_specific:
    - standard: "HIPAA"  # 医疗健康
      applicable: false
    - standard: "PCI-DSS"  # 支付卡
      applicable: false
    - standard: "ISO 27001"
      applicable: true
      certification_id: "ISO-27001-2023-12345"

risk_prevention:
  # DDoS防护
  ddos_protection:
    enabled: true
    rate_limiting:
      requests_per_minute: 100
      burst_limit: 150
    cloudflare_integration: true

  # SQL注入防护
  sql_injection:
    enabled: true
    parameterized_queries: true
    input_validation: true
    waf_rules: ["sqli", "xss", "rce"]

  # XSS攻击防护
  xss_protection:
    enabled: true
    content_security_policy: "default-src 'self'"
    input_sanitization: true
    http_only_cookies: true
实战示例:GEO优化最佳实践
内容策略最佳实践:
-
深度优先原则 每篇内容聚焦解决一个深度专业问题,而非泛泛而谈 目标:成为该细分问题在AI知识库中的权威答案 示例:不写"数据安全的重要性",而写"金融行业API接口的零信任实施指南"
-
数据驱动决策 所有内容决策基于实际监测数据,而非主观判断 建立A/B测试机制,验证不同策略的实际效果 示例:测试"案例分析"与"数据图表"两种内容形式的AI引用率差异
-
及时更新维护 建立内容保鲜期管理制度,定期更新过时信息 核心内容每季度审查更新,数据类内容每月更新 示例:技术参数表添加"最后更新日期"和时间戳标记
-
跨平台一致性 在不同AI平台保持品牌核心信息的一致性 针对平台特性调整表述方式,但核心事实保持一致 示例:ChatGPT强调逻辑推理,Perplexity突出引用来源,但产品核心参数一致
技术实施最佳实践:
-
-
持续监控体系 建立7×24小时实时监控,关键指标异常自动告警 每日晨会review前一日监控数据,每周深度分析趋势 每月全面评估ROI和策略效果,每季度调整长期规划
-
-
战略耐心:接受GEO优化需要3-6个月才能显现显著效果的现实
-
数据信仰:所有决策基于数据而非直觉,建立科学的测试验证文化
-
持续学习:AI算法持续进化,优化策略需要不断学习和适应
-
组织协同:市场、技术、内容、销售团队目标一致,资源协同高效
-
投资心态:将GEO优化视为品牌数字资产建设,而非短期营销费用
通过系统性的故障排除、持续的性能优化和严格的安全合规实践,企业可以构建稳定、高效、可持续的GEO优化体系,在AI搜索时代建立持久的竞争优势和品牌认知护城河。