


在不断进步的数字人技术领域,每一天都可能迎来一次技术突破,推动我们向前迈进。但是在这场高速发展的竞赛中,市场上五花八门的产品常常令消费者感到困惑:到底什么样的数字人算是高质量的产品呢?
我们之前曾讨论过挑选数字人时应考虑的五个主要因素,而今天,我们将着重解析其中的关键一环:音唇同步技术。这一技术是评估数字人质量的核心指标,让我们一同深入了解它的重要性和影响。
什么是音唇同步能力
我们常说的音唇同步能力,是指在数字动画、电影制作、虚拟现实和其他视觉媒体中,确保一个角色或数字人物的嘴唇运动与其发出或预录的声音精确匹配的能力。它的好坏与否,直接影响了用户对于虚拟人物真实度的感知,和环境沉浸感的体验。
卓越的音唇同步技术能够极大地提升视觉的连贯性、增进观众的情感投入、提供流畅的故事叙述和提升观众的互动参与度。拿数字人直播来说,如果主播的嘴型和声音对不上,不仅会立刻让观众识别出不自然的感觉,从而影响观赏体验,还可能触发一系列负面效应,最终对品牌形象造成不利影响。
目前,市面上数字人的音唇同步主要存在两大核心问题:
1.对于不熟悉音频处理的表现能力差,普通模型缺乏泛化能力,对于没有学习过的语音,模型的表现就会大打折扣,出现明显的文不对口的情况。
2.语音与面部运动对应效果差,过去的对应关系学习,往往只能得到平均的结果,对于出现困难的音节,或较快语速的场景,难以适应,导致面部表情模糊,影响用户观感。
解决这些挑战,关键在于语音和图像两个模态特征的深度融合。
我们的数字人技术,利用自主研发的多模态人工智能算法,能够准确捕捉各类声音属性,并将不同的感官特性进行有效关联。它通过语音输入来控制口型动作,确保语音的语调、情感及独特语言元素都能在口型上得到精确体现。这一过程通过高级模型的转换,实现了声音特征到相应面部表情的流畅对应,创造出高质感的动态表达效果。
四大步骤高效搞定
芽势数字人,采用四大步骤,实现高效音唇同步
1.声音+语义特征同步训练:将有助于识别说话者的身份、情绪状态以及语言的节奏和韵律的特征,结合语义中涉及对词汇、短语和句子的理解内容提取出来,同步训练,使模型能更好模拟人类的听觉和理解过程;
2.3D人脸关键定位:使用变分工作生成器(变分自编码+生成模型),来根据语音生成栩栩如生并且多样的人脸动作,这些人脸动作通过3D人脸关键点(如唇、眼睛、鼻子等面部特征的精确位置)进行表征,并通过大规模学习语音到动作的映射,使模型能够对新的、未知的语音输入做出更加准确的动作反应;
3.训练人脸动作的后处理网络:通过后处理网络的训练,来弥补大规模唇语数据集和定制视频之间的差异,这样一来,模型的面部表情,就会得到调整和改善,变的更加清晰和自然。
4.预测3D人脸关键点:基于NERF的渲染器这一3D场景的深度学习技术,模型根据我们预测到的3D人脸关键点,来渲染最终的说话人视频,这样一来,不管是处理困难的音节还是快速的语速,都能够游刃有余。
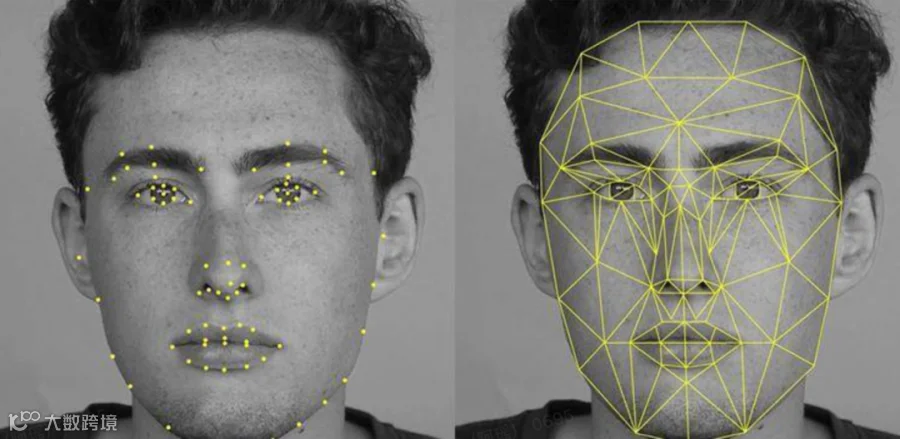
3D人脸关键点图(图片来源网络)
目前,芽势数字人的多模态人工智能模型可以实现120FPS无延时输出、仅需少量数据进行训练就能输出不同语种、语调的视频,经过众包测试,芽势数字人口型和语音匹配准确率高达99.9%,并且语音、语义、表情高度一致,让用户感受到视觉和听觉上的高度协调,为后续交互式体验的个性化互动奠定良好的音画基础。
这一具备极高泛化能力和鲁棒性的模型,在后续的短视频制作、数字人直播、虚拟助手、在线教育培训、跨语言内容本地化等领域,都会有更加广泛的运用。
未来,一知智能芽势数字人将在研发上不断投入,在保持真实的情况下,升级唇动2.0,仅需一段视频,无需特殊定制,开箱即用,可直接更新语音,驱动新视频生成。