在当前的人工智能生成内容时代,普通人也能轻松使用Midjourney、Stable Diffusion等AI工具创作出高品质的图像作品,其真实性已经到了肉眼难以辨认的地步。然而,这些逼真的仿造图像有时会带来社会层面的副作用——例如,利用生成的公众人物不当图片传播不实信息;或者使用合成的虚假照片进行金融诈骗活动,引发信任危机等问题。
为了应对这一挑战,华为诺亚方舟实验室对外开源了一个规模庞大的GenImage数据集。该数据集的开放旨在辅助企业和开发者迅速搭建起用于识别人工智能生成图像与真实图像的检测器和评估工具,其宏伟目标是为AIGC时代打造一个相当于ImageNet的基础设施。
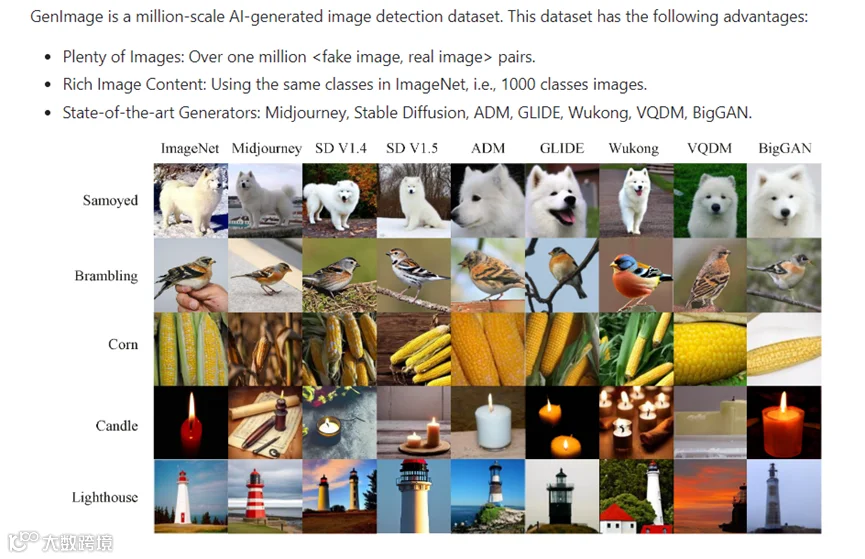
GenImage主要优点
1)大量图像,包括超过一百万对 AI 生成的假图像和收集的真实图像。
2)丰富的图像内容,涵盖广泛的1000类图像。
3) 最先进的生成器,Midjourney、Stable Diffusion、ADM、GLIDE、Wukong、VQDM等,利用先进的扩散模型和 GAN 合成图像。
正因为这些显著的优点,华为诺亚方舟实验室开源的GenImage数据集训练出的检测器不仅通过了综合性评估,而且展现了对多种类型图像的出色适用性和鉴别能力。
华为的研发团队对这一数据集进行了深入的分析,并基于此提出了两种评估任务,目的在于测试检测器在贴近真实世界应用场景下的有效性。在“交叉生成器”任务中,检测器会在一个特定AI生成器制造的图像数据集上进行训练,随后在由不同AI生成器制造的数据集上进行验证。这项任务的主要目标是衡量检测器对不同源生成图像的泛化和适应能力。

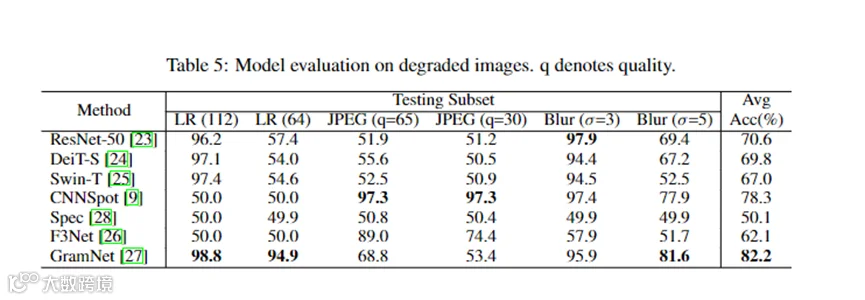
退化图像识别:检测器需要对于低分辨率,模糊和压缩图像进行识别。这个任务主要考察检测器在真实条件(如互联网上传播)中面对低质量图像时的泛化问题。
数据集介绍
过去开源界也推出了一些数据集,主要有三个特点。第一数据规模小,第二都是基于GAN的,第三是局限于人脸数据。随着时间推移,数据规模慢慢地在增加,生成器也从GAN时代过渡到Diffusion时代,数据的范围也在增加。
但是一个大规模以Diffusion模型为主,涵盖各类通用图像的数据集仍然是缺失的。
基于此,华为团队提出一个对标imagenet的genimage数据集。真实的图片采用了ImageNet。

虚假的图片采用ImageNet的标签进行生成。华为团队利用了八个先进的生成器来生成,分别是Midjourney, Stable Diffusion V1.4, Stable Diffusion V1.5, ADM, GLIDE, Wukong,VQDM和BigGAN。
这些生成器生成的图片总数基本与真实图片一致。每个生成器生成的图片数量也基本一致。每一类生成的图片数量基本一致。
实验结果
华为团队做了一些实验来考察这个数据集。他们发现在某个生成器上训练的ResNet-50模型在其他的测试准确率会明显降低。
然而在真实情况下华为团队难以得知遇到的图像的生成器是什么。因此检测器对于不同生成器生成图片的泛化能力很重要。
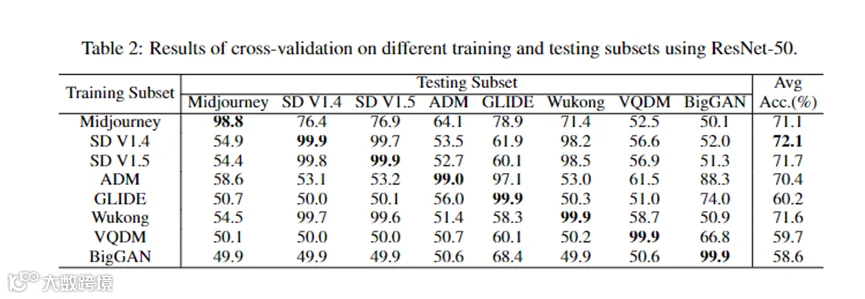
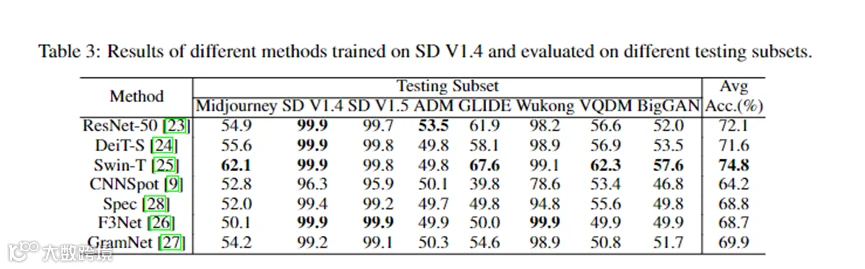
华为团队对比了现有方法在Stable Diffusion V1.4上训练,然后在各种生成器上测试的结果,也评测了各种生成器上训练,然后在各种生成器上测试的结果。
Testing Subset那一列中的每一个数据点,都是在八个生成器上训练,然后在一个生成器上测试得到的平均结果。然后华为团队将这些测试集上的结果平均,得到最右侧的平均结果。

华为团队对测试集进行退化处理,采用不同参数下的低分辨率,JPEG压缩和高斯模糊,评测结果如下
那么采集这么多数据是不是有用呢?华为团队做了相关实验,证明通过提升数据类比和每类的图片数量是可以提高性能。

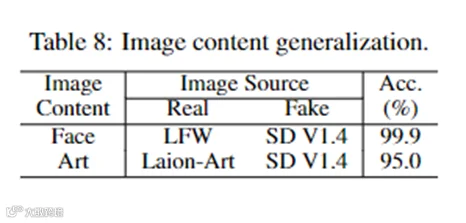
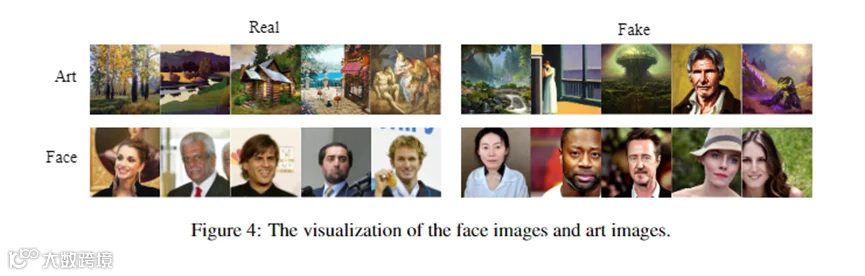
针对GenImage数据集对于不同图片的泛化能力,华为团队发现他对于人脸和艺术类图片也能达到很好的效果。