
大数跨境

Yann LeCun 万字演讲:「预测像素」是伪命题,JEPA 也并非凭空而来 | ECCV 2026

Yann LeCun 万字演讲:「预测像素」是伪命题,JEPA 也并非凭空而来 | ECCV 2026 AI科技评论
2026-09-14
3
导读:只靠语言和 token,AI 永远跨不过物理世界这道门槛!
只靠语言和 token,AI 永远跨不过物理世界这道门槛!

    作者丨幸丽娟

    编辑丨岑   峰

AI 行业的主叙事曾长期被 Scaling Law 垄断:模型越大、token 越多,通用人工智能(AGI)似乎便指日可待。然而,这条路线已撞上天花板:预训练边际收益递减,且模型在真实世界中漏洞百出。
2026 年,“世界模型”接棒成为新焦点,但四条技术路线对其定义各执一词:Sora 等视频生成派赌“涌现”,World Labs 赌“几何一致性”,英伟达赌“显式仿真”。而图灵奖得主 Yann LeCun 则选择了最孤峭的第四条路——JEPA(联合嵌入预测架构)。
根本分歧在于:机器要懂物理世界,是该复刻它还是推理它?LeCun 认为,连“预测像素”都是伪命题。在 ECCV 2026 Keynote 演讲中,他断言:仅靠语言和 token 训练,AI 无法达到人类水平智能,更无法跨越物理世界的门槛。
真正的下一代 AI,应打破对“生成式”的崇拜,从视频、传感器与交互中学习构建世界模型,利用 JEPA 在抽象表征空间预测未来、规划动作。LeCun 甚至给出三条“暴论”建议:别死磕生成式模型,别只研究 LLM,转向联合嵌入与世界模型。
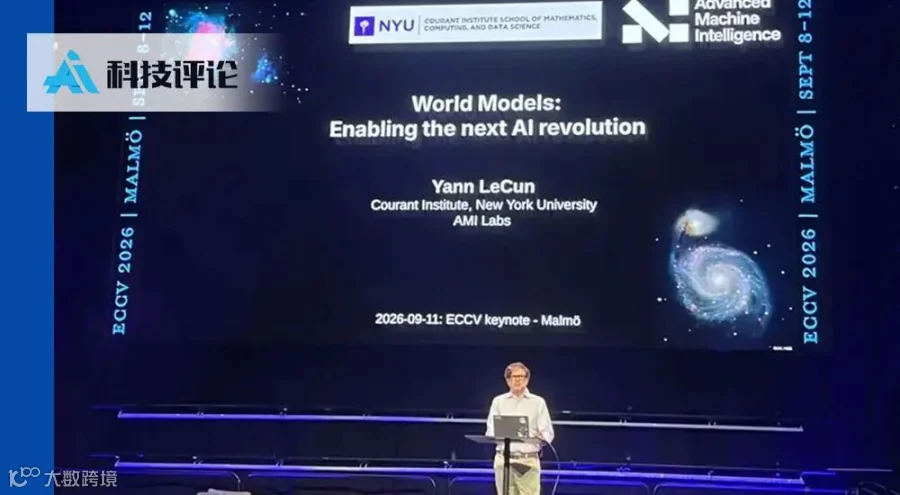
以下基于 Yann LeCun 在 ECCV 2026 大会的 Keynote 演讲内容整理。

01


我们离 AGI 还差得远

尽管硅谷舆论常宣称"AGI 已至”,但事实远非如此。当前 AI 系统在学习效率上与生物界存在量级差距。虽然 AI 能通过考试或编写代码,但在理解物理世界、处理高维连续数据(如图像、视频、传感器读数)方面,仍远落后于动物甚至婴儿。
目前的智能体系统依赖海量数据进行模仿学习,缺乏举一反三的能力。相比之下,人类和动物具备极强的适应性,能在新场景中通过零样本(0-shot)学习迅速解决问题。这种差异揭示了当前 AI 缺乏真正的“常识”。
以自动驾驶为例,人类青少年仅需约 20 小时练习即可掌握驾驶技能,而现有 AI 即便拥有数十亿小时的行车数据,仍无法实现 L5 级全自动驾驶。这印证了莫拉维克悖论:计算机擅长复杂计算,却难以完成生物本能般的简单任务。真正的智能,是面对未见过的处境时发明新技能解决问题的能力,而非陈述性知识的堆积。

02


智能的本质:人类自身都不“通用”,AI 也不该追求“通用”

发展心理学研究表明,婴儿通过观察逐步建立对物理世界的认知,如面孔识别、客体恒存及重力概念。然而,人类智能并非全能的“通用”,而是高度专门化的。每个人只能在特定领域成为专才,无法样样精通。因此,AI 的目标不应是无所不知,而是具备快速学习和适应新任务的能力。
从信息量角度分析,一个四岁儿童通过视觉和触觉接收的数据量(约 10¹⁴字节),已与互联网所有公开文本总量相当。这证明仅靠文本训练的大语言模型,其信息输入量远不足以支撑人类水平的智能。要让 AI 真正“看懂”世界,必须引入视觉等多模态数据。

03


从 token 预测到世界模型:System 2 缺位与十年布道

当前大语言模型的推断本质是被动的反应式计算,缺乏真正的推理过程。虽然思维链(Chain of Thought)增加了计算量,但在面对真实世界时,验证成本极高且不可压缩。LeCun 提出,应转向更强大的推断模式:不再直接生成答案,而是通过搜索和优化,找出能使能量函数最小化的最佳动作序列。
这需要“世界模型”的支持:给定当前状态和假设动作,预测未来的世界状态,并通过代价函数评估任务完成度。这一过程对应心理学中的 System 2(慢思考),即动用脑力进行规划与决策,而非 System 1 的本能反应。LeCun 强调,这才是通往自主机器智能的关键路径。

04


世界模型的建构:安全护栏与层级化规划

基于世界模型的架构天然具备安全性优势。通过设置“护栏”(Guardrails)目标函数,可以将安全规则硬编码进系统,确保任何动作序列都不会违反安全约束。这与当前大模型依赖事后对齐、“越狱”风险高的情况形成鲜明对比。
此外,未来的核心挑战是实现“层级化规划”。人类在执行复杂任务(如从纽约去巴黎)时,是在高层抽象概念上规划,再逐层细化为低级动作,而非直接控制肌肉。AI 同样需要构建层级化的世界模型,以适应真实世界的复杂性。

05


JEPA:不预测像素,在表征空间预测世界

构建世界模型不应沿用生成式架构去预测像素,因为这在物理上是不可能的(如无法预测镜头外发生的事)。LeCun 提出的 JEPA(联合嵌入预测架构)摒弃了像素级预测,转而在抽象表征空间进行预测。
JEPA 通过编码器丢弃输入中不可预测的细节(如树叶晃动、行人衣着褶皱),仅保留可预测的结构信息。这使得预测任务变得可行且高效,避免了生成式模型因强行预测所有细节而产生的模糊性问题。

06


表征坍塌的解法:从科学抽象到 SIGReg

非生成式预测面临“表征坍塌”的风险,即编码器忽略输入输出常量。解决之道在于最大化表征的信息量,同时最小化预测误差。这一思路符合科学方法论:忽略噪声,提取相关变量。
具体防止坍塌的方法包括样本对比和维度对比。LeCun 更推崇维度对比法,特别是 SIGReg(独立高斯正则化)。该方法通过将表征映射到高维空间并强制其边际分布接近高斯分布,从而获得信息量最大化的独立表征,有效避免了坍塌问题。

07


JEPA 的实证与应用:从 LeWorldModel 到 V-JEPA

JEPA 思想已在多个领域得到验证。LeWorldModel 证明了其在简单规划任务中的有效性;I-JEPA 在图像和视频表征学习上表现优异,甚至在深度估计等底层任务上超越了 CLIP 等监督模型。
最新的 V-JEPA 2.1 通过掩码时空块进行训练,不仅学会了视频预测,还自发理解了三维空间结构和物体遮挡关系,无需专门的深度标签。这证明了系统可以通过纯视频学习推断出“世界是三维的”这一常识。
LeCun 最后重申:若志在人类水平 AI,应停止单纯追求更好的生成式模型或 LLM,转而投身联合嵌入架构与世界模型的研究。

08


Q&A

提问者:继续做 LLM 还有意义吗?

Yann LeCun:LLM 在代码、数学等特定领域非常有用,但若目标是实现人类水平智能,仅靠 LLM 是不够的。我们需要补足感知和规划能力的缺失。

提问者:如何平衡 AI 发展的巨大成本与社会收益?

Yann LeCun:这是政治问题而非技术问题。社会应通过税收和政策来分配技术红利,而非由科学家决定。

提问者:在机器人应用中,如何定义“目标状态”?

Yann LeCun:目标状态不一定非要是图像,也可以是文本编码或其他形式。本质上,它是一个用于优化动作序列的代价函数。

提问者:JEPA 能否用于生物数据建模?

Yann LeCun:完全可行。目前已有研究利用 JEPA 对细胞现象及神经活动(MEG/EEG)进行建模。

提问者:如何保证世界模型在不可逆动作中的安全性?

Yann LeCun:安全性取决于世界模型的准确性和护栏目标的设定。风险主要来自三方面:模型预测错误、护栏设计不当(如目标函数邪恶)、或对世界状态的感知错误。

未经「AI 科技评论」授权,严禁以任何方式在网页、论坛、社区进行转载!

公众号转载请先在「AI 科技评论」后台留言取得授权,转载时需标注来源并插入本公众号名片。

【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 8950
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读243.5k
粉丝0
内容8.9k