大数跨境

对比 Codex,免费的 AgnesCode 也能在底层算子优化任务中打得有来有回

对比 Codex,免费的 AgnesCode 也能在底层算子优化任务中打得有来有回 AI科技评论
2026-09-14
7
导读:AgnesCode在部分芯片上跑出更高性能,免费模型完成专业级交付。
AgnesCode 在部分芯片上跑出更高性能,免费模型完成专业级交付。

    作者丨吴海明 曹 PP

    编辑丨李娜

免费的 AI Coding Agent 能否在真实工程任务中与付费的 Codex 抗衡?过去一年,Coding Agent 已能胜任网页生成与应用开发,但本次测试将其推向更底层:让 AI 优化大模型运行时使用的算子。
所谓“算子”,即大模型运行时反复执行的底层计算程序。模型每生成一个 Token,均需执行大量矩阵与注意力计算。单个算子若提升 10%-20% 的效率,将直接转化为推理速度、硬件利用率及服务成本的显著差异。
本次测试将 AgnesCode 搭配免费模型 Agnes 3.0 Flash,投入众智 FlagOS 开放计算全球大赛的算子优化赛道,以 DeepSeek-V3 解码阶段算子为考题,在 8 款芯片上进行自动化评测。对照组采用 Codex 搭配 GPT-5.6 Sol。两组在相同环境下编写代码并提交官方系统评测。
测试结果显示:Codex 组合耗时 8 分 57 秒完成,AgnesCode 组合耗时 20 分 36 秒。在通过率上,Codex 通过 7 款芯片,AgnesCode 通过 6 款。但在双方共同通过的 5 款芯片中,AgnesCode 有 4 项加速比更高。其中在国际通用芯片 B 上,AgnesCode 加速比达 4.81×,优于 Codex 的 3.71×,性能提升约 29.6%;此外,昆仑芯仅 AgnesCode 通过测试。
这证明当任务边界与评测闭环清晰时,免费 Agent 已能进入底层工程任务并交付具备性能收益的产物。Agent 时代,模型低价仅是入场券,能将任务执行到底才是分水岭。

01

一道题:优化 DeepSeek-V3 底层算子

为避免数据泄露导致模型“作弊”,本次测试跳过常规应用场景,直接挑战大模型推理算子优化。算子是模型运行的基础,其优化正成为 AI 自进化的关键一环:从依赖人工经验转向由 Coding Agent 自主读题、写码、测试与迭代。
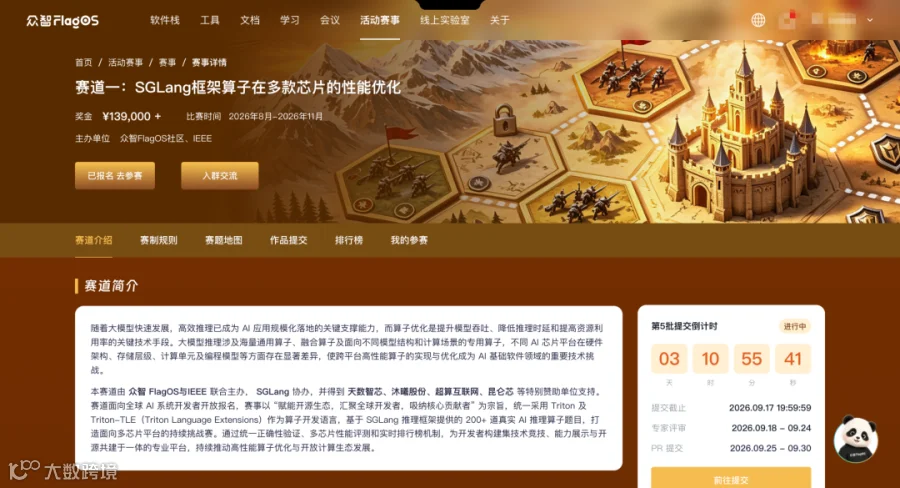
所选测试题来源截图 1: 众智 FlagOS 开放计算全球大赛赛季二的赛道一
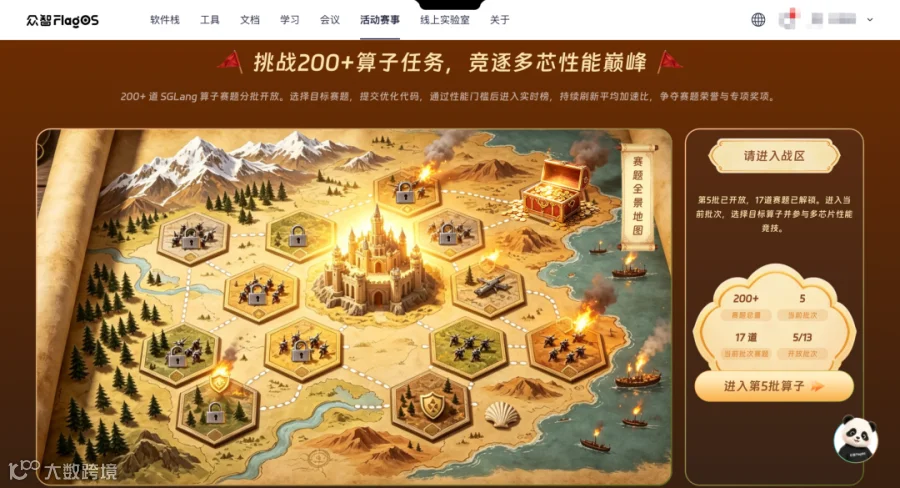
测试题目源自众智 FlagOS 开放计算全球大赛赛季二赛道一:SGLang 框架算子在多款芯片的性能优化。该赛事每周发布新题,涵盖 200 余道算子任务,确保测试数据未被模型预先学习,相当于一次严格的“摸底考试”。
所选测试题来源截图 2: 200+ 算子的多芯片优化任务
具体赛题为 DeepSeek-V3 解码阶段使用的融合 QKV-A 下投影算子(Task66: dsv3_fused_a_gemm)。真正的挑战在于生成的优化代码需同时适配 8 款芯片,包括国际通用芯片及天数智芯、沐曦、燧原、海光信息、昆仑芯和华为等国产芯片。
所选测试题来源截图 3: Task66-dsv3_fused_a_gemm 赛题

02

对打 Codex:入口名翻车,但性能结果并不弱

测试中,AgnesCode 使用免费模型 Agnes 3.0 Flash,对照组 Codex 使用 GPT-5.6 Sol。双方基于相同的标准化 Skill 信息,在相同环境下先编写 NVIDIA 芯片版本代码,再适配其他芯片。
运行过程显示,AgnesCode 组合在第二阶段生成代码时,经催促后最终耗时 20 分 36 秒完成任务,涵盖了语法检查、依赖校验、打包及记录更新全流程。相比之下,Codex 组合仅用 8 分 57 秒,推进更为流畅。
AgnesCode + Agnes 3.0 Flash 组合运行截图
Codex+GPT-5.6 Sol 组合运行截图
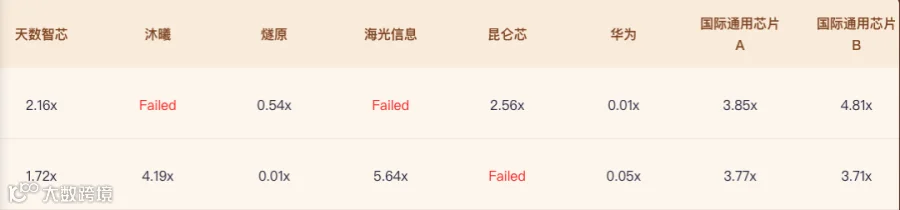
官方自动化评测结果表明:虽然 AgnesCode 在芯片适配数量上少一款(通过 6 款),但在共同通过的 5 款芯片中表现优异。在天数智芯上,AgnesCode 加速比为 2.16×(Codex 为 1.72×);在国际通用芯片 B 上达到 4.81×,高出对照组约 29.6%;昆仑芯更是仅有 AgnesCode 通过,加速比达 2.56×。
评测结果截图:第一行为 AgnesCode + Agnes 3.0 Flash 测评结果,第二行为 Codex+ GPT-5.6 Sol 测评结果。
成本方面,AgnesCode 组合完全免费。在需要多轮问答、文件读取及反复迭代的真实业务场景中,免费模型大幅降低了试错门槛,避免了闭源模型高昂的计费压力。

03

AA 榜单揭示 Agnes 3.0 Flash 的能力边界

AgnesCode 的表现是个例还是普遍现象?Artificial Analysis (AA 榜单) 数据显示,Agnes 3.0 Flash 的 Intelligence Index 得分为 36 分,接近 GPT-5.6 Luna (max) 的 38 分,表明其基础能力已与主流模型相当。
Artificial Analysis (AA 榜单) 公布数据截图
在智能表现与 Token 价格对比图中,Agnes 3.0 Flash 以约 0.03 美元/百万 Token 的价格位于帕累托前沿。其价格显著低于同等智能表现的模型,而在相近价格带中智能表现更优,极具性价比。
Artificial Analysis (AA 榜单) 的智能表现 × Token 价格对比数据截图
对于长任务的 Agent 工作流而言,这一优势至关重要。模型成本的降低直接决定了用户是否愿意让其持续读文件、改代码及反复迭代。

04

免费又不失性能,为 AI 进化带来更多探索空间

测试证明,AgnesCode + Agnes 3.0 Flash 已能自动化生成可验收、可迭代且成本可控的交付物。随着 AI 发展,用户需求已从生成应用转向让 AI 优化自身底层架构。
AgnesCode 展示了两个关键信号:首先,在明确工作流与评测反馈下,它能推进跨芯片算子适配并实现更高加速比;其次,Agent 可能在入口命名、提交规范等“最后一公里”细节犯错,这直接影响成果的系统接收度。
模型能力决定上限,工作台能力决定稳定性。AgnesCode 的优势在于将模型、项目文件、Skill 及评测反馈整合至同一工作流,帮助用户高效完成任务。对于国产 AI 芯片生态,Agent 有望将依赖人工经验的优化工作转化为可持续迭代的工程流程。
尽管 Codex 在流畅度上仍占优,但 AgnesCode 证明了免费模型同样可进入专业工作流。免费模型的真正价值,正从“让 AI 变便宜”转向“让更多真实任务有机会被反复尝试”。当试错成本下降,谁能将专业要求稳定写入执行过程,谁就将掌握下一代 AI 工作台的入口。
【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 8950
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读243.5k
粉丝0
内容8.9k