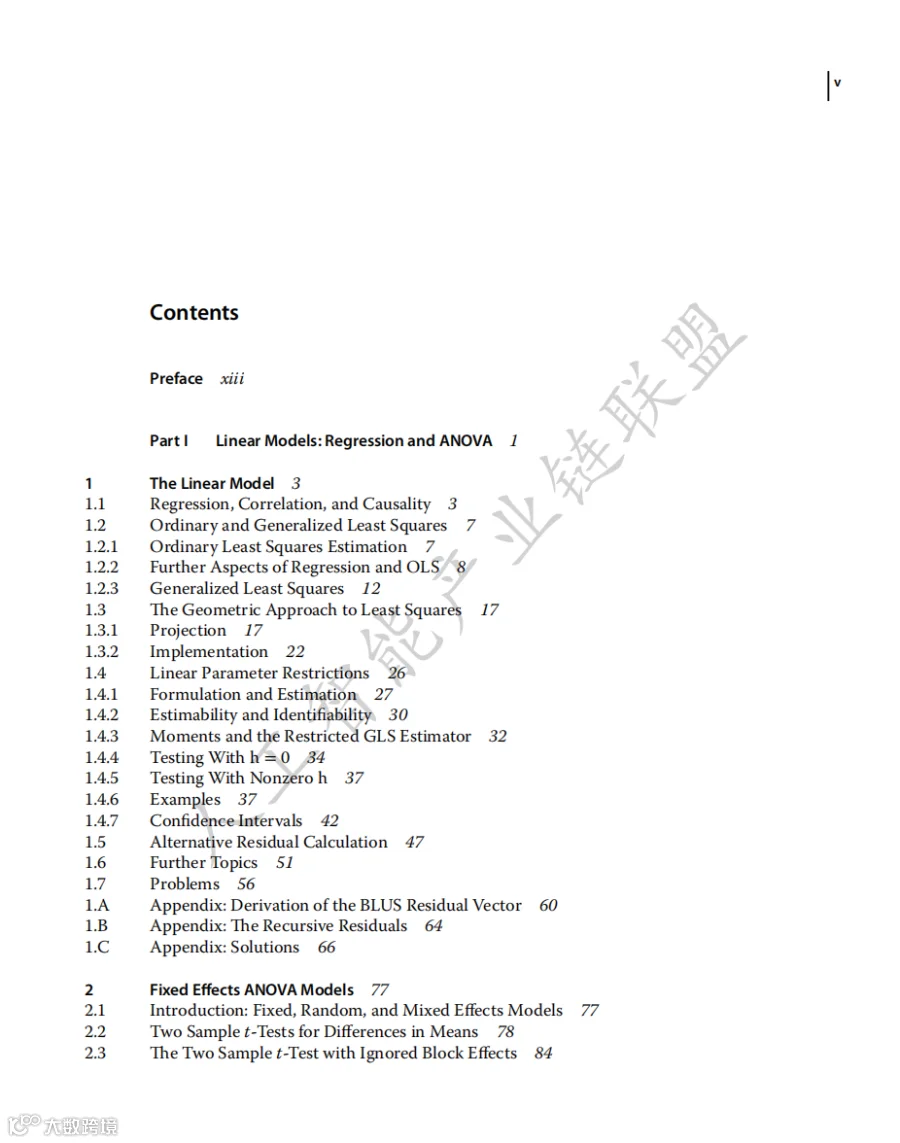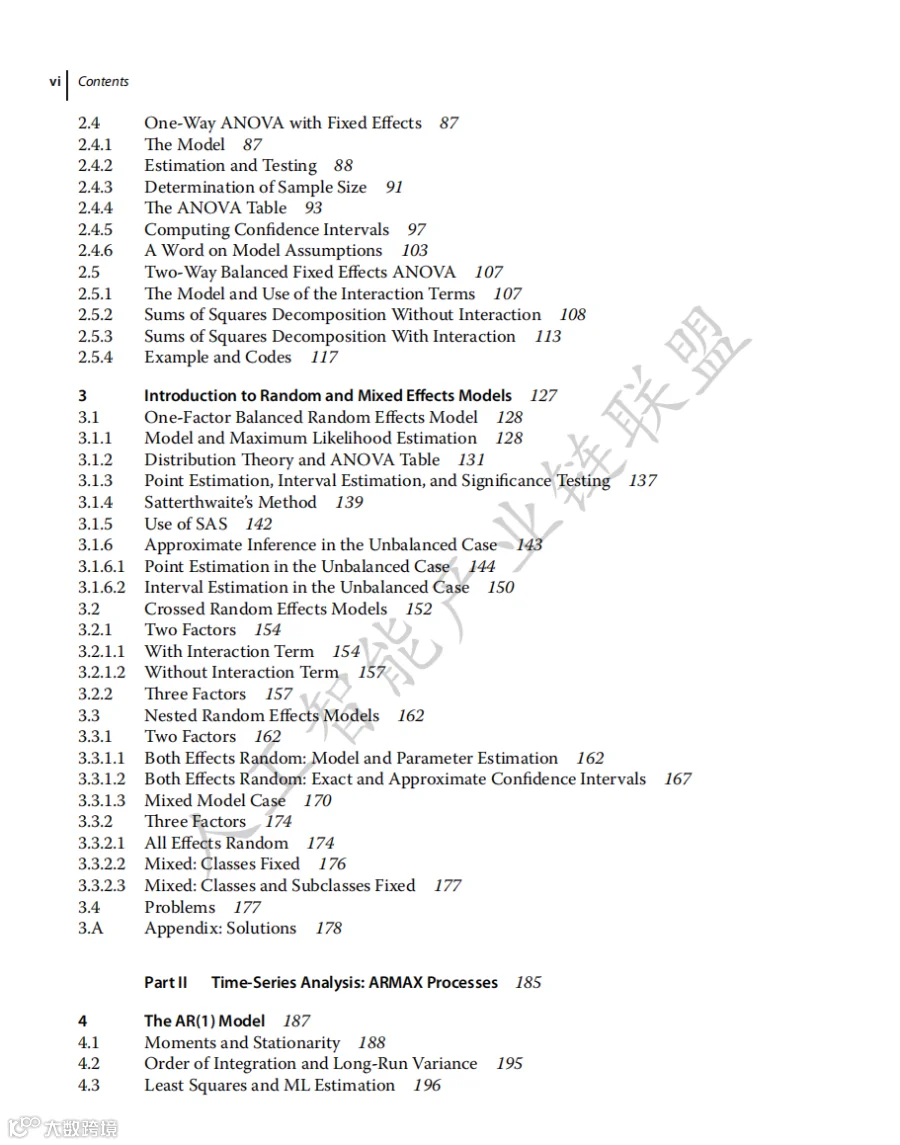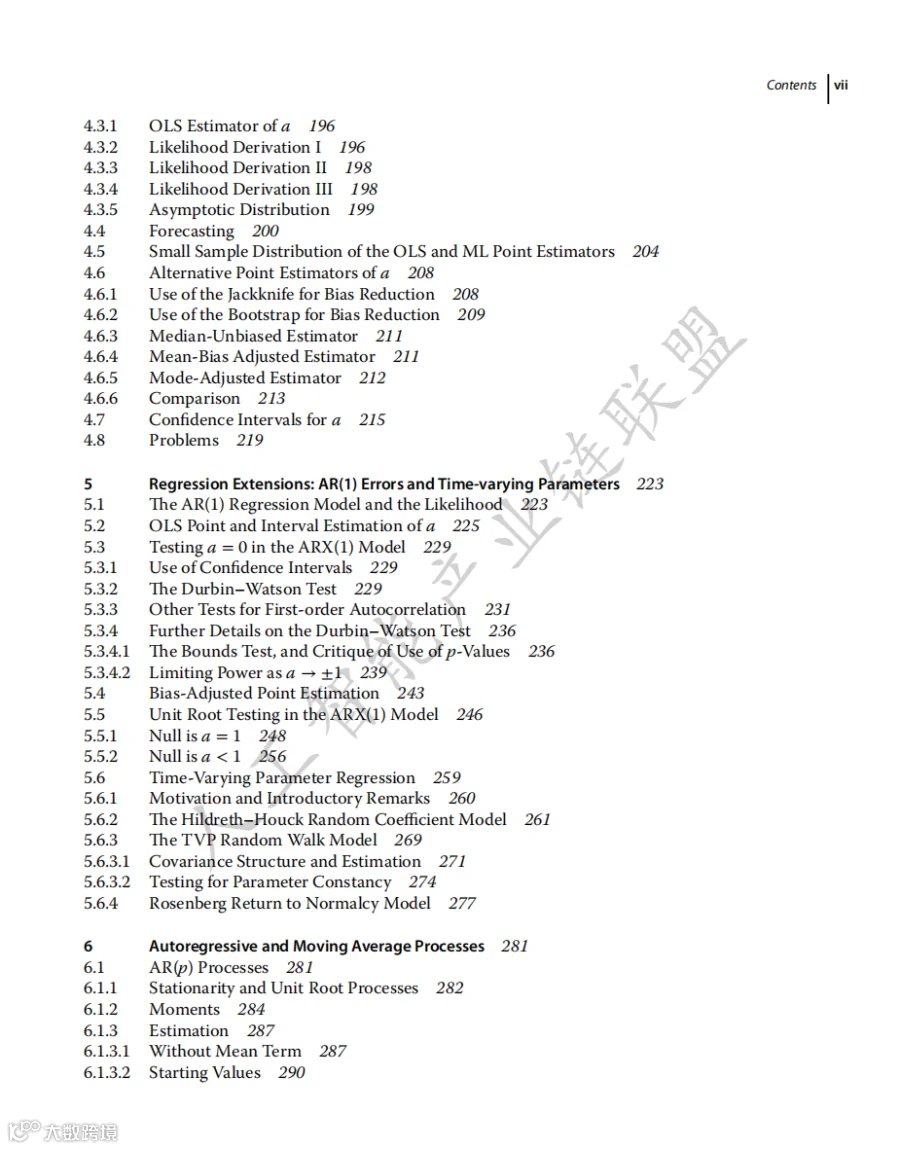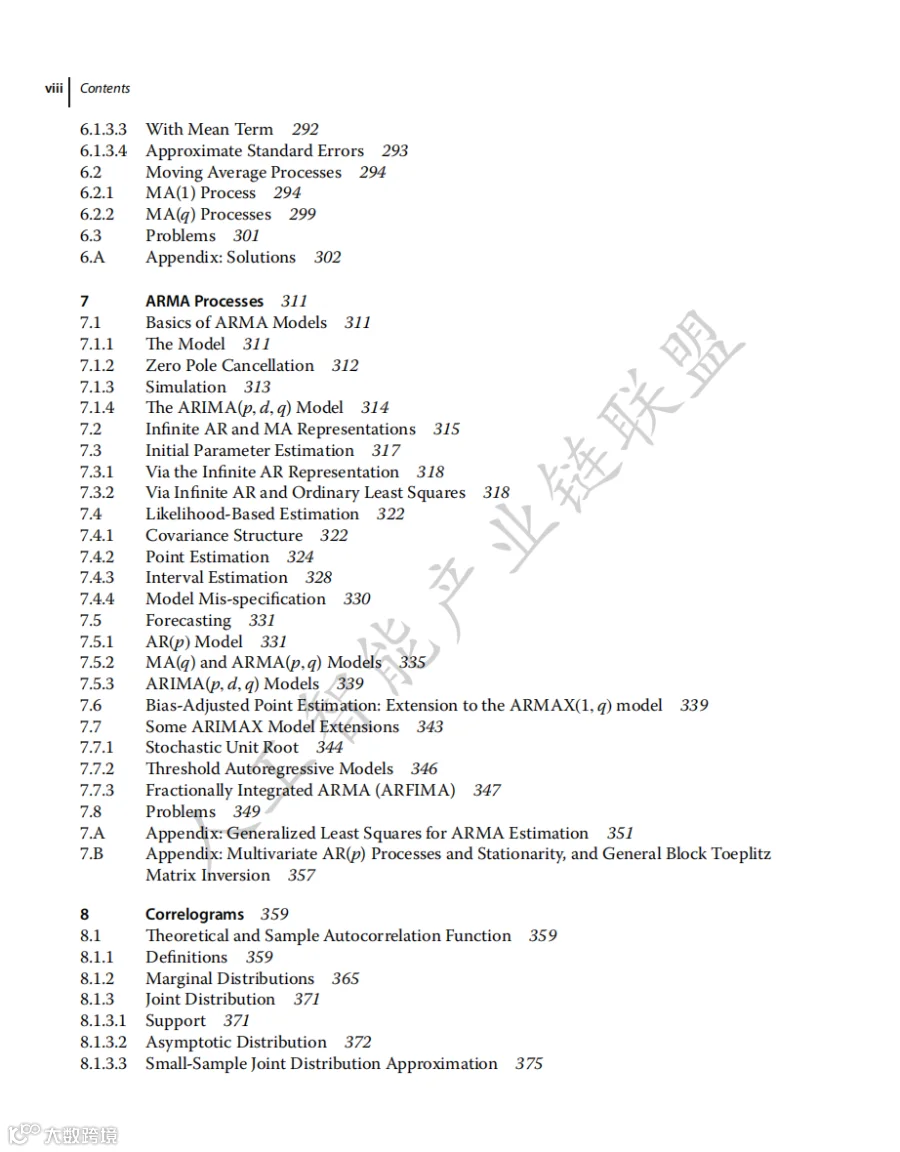
核心总结
一本揭示金融数据背后数学逻辑的专著,涵盖从股票预测到风险控制的全方位量化分析。
经济学家如何预测 GDP 增长?基金经理怎样计算市场大跌概率?信用卡审批背后的秒批秒拒机制是什么?这些问题的核心,皆指向一门统计学利器——“线性模型与时间序列分析”。
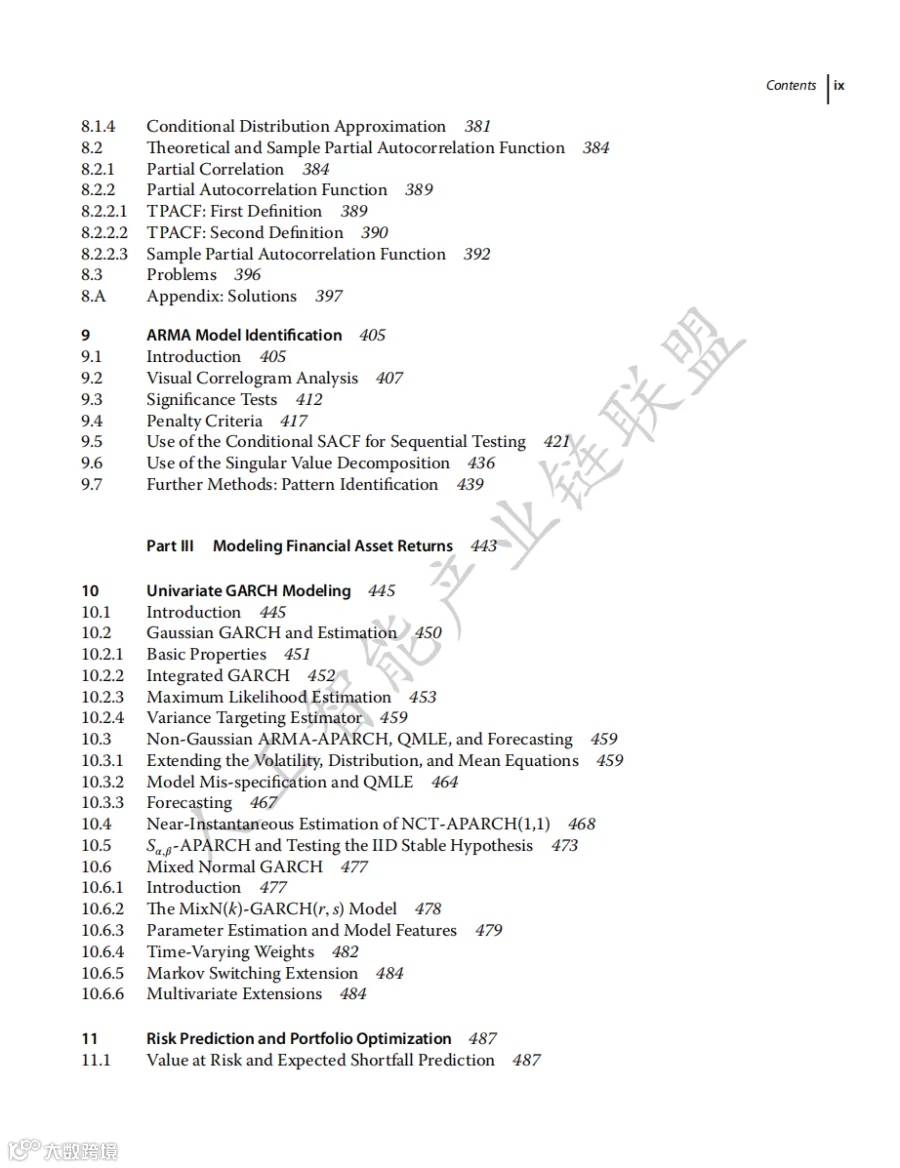
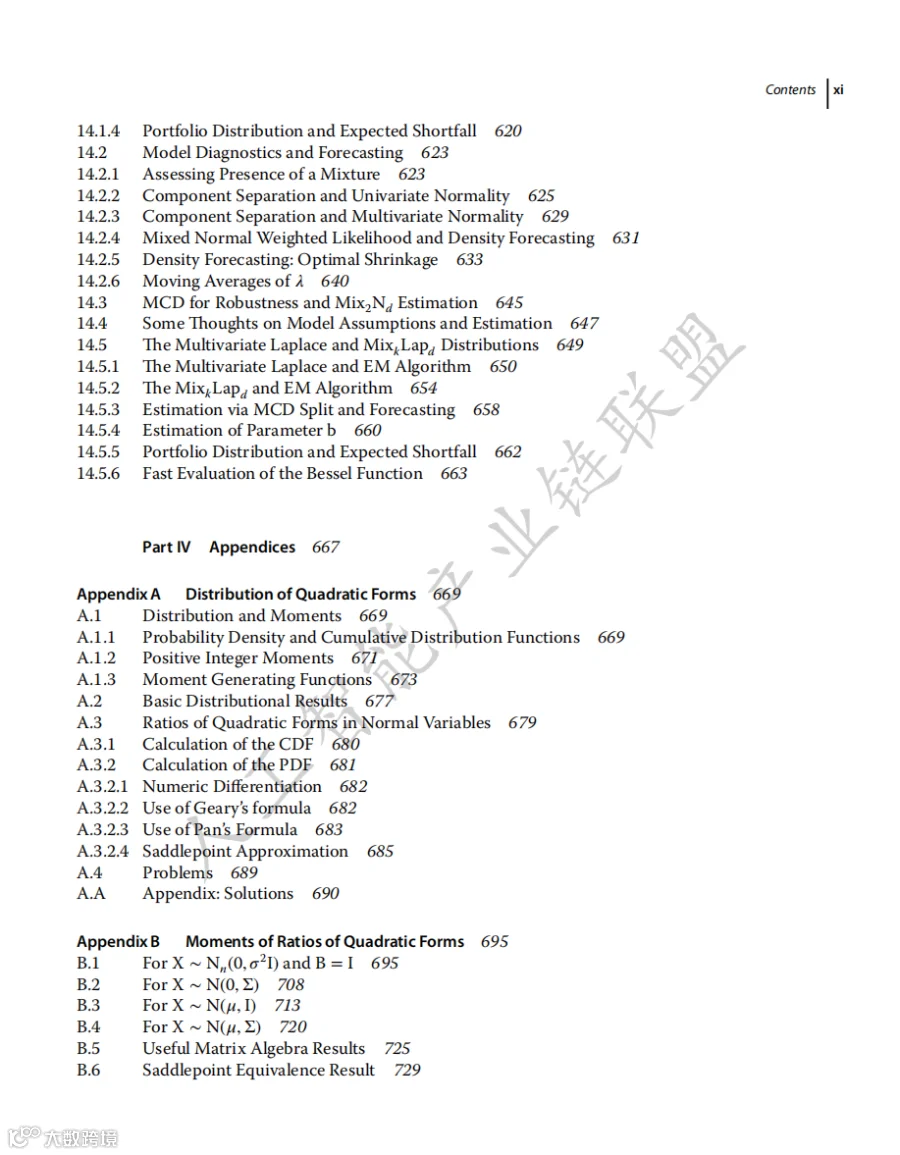
本文深度拆解 Marc S. Paolella 教授的巨著《Linear Models and Time‑Series Analysis: Regression, ANOVA, ARMA and GARCH》。该书不仅是量化金融、经济学及统计学硕博研究生的必读“生存手册”,更通过严谨的推导与实战案例,阐述了数据背后的因果逻辑。
一、回归分析:最小二乘法的几何视角
1. 回归的本质
回归分析旨在寻找一条直线,使所有数据点到该线的垂直距离平方和最小,即最小二乘法。书中从矩阵与投影的几何视角出发,阐释了如何通过引入多个自变量(如年龄、教育、性别)来控制干扰因素,从而挖掘真正的因果关系,并强调“相关不等于因果”的核心原则。
2. 广义最小二乘(GLS)的应用
针对时间序列数据中常见的“异方差”和“自相关”问题,普通最小二乘法(OLS)往往失效。GLS 通过赋予不同观测值权重,有效解决了残差相互依赖的难题。书中以 AR(1) 模型为例,展示了 GLS 在处理非独立误差项时的高效性。
二、方差分析(ANOVA):多组别均值比较
固定效应与随机效应
- 固定效应:关注特定组别的差异(如三种化肥的效果对比)。
- 随机效应:关注从总体中随机抽取样本的代表性(如全国随机抽取的 20 所学校)。
书中深入探讨了单因素、双因素 ANVA 及混合效应模型。特别指出,若忽略关键分组变量(如性别),可能导致药物有效性等结论出现严重偏差。正如 Fisher 所言:“设计实验比事后分析更重要”。
三、时间序列分析:基于历史预测未来
1. AR(1) 模型与随机游走
最简单的自回归模型表明:今日数值取决于昨日数值加随机噪声。当系数接近 1 时,表现为随机游走,这是股票价格波动的常见形态。书中详细推导了其统计特性及最大似然估计方法。
2. 单位根检验与伪回归
许多经济数据具有非平稳性,直接回归可能导致两个无关变量呈现显著相关的伪回归现象。书中重点讲解了 Dickey-Fuller、KPSS 等单位根检验方法,用于区分真实关系与虚假关联。
3. ARMA 与 ARIMA 模型
ARMA(p,q) 结合自回归与移动平均,能捕捉复杂波动;ARIMA(p,d,q) 则通过差分处理非平稳数据。此外,书中还介绍了用于处理“长记忆”现象的分数阶积分(ARFIMA)模型。
四、GARCH 模型:刻画金融波动聚集性
金融市场常出现“大跌后伴随大跌,大涨后伴随大涨”的波动聚集现象。GARCH 模型专为刻画此类特征而生:
- GARCH(1,1):当前方差由常数、前期收益平方及前期方差共同决定。
- 非对称 GARCH(APARCH):反映负面冲击比正面冲击带来更大波动的杠杆效应。
- 混合正态 GARCH:通过多正态分布混合捕捉厚尾特征及时变偏度,极适合股票收益率建模。
实战应用:亚洲金融危机期间的汇率数据演示表明,简单 GARCH 模型即可精准刻画极端波动。
五、多元 t 分布:突破正态假设局限
金融资产收益率常呈现“胖尾”与“非对称”特征。书中介绍了多种多元 t 分布变体以优化拟合效果:
- Jones 分布:允许不同维度拥有不同自由度。
- FaK/AFaK 分布:利用 Copula 构造,灵活设定边际分布参数。
- MEST 分布:独立生成边际分布并通过协方差矩阵关联。
相比多元正态分布,这些模型在计算期望损失(Expected Shortfall)时更为准确。
六、风险预测与投资组合优化
1. VaR 与 ES 指标
VaR(风险价值)衡量特定置信度下的最大亏损,而ES(期望损失)则关注超出 VaR 阈值的平均亏损,更受监管机构青睐。书中对比了历史模拟、过滤历史模拟、极值理论(EVT)及 CAViaR 等多种预测方法。
2. 非正态下的组合优化
传统 Markowitz 框架依赖正态假设。本书展示如何利用混合正态模型和Copula捕捉资产间的非线性依赖。特别是单变量折叠法(Univariate Collapsing),通过将高维问题转化为单变量序列拟合,大幅降低了计算复杂度。
七、加权似然:提升近期数据权重
鉴于数据生成过程可能随时间变化,书中提出加权似然理念:通过超参数控制权重衰减,给予近期观测更高权重。实践证明,对于日收益率数据,约 250 天的最优窗口长度配合收缩估计,可显著提升预测精度。
八、混合模型:拟合厚尾与多峰分布
针对单一正态分布无法拟合的多峰或厚尾数据,混合正态模型(MixN)通过叠加不同均值和方差的成分,实现了任意形状密度的拟合。扩展至 GARCH 框架后,结合时变权重与马尔可夫切换机制,能更精准地捕捉波动率动态变化,广泛应用于期权定价与风险管理。
九、总结:理解不确定性的语言
本书构建了从经典线性模型到现代时间序列分析的完整桥梁。从回归、ANOVA 到 ARMA、GARCH,再到多元 t 分布与混合模型,每一步均有严谨的理论支撑,并配有可运行的 Matlab 代码。
无论是否从事理论研究,掌握这些思想均有助于避开“混淆相关与因果”、“忽略异方差”、“低估尾部风险”等常见统计陷阱。正如 George Box 所言:“所有模型都是错的,但有些是有用的。”选择正确的模型与方法,才是数据科学的核心艺术。