搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
推理端加SRAM,训练端拉大网络:Google为什么把TPU做成两颗
>
推理端加SRAM,训练端拉大网络:Google为什么把TPU做成两颗
半导体产业报告
2026-09-14
13
导读:代理型AI把推理和训练拉向两套不同的硬件约束,Google第八代TPU因而分成了8i和8t。
针对代理型 AI 将推理与训练推向不同硬件约束的现状,
Google
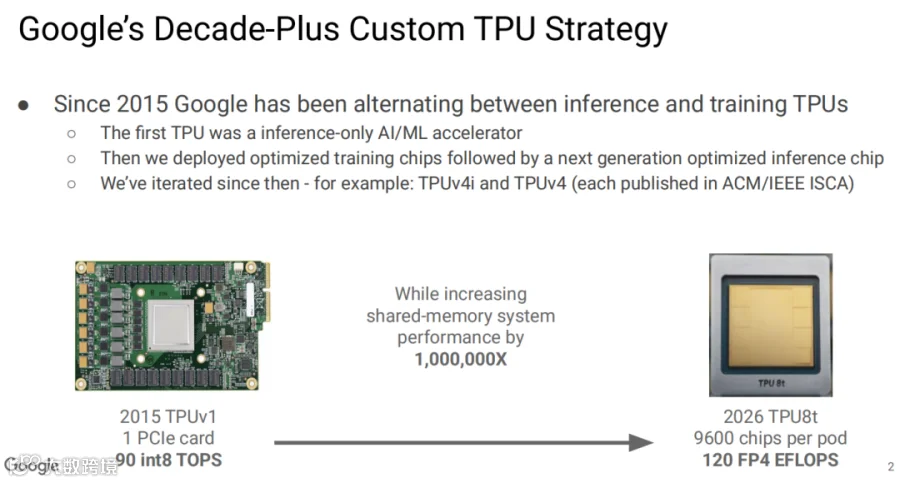
第八代 TPU 正式分化为 8i(推理)与 8t(训练)两款芯片。长上下文、推理及强化学习采样需频繁读取缓存,内存往返延迟显著影响响应
速度
。8i 通过集成 384MB SRAM 优化低延迟访问,配备 288GB HBM3E 及高速 ICI 互连;8t 则聚焦训练吞吐,单个 Sup
erp
od 由 9,600 颗芯片共享 2PB HBM。两者虽共用软件栈,但在内存架构与网络拓扑上采取了截然不同的设计策略。
384MB SRAM:重塑推理端高频读写效率
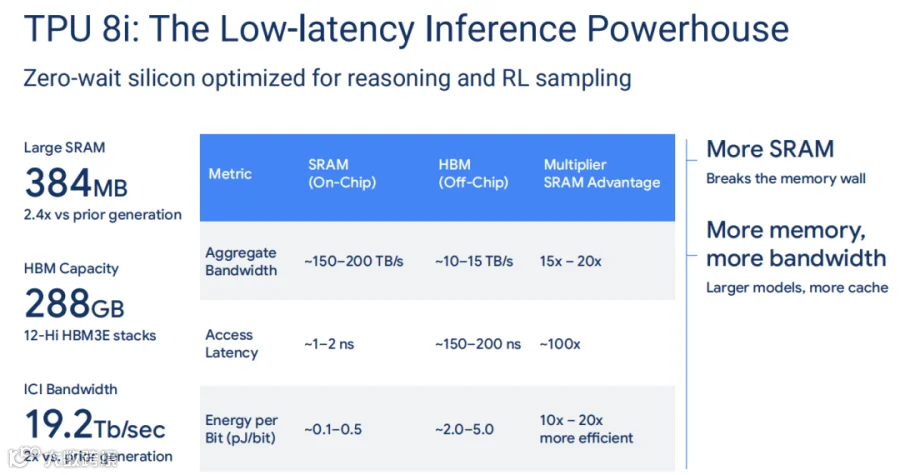
8i 内置 384MB SRAM,容量较上一代提升 2.4 倍。该设计与 288GB HBM 形成互补:HBM 负责承载大模型参数与缓存容量,SRAM 则紧邻计算单元,专门处理推理过程中反复读取的热数据。
数据显示,片内 SRAM 聚合带宽达 150-200TB/s,访问延迟仅 1-2ns,单 bit 能耗约 0.1-0.5pJ;相比之下,片外 HBM 带宽约为 10-15TB/s,延迟高达 150-200ns,能耗也高出 10-20 倍。SRAM 的高带宽与低延迟特性,使其能有效减少片外内存访问次数,让有限的 HBM 容量专注于存储更多模型参数,实现了推理端“容量”与“速度”的解耦安排。
MoE 架构优化:缩短通信路径与片间延迟
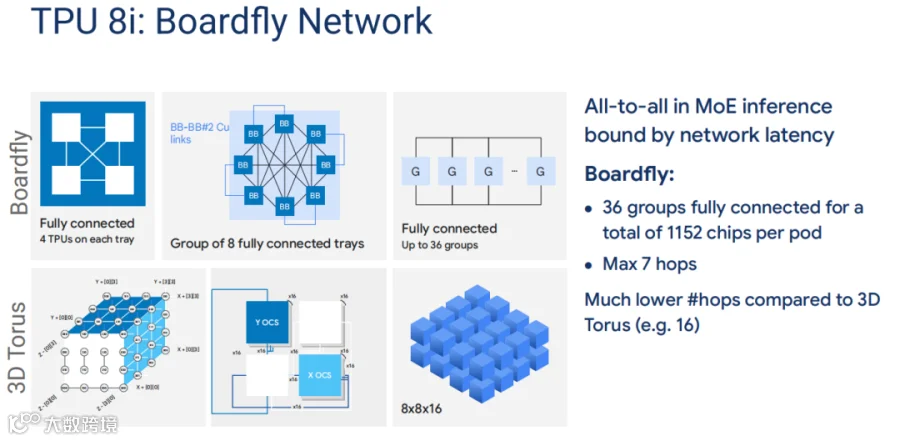
混合专家模型(MoE)的推理涉及多专家间频繁数据交换,网络延迟成为关键瓶颈。8i 引入 Boardfly 网络架构:每块托盘板集成 4 颗 TPU,8 块托盘组成全互连组,36 个组可构建含 1,152 颗芯片的 Pod,最长通信路径仅为 7 跳,显著优于传统 3D Torus 架构的 16 跳。
在集体通信场景下,8i 利用集体通信加速模块(CAE)在片间互连(ICI)的 I/O die 中直接完成部分数据汇总与对齐工作。这一设计减少了数据在封装内的绕路及回写 HBM 的次数,将片上延迟降低至原来的五分之一,实现了节点间路径缩短与片内数据处理的双重优化。
训练端革新:共享内存池与动态任务切片
8t 原生支持 FP4 低精度格式,其 Superpod 峰值算力达 121 Exaflops,是前代 Ironwood 的 3 倍,能效比提升 2 倍。单颗芯片提供 2.4TB/s I/O 带宽,由 9,600 颗芯片组成的 Superpod 将 2PB HBM 整合为统一共享内存池。
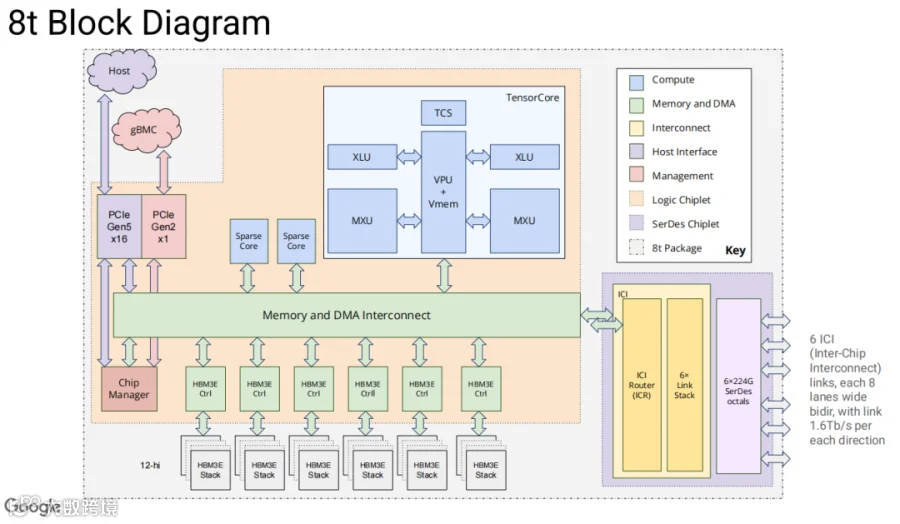
8t 封装采用 12 层堆叠 HBM3E,并引出 6 条 ICI 链路,每条链路含 8 条双向 Lane,单向带宽达 1.6Tb/s。内存容量与互连带宽被同步扩展至系统规模,使 2PB 资源能被更多训练任务高效共享。
光路交换(OCS)技术允许根据任务需求动态重组芯片连接,支持 8×8×4 和 8×8×8 等多种切片形态。训练任务可按需切分,前提是内存池中具备相应的可用资源,实现了硬件资源的灵活调度。
十万级集群挑战:散热管理与故障容错
Virgo 网络设计规模高达单集群 134,400 颗 TPU,总算力 1.6 YottaFlops,带宽 47Pb/s。在十万颗芯片量级下,单纯增加节点无法线性提升有效吞吐率,故障管理与散热成为核心制约因素。
HBM 链路引入 CRC 校验,针对不可纠正错误、奇偶校验错误及链路异常实施重试机制;
片内互连增加控制路径奇偶校验,实时监控电压、
温度
、压降及器件老化情况;
利用空闲周期进行现场测试,结合健康监控与水冷系统将故障风险降至最低。
研究表明,运行温度每升高 10-15℃,化学退化与半导体磨损速率约翻倍。8t 的托盘设计将水冷光学器件置于芯片封装旁,使散热效率、故障检测与重试机制直接决定模型训练的有效算力产出。
软硬协同:统一生态下的分工透明化
尽管 8i 与 8t 在硬件层面分别
服务
推理与训练,软件层仍保持对 Pallas、Mosaic、PyTorch、JAX 和 Keras 的兼容。Pallows 支持开发者使用 Python 编写贴近硬件的算子,Mosaic 则针对 CAE 和 SparseCore 等专用单元进行优化。XLA 编译器自动处理 Boardfly 拓扑与 CAE 同步,开发者无需在代码中显式处理网络跳数或芯片间汇总逻辑。
Google 还将 AI
工具
应用于 TPU 自身设计流程。8i 的 MXU 面积缩小 5.3%,在同等热预算下 FLOPS 提升 5%;8t 的 MXU 功耗降低 6%、面积缩小 5.8%,额外贡献 6% 的 TFLOPs。硬件虽分工明确,但软件生态致力于屏蔽底层复杂度,为用户提供统一的系统体验。
结语:通用算力的双轨演进
TPU 8 系列将“通用算力”拆解为两种系统角色:8i 凭借 384MB SRAM 与短网络路径优化推理延迟;8t 通过 9,600 颗芯片与 2PB HBM 构建可重组的训练资源池。Google 维持统一软件生态,旨在让用户感知不到硬件分工带来的割裂。
未来,训练切片将受限于资源可用性,十万级集群的吞吐率将受制于故障率与温控水平。随着代理型 AI 不断拉长上下文、增加采样频率与通信密度,内存带宽、网络拓扑与散热能力将共同定义加速器的实际工作效能。
【声明】内容源于网络
0
0
半导体产业报告
1234
内容
605
粉丝
1
关注
在线咨询
半导体产业报告
1234
总阅读
33.9k
粉丝
1
内容
605






 半导体产业报告