AI 科学家这条赛道,之前写过训模型的(Faraday 用 27B 指挥 GPT-5.5 复现论文图),也写过 Claude Science 发布后三天冒出来的开源同构版。Dr. Claw 是第三种形态:不训任何东西,只做编排层,把你机器上已经装好的 Claude Code、Gemini CLI、Codex 当执行器,在上面搭一套从综述到论文的科研流水线。
Lehigh 大学 AI 实验室(LAIR)出品,2 月建库,论文《Dr. Claw: An AI Scientist Workspace for Vibe Research》被 EMNLP 2026 系统演示轨接收,10 月底在布达佩斯现场演示。

Research Lab 视图:任务、工件、来源论文和五个阶段的进度一屏看全(图源:Dr. Claw 官网)
01它产出什么
五段流水线,每段落一类结构化工件:
- ▪综述
:带引用的文献综述,来源 arXiv、Semantic Scholar 和网页 - ▪选题
:头脑风暴产出,用 SCAMPER、SWOT 这类框架,多人格打分 - ▪实验
:plan → implement → judge 循环出来的代码,加统计分析、表、图 - ▪论文
:IEEE / ACM 格式的稿子,带引用和 LaTeX 公式,含同行评审、humanization、引用审计、Overleaf 同步 - ▪宣传
:slides、TTS 旁白、demo 视频、项目主页
注意"论文"这段里公开写了 humanization(人性化处理)这一步,官网原词。放在学术投稿语境里,它直接触碰 AI 辅助写作的披露规范,读者自己判断。
02论文怎么定位自己
论文摘要第一句就划清界限:它包住现有编程 agent 执行器,放进一个可控、可审计的人机回环里,而非再造一个自主 agent。理由是现在的 coding agent 优化的是执行,不是控制:计划、中间决策、工件散落各处,人几乎没有明确的接管点。

论文图 1:人控制的一侧定目标、约束和验收,AI 执行的一侧跑五个核心操作,中间靠四个状态对象和检查点反馈连起来(图源:arXiv 2609.00365)
架构上是三层加四个状态对象。四个状态对象:任务图、工件库、决策日志、执行轨迹,每次交互就是一次状态转移,人的每个决定都被记录、能回溯。三层:交互层(工作区、对话、版本)、编排层(会话状态、任务生命周期、映射)、执行层(agent 后端、API 调用、异常处理)。换后端不改工作流语义,这是它能同时接 Claude Code、Gemini CLI、Codex 和 OpenRouter 上几百个模型的原因。
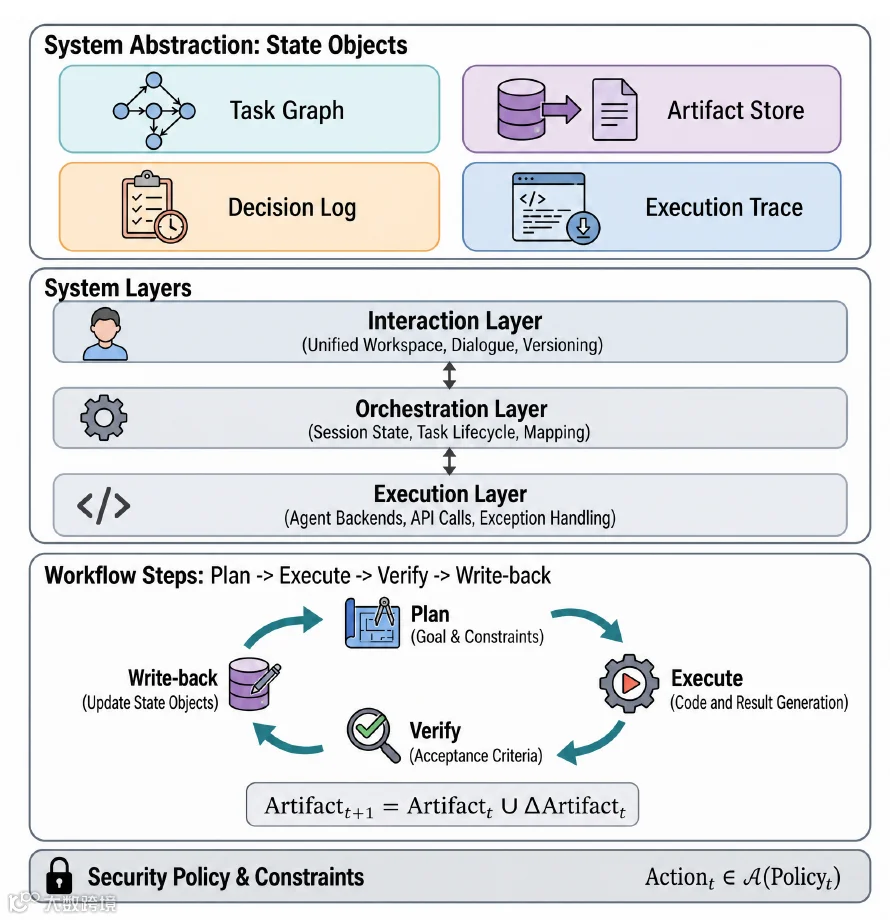
论文图 2:四个状态对象、三个系统层、Plan → Execute → Verify → Write-back 循环,最底下是安全策略约束(图源:arXiv 2609.00365)
skill 库是另一半。部署的目录里有 171 个 skill,87 个是带自己 SKILL.md 的顶层条目,三个自家系列占大头(aris-* 44 个、inno-* 16 个、ds-* 14 个),其余从公开集合导入。按阶段映射了 58 个:综述 11、选题 14、实验 18、论文 22、宣传 3。skill 进任务有三条路:阶段映射自动挂、关键词自动加载、用户手动调。
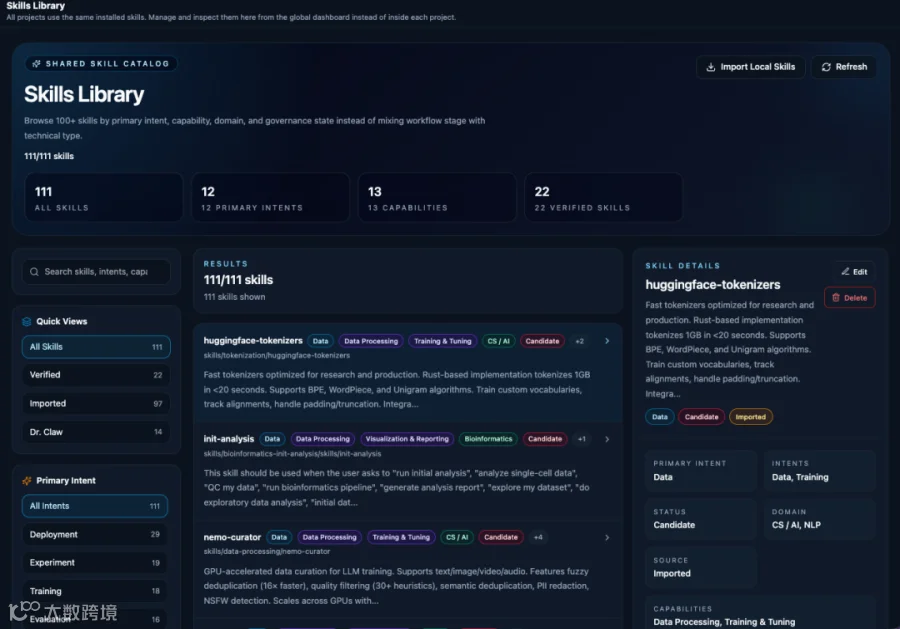
Skills Library:111 个已装 skill,按意图、能力、领域和治理状态筛,22 个标了已验证(图源:Dr. Claw 官网)
03论文里的数字,和作者自己标的限制
评测设计值得看一眼:固定同一个执行器(codex 后端,gpt-5.4,同样的全权限配置),对比裸 codex 和包了 Dr. Claw 的 codex,两边只差任务图、工件库、决策日志、执行轨迹和 skill 库这一整包。三个医学任务(Derm7pt 上的黑色素瘤和痣分类、一个临床笔记风险基线),同一句不列清单的指令"做一个严谨的、可发表水平的研究",按 21 项研究最佳实践打分,全部对着产出文件确定性判分,不用模型当裁判。
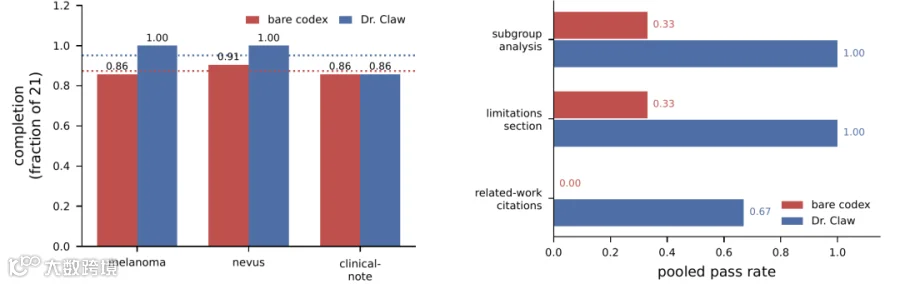
论文图 4、5:三个任务的完整度,以及三项"研究卫生"元素上两边的差距(图源:arXiv 2609.00365)
结果:Dr. Claw 三个任务赢两平一,合并完整度 0.952 对 0.873。差距全在"研究卫生"上:limitations 一节从 0.33 到 1.00,子群分析 0.33 到 1.00,真实文献引用 0.00 到 0.67,裸 agent 三个任务一条引用都没写。建模那些项(多模型、交叉验证、校准、消融、统计)两边都是 1.00。
作者自己写了三条限制。一,每个任务只跑一次,合并差值 +0.079 的 95% bootstrap 置信区间是 [−0.00, +0.14],包含零,方向一致但不显著。二,skill 的"选择"是确定的,"调用"不强制,解析器只能把建议放进任务提示,唯一平局的那个任务就是引用审计 skill 没触发。三,Dr. Claw 更慢,编排层记状态有固定开销。可审计性那部分他们也明说是架构特性不是分数,"裸 agent 什么都不留"是格式决定的。
另有一个 7 位 AI 方向博士生的回顾性人类研究,三个阶段对比无 AI、通用 AI 助手和 Dr. Claw,Dr. Claw 在完成时间段、盲评质量、工具切换次数和体验分上占优,只有体验分做到了两两显著。
04一处张力
论文说"不做自主 agent",README 的 Auto Research Hub 又写"一键全自动跑完整管线,边睡边跑,跑完发邮件",还能挑 ARIS、Autoresearch、DeepScientist 三种工具包。两种口径并存。我的读法是:人机回环是架构,全自动是架构上的一个开关,状态对象都在,随时能接管。但引用它的时候别只挑一头。
05装起来
npx dr-claw
打开 http://localhost:3001 建账号就能用。前提是 Node.js 20 以上(推荐 22),本机装好至少一个 CLI:Claude Code、Gemini CLI 或 Codex。想从源码跑:
git clone https://github.com/OpenLAIR/dr-claw.git cd dr-claw && npm install && cp .env.example .env npm run dev
也有桌面版 .dmg / .exe(beta)、纯终端模式 dr-claw chat、Claude Code 插件,还有 OpenClaw 接入,用 drclaw --json 当控制面,摘要和主动提醒推到飞书,手机上语音管科研。News Dashboard 除了 arXiv、HuggingFace、GitHub trending,还接了微信公众号(走 RSSHub)、X 和小红书。

Project Dashboard:多项目进度、token 用量和 Auto Research 状态(图源:Dr. Claw 官网)
06放到赛道里看
README 有段话很冲:Anthropic 6 月 30 日发 Claude Science,Dr. Claw 注明"同一愿景我们从 2 月就在发货",全开源、模型无关、跑在自己机器和 GPU 上、覆盖全生命周期、免费。之前写过的 openscience 是 Claude Science 发布三天后上线的开源同构版,OpenAI4S 用 9.9 元豆包复刻,走的是 Code-as-Action 省 token。Dr. Claw 比它们早,也比它们重:多了任务图、状态对象、决策日志这一层,代价是慢。
三种形态各押一头:Faraday 押模型的科研品味,openscience 和 OpenAI4S 押便宜和模型无关,Dr. Claw 押"过程可审计"。它没答的题是,171 个 skill 谁来验证有效,论文里那个没触发的引用审计就是例子。
Dr. Claw 证明的一件事:harness 层能长出整个科研流程,不用动模型。
项目地址项目主页:https://openlair.github.io/dr-claw/GitHub:https://github.com/OpenLAIR/dr-claw论文:https://arxiv.org/abs/2609.00365npm:https://www.npmjs.com/package/dr-claw