这两天,各大科技交流群和朋友圈里,关于“FDE(Forward Deployed Engineer,前线部署工程师)模式在国内是否水土不服”的讨论异常激烈。有朋友认为,国内企业服务市场环境复杂,客户定制化需求多,传统的FDE模式不仅人力成本极其高昂,而且在缺乏标准化SaaS土壤的国内市场,极其容易演变成高端的“驻场外包”,最终拖垮企业的利润率。
这种担忧并非空穴来风。FDE模式的鼻祖Palantir,早年也曾因为高度依赖顶尖工程师深入客户现场解决复杂数据问题,而被华尔街诟病为“伪装成软件公司的咨询公司”。然而,当我们还在探讨人力驱动的FDE模式如何降本增效时,大洋彼岸的Palantir实际上已经给出了他们的解法:用AI重塑FDE。
近期,我们深度解析了Palantir内部关于其最新力作AI FDE的技术演示与架构剖析。这款产品并非一个简单的“套壳大模型”或者聊天机器人,而是一个深度嵌入其Foundry数据操作系统、能够通过自然语言指令自主调用百余种工具执行复杂数据工程的AI智能体。
它将顶尖数据工程师的专业知识、底层平台的API接口以及大模型的推理能力结合在了一起。本文将剥丝抽茧,从底层逻辑、工具链编排到端到端的实战案例,全面解析AI FDE是如何在实际业务中运作的,以及它将如何重构未来的数据工程流。
一、 什么是 AI FDE?不只是对话框,而是“系统操作员”
传统的AI助手通常扮演的是“副驾驶(Copilot)”的角色,为你生成代码片段或提供咨询建议,最后仍需要人类工程师去复制、粘贴并执行。而AI FDE的定位则发生了根本性的转变:它是一个交互式的智能代理,能够直接代替人类在Foundry平台中进行操作。
无论你是在构建数据管道、设计企业级 Ontology、开发上层应用程序,还是编写复杂的后台函数,你只需要按下快捷键呼出AI FDE界面,它就能接管后续的大量繁杂工作。
为了实现这种“行动力”,AI FDE的底层架构建立在两个绝对核心的支柱之上:强大的工具库与精准的上下文控制。
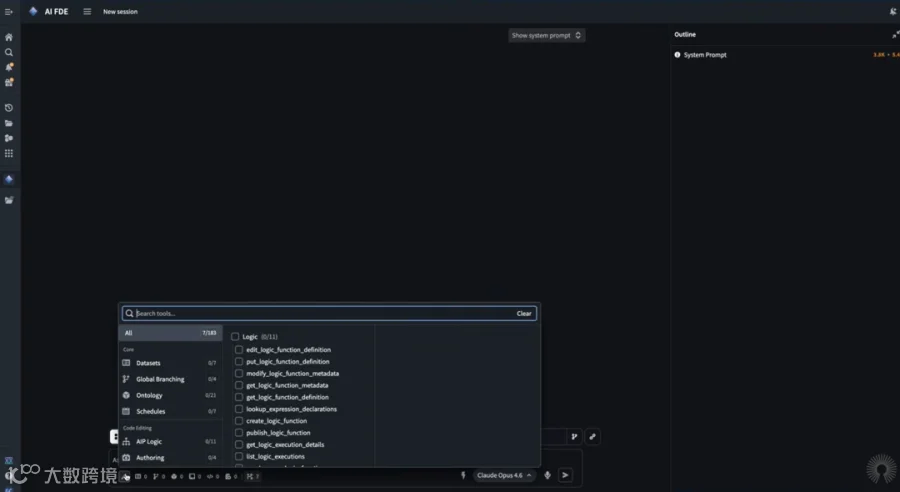
1. 赋予AI行动的“手脚”:183+ 工具库
大语言模型本身是不具备系统操作能力的,必须通过函数调用与外部环境交互。AI FDE之所以强大,在于Palantir为其开放了极高权限且颗粒度极细的API工具集。
目前,AI FDE内置了超过183种工具(且数量仍在持续增长中)。这些工具覆盖了数据平台的各个生命周期,主要包括:
数据集操作:读取、查询、写入、Schema变更等。
全局分支管理:保证AI在隔离环境中工作,不破坏生产环境。
Ontology 管理:创建和编辑对象(Objects)、链接(Links)、动作(Actions)。
代码与工程流:代码库管理、代码工作空间操作、编写AIP Logic函数。
核心组件集成:能够直接操作Contour(数据探索工具)、Pipeline Builder(管道构建器)以及Workshop(应用搭建工具)。
除此之外,还包含了大量用于特定场景的杂项工具(如处理调度任务、管理Egress策略等)。正是这些工具,构成了AI FDE能够真正在系统中“干活”的物理基础。
2. 划定AI思考的“边界”:强大的上下文机制
在企业级数据环境中,如果不给AI划定范围,让其在一个包含数百万张表和代码库的系统中大海捞针,不仅效率极低,而且极易引发“幻觉”甚至越权操作。因此,“上下文”是AI FDE运作的另一大核心。
第一,指明信息的来源。工程师可以通过界面,将特定的项目文件夹、数据集、代码库、Contour分析报告,甚至是本体定义(对象类型、接口等)、凭证和权限配置一键拖入或添加到上下文窗口中。这相当于给AI戴上了“手电筒”,让它只照亮当前任务需要用到的数据资产。
第二,划定执行动作的场所。如果你要求AI FDE帮你编写一个数据清洗脚本,它必须知道要把代码写在哪里。通过上下文指定目标文件夹或代码库,AI就知道它的“工作台”在何处。
值得一提的是工程安全性设计。AI FDE绝对不允许直接在主分支上执行任何修改。平台强制要求它在支持全局分支的工具中创建全局分支,或在不支持的工具中创建本地分支。只有经过人类工程师的Review和合并后,变更才会生效。
此外,AI FDE还允许用户在运行时切换底层大模型(例如从默认模型切换到GPT架构的其他版本),并提供了从“无思考”到“深度思考”的不同模式,甚至支持语音录入,最大程度适应不同的开发场景。
二、 智能体编排:从单一任务到复杂工作流
面对183种工具,人类工程师如果每次都要手动告诉AI“你应该先用工具A,再用工具B”,那效率依然低下。为此,AI FDE引入了“模式”的概念。
你可以将“模式”理解为针对特定任务场景打包好的工具包与子智能体编排逻辑。当选择某种模式时,系统会自动为AI加载数十种相关工具,使其能够专注并高效地完成该领域的任务。
系统内置了多种核心模式,涵盖了数据工程的方方面面:
1. 核心大脑:“生成计划”子智能体
在解决复杂问题时,AI FDE并非一上来就盲目敲代码。它内置了一个被称为“Generate Plan”的子智能体。在这个阶段,它充当了“系统架构师”的角色。 它会接收用户的输入,评估当前的上下文和可用工具,然后独立进行推理,并输出一份结构化的执行计划(例如:第一步需要做X,第二步做Y,最后做Z)。这份计划将指导后续的执行步骤。这在企业级应用中至关重要,因为它允许人类工程师在消耗计算资源和修改系统之前,先审查并同意或修改AI的规划蓝图。
2. 数据转换模式
专用于将原始数据集处理成干净的标准数据。该模式下,AI会自动挂载27个相关工具。用户还可以微调该模式的策略,例如:
选择使用Python Transforms还是可视化的Pipeline Builder。
选择传统的代码编写方式还是新型的Code Workspaces。
高级设置中甚至可以允许其在转换数据的同时,直接创建本体对象和链接。
3. Ontology 修改模式
用于构建企业级语义层。无论是创建新的业务实体(如“门店”、“设备”),还是定义动作与数据流转链路,该模式都能轻松搞定。(注:出于安全考虑,该模式默认关闭了删除权限,需手动开启)。
4. 其他垂直领域模式
函数编写:支持AIP Logic、TypeScript V1/V2以及Python语言。
探索模式:允许AI跨本体、数据集、函数和文档进行深度搜索。这通常作为其他操作的前置条件,帮助AI搞清楚数据是如何关联的。
应用开发:相比于人类开发者在本地IDE配置环境、利用Copilot逐行“Vibe Coding”,该模式让工程师更像是一个产品经理,只需要把控开发进度,AI FDE会在代码库中自动搭建并完善React应用。
机器学习:无缝对接Model Studio或采用Pro-code方式进行模型训练,挂载了专用的37种工具。
系统设计的一个亮点是:在实际对话中,如果用户直接提出需求,AI FDE具备自主判定能力,能够自动切换到最合适的模式,甚至在一次长程任务中动态切换多个模式。
三、 实战演练:端到端的数据清洗与持续集成
理论需要落地验证。为了清晰展示AI FDE的能力,我们来看一个典型的日常数据工程场景:脏数据的探索与清洗。
假设我们有一组关于某连锁攀岩馆运营状况的原始数据集,数据存放在指定的文件夹中。我们需要了解这些数据的结构,并对其进行清洗,以便后续接入BI大屏或构建业务本体。
首先,工程师将包含这些数据的项目文件夹直接拖入AI FDE的Context中,并输入指令:“告诉我这些数据是关于什么的?它们之间存在什么关系?需要进行哪些清理工作?”
接收到指令后,AI FDE请求并自动切换模式,开始扫描文件夹中的数据集。注意,它并不是简单地读取元数据,而是真正像数据分析师一样开始写SQL查询。 通过调用Dataset SQL Query工具,AI不断地测试这些表。在后台的“思考过程”面板中,我们可以清楚地看到AI正在查询行数、NULL值分布、唯一值等指标。 在这个过程中,AI甚至可能会写出报错的烂SQL,但它具备强大的纠错能力,能够根据报错信息迅速调整语法,重新尝试,直到获取正确结果。
经过片刻的运算,AI FDE输出了详细的诊断报告:
业务总结:梳理出了核心数据集(如:场馆 gyms、会员资格 memberships、员工 staff、事件等)。
基数与关系网络:推断出了不同表之间的关联(如 1对多 关系),甚至验证了Join操作是否能干净地闭合,并在界面中生成了直观的图表(Graph)关系结构。
数据质量诊断:精准定位了需要清洗的具体问题。例如:
Step 2:一键转入代码工程阶段
确认了诊断结果后,工程师只需简单回复一句:“太棒了,执行必要的清理修复工作。”
此时,AI FDE迅速将自身模式切换为“Transform Data(数据转换)”,并默认选择了Python语言路径。由于它在之前的上下文中已经掌握了项目的目录结构,它自动定位到了存储代码的合适文件夹。
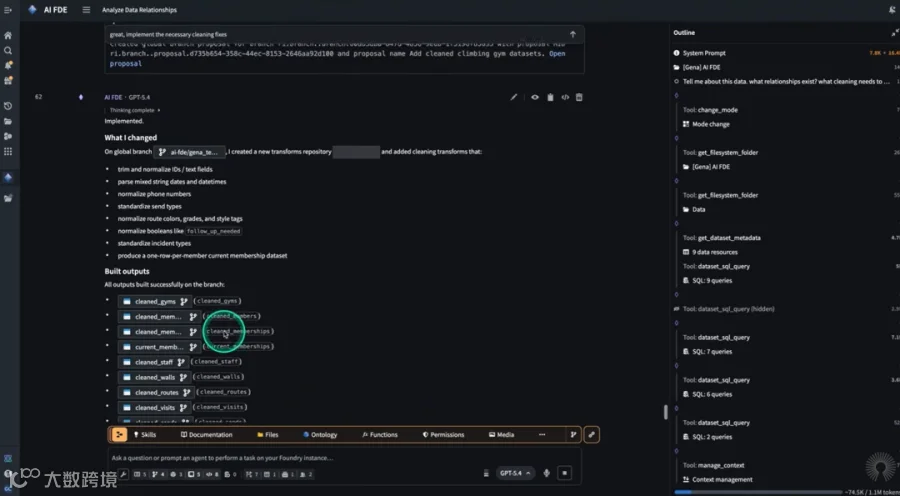
接下来是展现其企业级架构素养的时刻:它并没有直接覆盖原有数据,而是向系统申请创建了一个全局分支。在工程师点击“允许”后,AI开始化身为一名全职程序员,飞速在分支中创建文件并编写数据处理算子。
Step 3:持续集成与PR合并(CI/CD流)
在AI敲击代码的过程中,由于系统高度并行化,我们可以看到它已经开始对清洗后的数据集(如 clean_memberships, clean_gyms)进行输出预览。
几分钟后,AI FDE完成了代码编写。但工作并未结束,它紧接着触发了企业级软件开发标准的流水线作业:提交代码;运行检查:触发底层的CI/CD流,进行代码规范和依赖项检查;构建输出:向平台发送构建指令,真正执行刚才编写的清洗逻辑,生成清洗后的数据物理表。
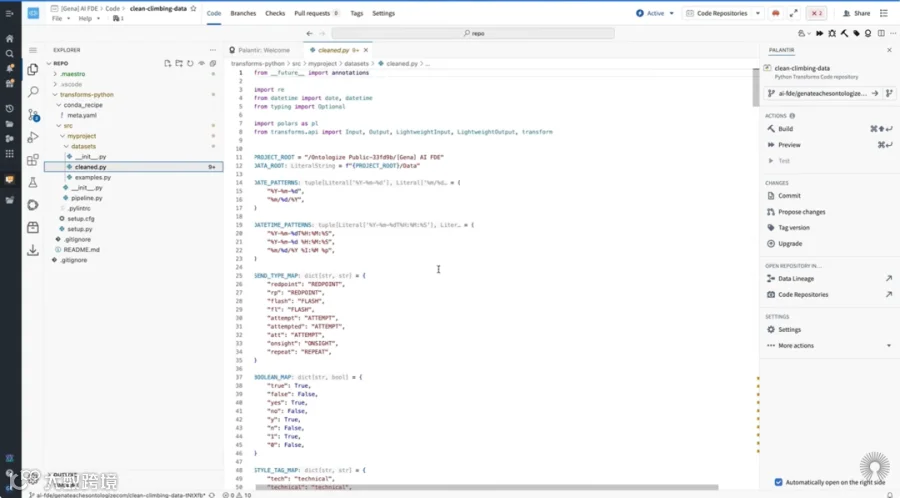
在这个环节,如果作为技术负责人的你点开代码库查看,会发现AI在 clean.py 中编写了大量严谨的映射函数来处理那些杂乱无章的字段。虽然一个资深人类工程师可能会为了后期维护,将这些函数拆分到多个不同的文件中,但AI选择了将其集中在一个文件里:这或许是审美风格的差异,但从功能性和健壮性上来看,无可挑剔。
最后,AI FDE做了一件让所有程序员都感到“贴心”的事:它发起了一个变更提案,并且自动编写了逻辑清晰、格式工整的PR描述文档(这通常是人类工程师最讨厌写的文字工作)。
在这个流程的最后,人类工程师重新登场。确认数据构建成功、代码逻辑无误后,工程师点击“Merge Proposal(合并提案)”。至此,一个从脏数据到标准规范数据的完整闭环,在人机协作下高效完成。
值得强调的是,AI FDE生成的所有资源,无论是清洗代码、配置还是管道链路:与人类工程师手写的没有任何区别。它们不是不可触碰的黑盒,如果未来业务逻辑发生变化,人类工程师完全可以像接手同事的代码一样,进去做任何“外科手术”级别的修改。
四、 结语:AI FDE 带来的不仅是效率提升,而是范式转移
回顾开头的讨论,FDE模式之所以被认为在国内会“水土不服”,本质原因是“高度非标准化环境与昂贵人力成本之间的矛盾”。当企业需要解决深度的、非标准的数据融合问题时,就必须派驻最懂系统、最懂架构的精英工程师去“脏活累活”一把抓,这种模式注定无法大规模低成本复制。
而AI FDE的出现,其实是在技术底座上进行了一次降维打击。
它并没有消灭FDE这个岗位,而是极大地降低了数据工程的边际交付成本。一个初中级数据工程师,或者一个懂业务但不精通Python和复杂系统架构的业务系统分析师,只要掌握了自然语言的“咒语”以及AI FDE的编排逻辑,就能爆发出堪比资深FDE的战斗力。
AI承担了探索数据结构、编写重复清洗逻辑、跑CI/CD流水线、写文档这些耗时且容易出错的“苦力活”;而人类工程师则被彻底解放,回归到业务逻辑判断、架构规划以及最终的审查把关上。
如果说过去十年,企业数据中台建设的痛点在于“人与复杂系统的艰难磨合”;那么AI FDE所展示的未来则是:系统本身长出了手脚和大脑,主动向人类的需求靠拢。面对这种维度的进化,或许我们应该担心的不再是某种商业模式是否会“水土不服”,而是我们现有的数据工程团队,是否已经做好了迎接“智能体同事”的准备。
提醒:请朋友们将“智见AI视界”加“星标”,觉得写得好就点击右下角“拇指”和“收藏”哦,不然会慢慢收不到文章推送~
关联阅读
Palantir AI FDE如何重构三一工业资产审计范式
从概念验证到生产力革命:Palantir AI FDE如何让工业巨头实现“代码自由”?
别再抄FDE模式了,Palantir已放出王炸:AI FDE
FDE 火了:Palantir 十八年前发明的岗位,为什么突然成了所有 AI 公司的标配
Palantir FDE 深度解析:是一场营销游戏,还是软件工程的革命?