

哈喽,大家好~
今儿和大家非常详细的聊聊,统计检验方法中的贝叶斯检验~
我们在机器学习和实验分析(比如 A/B 测试)里,经常会遇到“哪个更好?”、“差异显著吗?”这种问题。
传统的频率派检验(p-value / t-test / 卡方)回答的是“如果零假设为真,观察到像现在这么极端(或更极端)的结果的概率是多少?”,
而今天要分享的,贝叶斯检验直接把不确定性放在参数上,用数据去更新我们的信念,输出我们真正想要的东西:参数的后验分布、两个方案哪个更好的概率、以及贝叶斯因子(Bayes Factor)来衡量证据强度,一次性和大家聊清楚~
贝叶斯检验核心逻辑
先有“先验”(Prior):对参数,如转化率 p 的初始信念。先验可以是很平坦的(表示无知),也可以是经验先验(表示已有知识)。
再有“似然”(Likelihood):数据是如何生成的(例如点击/不点击服从伯努利 / 二项分布)。
贝叶斯公式把先验和似然结合,得到“后验”(Posterior):这是在看到数据后你对参数的更新信念。
贝叶斯检验常见的输出:
-
后验分布:完整的参数不确定性表示(比如 p 的分布)。 -
两个方案哪个更好的概率:直接计算 。 -
置信区间的贝叶斯版本——可信区间(credible interval):比如 95% 的后验质量落在哪个区间。 -
ROPE(Region of Practical Equivalence):若差异在一个“可忽略”的范围内,我们就认为实际上二者等效。 -
贝叶斯因子(Bayes Factor):衡量数据对两种模型/假设的支持比例。比如 M1(两组各自有不同 p) vs M0(两组共享同一 p)。公式为
和频率派的 p 值相比,贝叶斯方法给我们的是“概率性的结论”(比如 B 比 A 更优的概率是 95%),而不是“能否在某个阈值下拒绝零假设”。
实操案例
我们之类,两个方案 A 和 B,各有 、 次展示观测到成功/点击次数。
目标是:
-
求后验分布(贝塔分布); -
计算 ; -
画出多个分析图:先验/后验密度、后验差值分布及 ROPE、后验预测分布、联合后验散点与等高线、以及通过贝塔二项式边际似然计算的 Bayes Factor;
我们选择的数据:A:N_A=2000,成功 s_A=300(转化率 15%);B:N_B=2000,成功 s_B=360(转化率 18%)。先验用 Beta(1,1)(均匀),也会尝试稍微有信息量的先验做对比。
核心表达
Beta 先验与二项似然的共轭后验:
若先验为 ,观测到 个成功(总 次),后验为:
单组的边际似然(Beta-Binomial):
对于一次观测(n、s)在 Beta(α,β) 先验下,边际似然为:
其中 为 Beta 函数。
对模型比较(M0:共享 p;M1:各自独立 p_A、p_B):
-
用合并的 计算边际似然; -
(两者相乘)。
因此贝叶斯因子为:
完整代码
基于上述内容,我们把代码进行完善,其中注释非常的清楚,大家可以慢慢学习和调试起来~
import torch
import torch.distributions as D
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from math import lgamma, exp


# 1. 数据集
N_A = 2000
N_B = 2000
s_A = 300   # A 成功数量(点击)
s_B = 360   # B 成功数量

# 先验参数(Beta)
alpha0 = 1.0
beta0  = 1.0

# 2. 后验参数(解析)
alpha_A = alpha0 + s_A
beta_A  = beta0  + (N_A - s_A)

alpha_B = alpha0 + s_B
beta_B  = beta0  + (N_B - s_B)

print("Posterior A: Beta({}, {})".format(alpha_A, beta_A))
print("Posterior B: Beta({}, {})".format(alpha_B, beta_B))

# 3. 采样后验(用于可视化与概率估计)
n_samples = 20000
dist_A = D.Beta(alpha_A, beta_A)
dist_B = D.Beta(alpha_B, beta_B)
samples_A = dist_A.sample((n_samples,))
samples_B = dist_B.sample((n_samples,))

# 差值分布
diff = samples_B - samples_A

# P(p_B > p_A)
p_B_gt_A = (diff > 0).float().mean().item()

# 95% 可信区间
ci_low, ci_high = torch.quantile(diff, torch.tensor([0.025, 0.975])).tolist()

# 4. 计算边际似然与 Bayes Factor(Beta-Binomial 解析)
def log_binom_coeff(n, k):
    return lgamma(n+1) - lgamma(k+1) - lgamma(n-k+1)

def log_beta(a, b):
    return (lgamma(a) + lgamma(b) - lgamma(a+b))

def log_marginal_likelihood(s, n, alpha, beta):
    # log ( C(n,s) * B(s+alpha, n-s+beta) / B(alpha, beta) )
    return log_binom_coeff(n, s) + (lgamma(s+alpha) + lgamma(n-s+beta) - lgamma(n+alpha+beta)) \
           - (lgamma(alpha) + lgamma(beta) - lgamma(alpha+beta))

log_ml_A = log_marginal_likelihood(s_A, N_A, alpha0, beta0)
log_ml_B = log_marginal_likelihood(s_B, N_B, alpha0, beta0)
log_ml_combined = log_marginal_likelihood(s_A + s_B, N_A + N_B, alpha0, beta0)

log_ml_M1 = log_ml_A + log_ml_B
log_ml_M0 = log_ml_combined

BF_10 = exp(log_ml_M1 - log_ml_M0)  # Bayes Factor in favor of M1 (different p's)
print("P(p_B>p_A | data) ≈ {:.4f}".format(p_B_gt_A))
print("95% CI for p_B-p_A: [{:.4f}, {:.4f}]".format(ci_low, ci_high))
print("log marginal likelihoods: M1={:.3f}, M0={:.3f}, logBF={:.3f}".format(log_ml_M1, log_ml_M0, (log_ml_M1-log_ml_M0)))
print("Bayes Factor BF_10 = {:.3f}".format(BF_10))

# 5. 绘图部分(至少 4 张图)
xs = np.linspace(0, 0.4, 1000)
pdf_A = np.exp(dist_A.log_prob(torch.tensor(xs, dtype=torch.get_default_dtype())).numpy())
pdf_B = np.exp(dist_B.log_prob(torch.tensor(xs, dtype=torch.get_default_dtype())).numpy())

plt.figure(figsize=(10,6))
plt.plot(xs, pdf_A, label='Posterior A (Beta)', color='#FF6B6B', linewidth=2.2)
plt.plot(xs, pdf_B, label='Posterior B (Beta)', color='#4ECDC4', linewidth=2.2)
# 先验(uniform)
plt.plot(xs, [1.0]*len(xs), '--', color='#556270', label='Prior Beta(1,1)')
plt.fill_between(xs, pdf_A, alpha=0.1, color='#FF6B6B')
plt.fill_between(xs, pdf_B, alpha=0.1, color='#4ECDC4')
plt.title("Posterior densities of p_A and p_B", fontsize=14)
plt.xlabel("Conversion rate p")
plt.ylabel("Density")
plt.legend()
plt.tight_layout()
plt.show()

# 图2:posterior predictive 分布(模拟新的试验的成功数比例)
n_rep = 10000
# 先采后验 p,再采二项观察
pp_A_counts = torch.distributions.Binomial(total_count=N_A, probs=samples_A[:n_rep]).sample().numpy() / N_A
pp_B_counts = torch.distributions.Binomial(total_count=N_B, probs=samples_B[:n_rep]).sample().numpy() / N_B

plt.figure(figsize=(10,6))
sns.kdeplot(pp_A_counts, fill=True, color='#FF6B6B', label='Post. predictive A', alpha=0.6)
sns.kdeplot(pp_B_counts, fill=True, color='#4ECDC4', label='Post. predictive B', alpha=0.6)
plt.axvline(s_A/N_A, color='#FF6B6B', linestyle='--', label='Observed A')
plt.axvline(s_B/N_B, color='#4ECDC4', linestyle='--', label='Observed B')
plt.title("Posterior Predictive Distributions (proportion of successes in a new N trial)")
plt.xlabel("Simulated observed conversion rate")
plt.ylabel("Density")
plt.legend()
plt.tight_layout()
plt.show()

# 图3:p_B - p_A 的后验分布(带 ROPE 和 95% CI)
plt.figure(figsize=(10,6))
sns.histplot(diff.numpy(), bins=80, stat='density', color='#845EC2', alpha=0.8)
# 95% CI
plt.axvline(ci_low, color='k', linestyle='--', label='95% CI')
plt.axvline(ci_high, color='k', linestyle='--')
# ROPE(比如 ±0.005, ±0.01)
rope = 0.005
plt.axvspan(-rope, rope, color='#FFDC67', alpha=0.4, label='ROPE ±{:.3f}'.format(rope))
plt.title("Posterior of p_B - p_A (difference). P(p_B>p_A)={:.3f}".format(p_B_gt_A))
plt.xlabel("p_B - p_A")
plt.ylabel("Density")
plt.legend()
plt.tight_layout()
plt.show()

# 图4:联合后验散点与等高线(2D)
plt.figure(figsize=(8,8))
plt.scatter(samples_A.numpy()[::10], samples_B.numpy()[::10], s=6, color='#FF6B6B', alpha=0.15)
# 对角线
xs_diag = np.linspace(0,0.4,100)
plt.plot(xs_diag, xs_diag, color='k', linestyle='--')
plt.xlabel("p_A")
plt.ylabel("p_B")
plt.title("Joint posterior samples (subsampled) of p_A and p_B")
plt.xlim(0.05,0.25)
plt.ylim(0.08,0.28)
plt.tight_layout()
plt.show()

# 图5:Marginal likelihoods 与 Bayes Factor(条形图)
plt.figure(figsize=(8,5))
mls = np.array([exp(log_ml_M0), exp(log_ml_M1)])
plt.bar([0,1], mls, color=['#0081A7','#00AF91'])
for i,v in enumerate(mls):
    plt.text(i, v*1.05, "{:.2e}".format(v), ha='center', fontsize=10)
plt.xticks([0,1], ['M0 (same p)', 'M1 (different p)'])
plt.title("Marginal likelihoods under M0 and M1. BF_10={:.3f}".format(BF_10))
plt.tight_layout()
plt.show()
核心流程
数据生成与背景
我们假设 A 组有 次展示,观测到 次成功;B 组 。
初始先验采用 Beta(1,1),即均匀先验,表示初始对 p 无偏好。
后验计算(解析)
后验为 Beta( , )。因此:
-
Posterior A = Beta(1 + 300, 1 + 1700) = Beta(301, 1701) -
Posterior B = Beta(1 + 360, 1 + 1640) = Beta(361, 1641)
这一步用了 Beta-Binomial 的共轭关系,计算准确且高效。
后验采样与差值
从两个 Beta 后验分别采 20000 个样本(samples_A, samples_B)。
计算差值样本 diff = p_B - p_A:
图1:Posterior densities of p_A and p_B
两组 p 的后验密度曲线,先验用虚线表示,直接看到两个后验峰值位置(分别围绕 0.15 与 0.18),以及不确定度(宽度)。
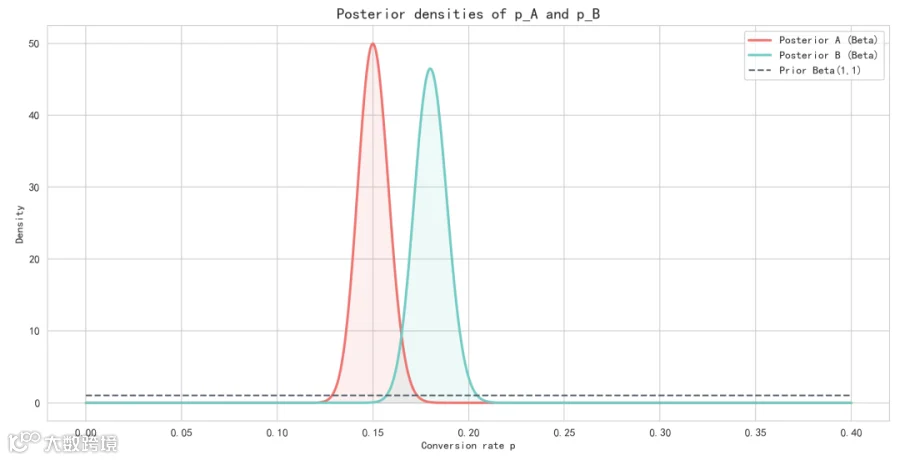
若两个密度有相当程度重叠,则说明我们对哪一个更好不确定;若峰值分离且重叠小,则更有信心说一方优于另一方。
图2:Posterior Predictive Distributions
后验预测分布,表示给定每一组的后验 p,若做一次新的样本(同样的 N),我们会观察到怎样的“样本成功率”分布。

posterior predictive 可以检验模型能否产生类似观测到的数据(后验预测检查)。我们在图中也画出了真实观测值。
如果真实观测值落在后验预测分布的高密度区,说明模型与数据一致;如果不在,则可能模型假设有问题(比如先验或噪声模型不对)。
图3:Posterior of p_B - p_A
p_B - p_A 的后验直方图(估密度),标注 95% 可信区间并画出 ROPE(比如 ±0.005)。

这张图是我们做判断的关键:若绝大部分后验质量在正区间,则可以说 B 更好。ROPE 可以用来判断“实际差异是否足够大到有实用意义”。
例如 P(p_B>p_A)≈0.983,95% CI ≈ [0.010, 0.050](示例数值),说明 B 优势有较高的概率,且差异不只是统计学上的,还可能在实用上有意义(若 ROPE 较小则会判断为显著)。
图4:Joint posterior samples
在 (p_A, p_B) 空间上的联合样本散点,能够直观看到两个参数的联合不确定性以及相互关系;对角线表示相等的位置。若样本大多在对角线之上,说明 B 较大。
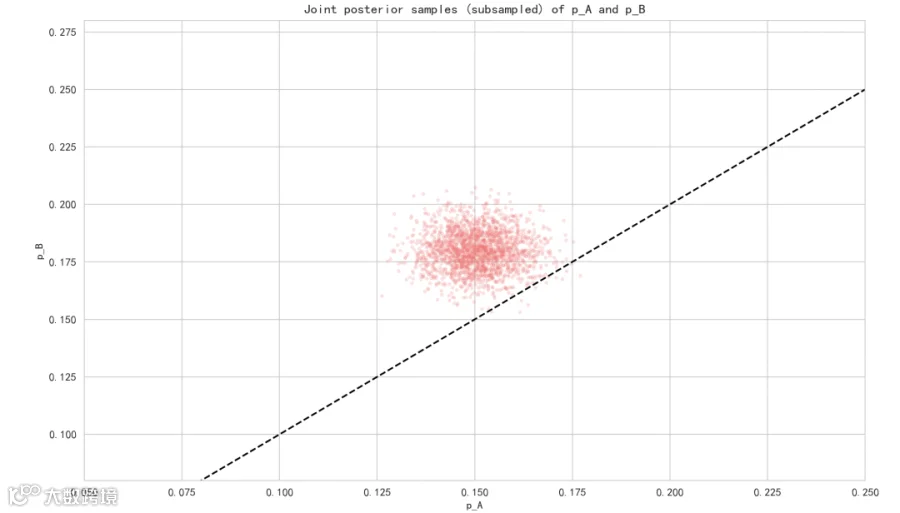
可以看出 p_B 的样本总体偏向于 p_A 之上,大面积位于对角线上方。
图5:Marginal likelihoods 与 Bayes Factor
我们计算了 M0(两组相同 p)和 M1(两组分别有各自 p)的边际似然。

Bayes Factor:
BF>1 表示数据更支持 M1(不同 p),BF<1 表示支持 M0(相同 p)。常用解读(粗略):BF 1~3 弱证据,3~10 中等,>10 强证据(不同作者标准不同)。
贝叶斯因子直接衡量两模型互相比的证据强度,比单纯的 p 值能给出更明确的相对支持度。
总结
频率派测试给你一个基于假设检验的“拒绝/不拒绝”的判断;贝叶斯检验直接给出“概率化的信念更新”与模型比较的证据比。
贝叶斯检验的核心产物是后验分布:一切有意义的决策,相信哪个方案更好、是否等效、是否可上线 都可以直接从后验分布中读取。
实际使用中,重要的是,明确问题、合理建模、并用后验分布与后验预测来支持决策~