

论文标题:SimpleDesign: A Joint Model for Protein Sequence and Structure Codesign
作者团队:Jiarui Lu, Yuyang Wang, Yizhe Zhang, Jiatao Gu, Navdeep Jaitly, Joshua M. Susskind, Miguel Ángel Bautista (Mila, Apple等)
文章链接:https://arxiv.org/abs/2609.03377
导读
蛋白质的生物学功能由其氨基酸序列和所呈现的三维(3D)复杂构象共同决定。在计算生物学和AI辅助药物发现领域,能够同时理解并生成这两种内在多模态关系的生成式模型,对于酶工程、抗体设计和从头蛋白质疗法(De Novo Protein Therapeutics)至关重要。
近年来,随着AlphaFold等蛋白质结构预测模型的突破,以及大规模蛋白质语言模型(PLMs)的发展,研究人员开始探索能够 协同设计(Co-design) 序列和结构的生成模型。然而,现有的多模态生成模型(如ESM3、DPLM等)通常依赖于复杂的多阶段训练流程:首先需要训练自动编码器(离散变分自编码器,d-VAE)将连续的3D结构“分词(Tokenize)”成离散的隐层表示,然后在该隐空间中训练生成模型。
来自Apple和Mila的研究团队近期在TMLR (Transactions on Machine Learning Research) 上发表了名为SimpleDesign的工作。他们提出了一种革命性的假设:实现高性能的蛋白质协同设计,并不需要复杂的多阶段训练和结构离散化分词。 SimpleDesign 是一种直接在数据空间(Data Space)中进行训练的高效多模态蛋白质设计模型,通过单一的端到端目标函数,无缝融合了序列的离散交叉熵与连续坐标的回归目标。
本文将为您深入剖析这篇硬核研究的核心逻辑、数学原理、网络架构及实验成果,带您全面了解下一代蛋白质协同设计模型的极简美学。
1. 处于“两大阵营”边界的中间道路
在当前的蛋白质生成领域,主要存在两条技术路线:
-
1. 基于分词器的多模态大语言模型(Tokenizer-based PLMs):代表作如ESM3、DPLM系列。这类模型继承了语言模型在掩码序列建模上的高扩展性,但严重依赖于多阶段的Tokenizer训练,引入了额外的计算开销和流水线复杂度。 -
2. 基于流匹配/扩散的几何生成模型(Flow/Diffusion-based Models):代表作如MultiFlow、JointDiff。这类模型直接对坐标或残基框架进行连续几何建模,引入了极强的等变性(Equivariance)和几何归纳偏置( Inductive Biases),但往往需要高度定制化的网络结构和复杂的流动力学方程。
SimpleDesign 恰好处于这两种范式的交界处。
它并没有设计一套全新的几何扩散框架,也没有试图将连续的结构强制转化为离散的Token。相反,它采用了一种极简的替代方案:在一个统一的Transformer主干中,将针对氨基酸序列的**离散掩码生成(Discrete Masked Generation)与针对
坐标的连续去噪(Continuous Coordinate Denoising)**直接耦合。这使得 SimpleDesign 既继承了PLMs风格掩码建模的简单性和可扩展性,又保留了在数据空间直接操作连续坐标的直观性。

Figure 1图注摘要:
• 左图(端到端训练):展示了SimpleDesign将序列掩码和结构加噪结合的联合训练流程。 • 右图(协同生成推理):展示了在推理阶段,模型如何通过单一的Transformer主干,同步进行氨基酸解掩码(Unmask)和三维坐标去噪(Denoise)的协同生成pipeline。
2. 数学原理:独立时间轴与联合生成目标
设蛋白质序列为 ,结构为三维坐标矩阵 。SimpleDesign 的核心创新在于为这两种异构数据分别定义了独立的生成时间轴:序列时间 和 结构时间 。
2.1 序列的离散掩码目标 (Sequence Objective)
对于离散的氨基酸序列,模型采用随时间
变化的离散掩码过程(可视为一种简化的离散扩散)。掩码率与时间
成线性关系,当
时掩码率极高。
给定部分观测序列
,训练目标是基于交叉熵的掩码氨基酸负对数似然损失:
其中 用于在掩码率较高时进行线性降权。
2.2 结构的连续回归目标 (Structure Objective)
对于连续的 3D 坐标,模型通过时间
在纯噪声
和真实数据
之间进行线性插值:
。
模型
被训练用来匹配将噪声映射到数据的目标速度场(Velocity Field)
。其损失函数为简单的均方误差(MSE):
2.3 联合优化与“状态连续体” (Joint Objective)
将上述两者结合,SimpleDesign 的单一阶段端到端训练目标为:
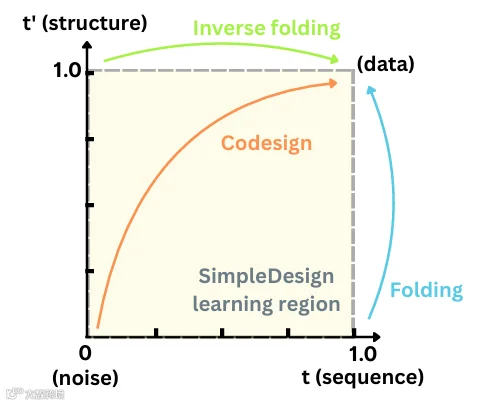
Figure 2图注摘要:
展示了序列时间变量 与结构时间变量 的独立采样空间。图中的四个顶点分别代表:真实数据区域、纯噪声区域、纯折叠任务(序列已知,结构未知)与纯逆向折叠任务(结构已知,序列未知),而二维平面的中间区域则对应着不同程度的联合协同设计(Co-design)学习状态。
独立采样的 和 提供了一种极其优雅的任务泛化机制:
-
• 当 且 时,序列几乎完全可见而结构被严重加噪,模型在学习正向折叠(Folding)。 -
• 当 且 时,序列被完全掩码而结构完整,模型在学习逆向折叠(Inverse Folding)。 -
• 中间状态 则让模型学会了如何在模态双向缺失的情况下,强制对齐并同步生成序列和结构。
为了确保模型专注于学习内在的结构几何,研究团队还在训练中引入了Kabsch-Umeyama算法进行刚体对齐(Rigid Target Alignment),确保目标速度场的监督信号对全局旋转和平移具有不变性。
3. 网络架构:Mixture-of-Transformer (MoT)
为了处理分类变量(序列)和连续变量(结构)之间的异构性,SimpleDesign 默认采用了**混合Transformer(Mixture-of-Transformer, MoT)**架构作为主干。
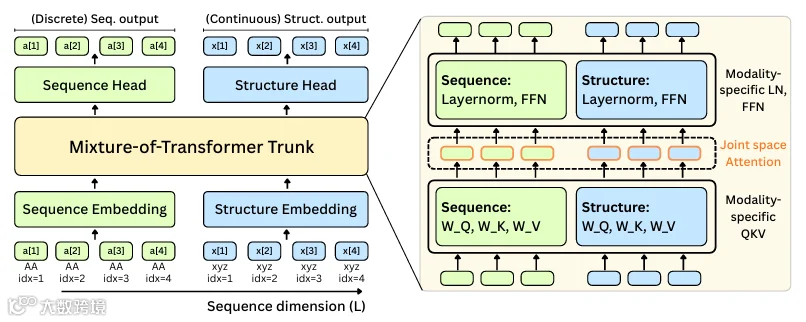
Figure 3图注摘要:
展示了混合Transformer(MoT)的主干架构细节。主要包含针对序列和结构各自独立的模态特异性层(如QKV投影、LayerNorm、前馈神经网络FFN),以及处理拼接后特征的共享联合空间自注意力机制(Joint space Attention)。
在输入端,序列通过可学习的Token Embedding转化为隐向量
;而结构的原始连续坐标无需分词,直接通过傅里叶特征编码(Fourier feature encoding)和线性投影转化为隐向量
。
这两种特征在序列长度维度上对齐并拼接,构成联合表示
。为了在两种模态间建立位置对应关系,模型引入了共享的残基索引,结合加性正弦位置编码和旋转位置编码(RoPE),赋予模型绝对与相对空间感知能力。
在MoT模块内部,序列和结构保留了各自独立的LayerNorm和前馈网络(FFN),但在自注意力计算时,它们在同一个联合空间内进行全局信息交互。这种设计既尊重了模态的特异性,又保证了跨模态约束的强一致性。同时,这也方便模型直接复用现有的单模态预训练权重(如加载 ESM2-650M 的权重作为序列部分的初始化)。
4. 核心实验与性能表现
研究团队在高质量的 AFESM 蒸馏数据集(经过严格过滤,保留 pLDDT > 85 的高质量聚类中心,约180万条数据)上对 SimpleDesign 进行了30万步的预训练,并在 SwissProt 高质量子集上进行了微调。
模型在联合生成(Co-generation)、纯结构生成以及纯序列生成上均接受了极其严苛的基准测试,并与多款 SOTA 级几何生成模型(如 MultiFlow、La-proteina)和多模态 PLMs(如 ESM3、DPLM2)进行了对比。
4.1 序列-结构协同生成 (Co-generation)
在协同生成中,模型同时从噪声中采样结构坐标和氨基酸序列。评估指标包括生成序列再折叠后与生成结构的 RMSD/TM-score 一致性(Co-designability),以及生成结构的多样性(TMscore Diversity 和 FoldSeek Clustering)。
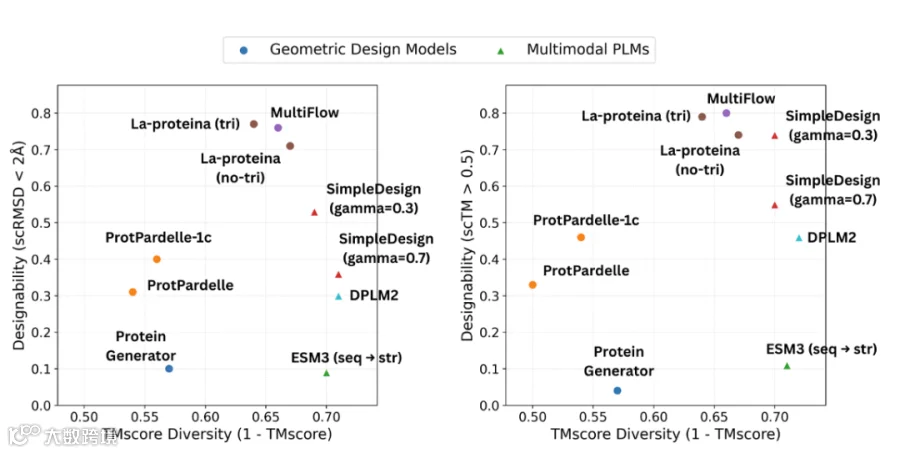
Figure 5图注摘要:
展示了联合设计能力(scRMSD或scTM指标)与 TM-score 多样性的权衡散点图。位于图中右上角区域的模型代表能够兼具高保真度(Fidelity)与高结构多样性(Diversity)的优异生成效果。
结果表明,与依赖分词器的 ESM3 和 DPLM2 相比,SimpleDesign 展现出了毫不逊色甚至更优的序列-结构一致性。虽然部分专门引入强几何偏置的流匹配模型(如 MultiFlow)在纯结构一致性上占优,但 SimpleDesign 通过更平滑的 TM-score 多样性证明了其在广阔构象空间中的探索能力。这证明了一个重要结论:极简的无分词器数据空间目标,足以在多模态语言模型的范畴内打败复杂的分词器流水线。

Figure 4图注摘要:
展示了 SimpleDesign 生成的不同长度(100至500个氨基酸)的蛋白质三维结构可视化图。图中蛋白质核糖体按氨基酸类型进行着色,底部标注了极高的自我一致性得分(scTM)和折叠置信度(pLDDT)。
4.2 深入对比:保真度与困惑度全面评估
除了协同生成,研究团队还利用 ProteinMPNN (PMPNN1/PMPNN8) 对模型生成的纯结构进行了逆向折叠评估,并利用 ProGen2 对生成的纯序列进行了困惑度(Perplexity)测试。

Figure 6图注摘要:
• 图(a):基于 scRMSD 的联合设计一致性得分分布。 • 图(b):基于 scTM 的联合设计一致性得分分布。 • 图(c):由单一结构生成的 PMPNN1-scRMSD 保真度分布。
• 图(d):单一结构生成的 PMPNN1-scTM 保真度分布。 • 图(e):生成序列的 ESMFold 预测保真度(pLDDT)分布。 • 图(f):基于 Progen2 模型评估的序列困惑度(Perplexity,越低越好)分布。
从 Figure 6 可以清晰地看到,SimpleDesign (红色高亮) 在多项指标上表现抢眼。特别是在序列生成质量上(图 e, f),SimpleDesign 生成的序列获得了极高的 pLDDT 置信度,并且其 ProGen2 困惑度远低于多种几何设计基准模型。这表明端到端的联合训练策略非常有效地捕获了深刻的进化语义(Evolutionary Semantics),而这些语义在部分流匹配模型或多阶段隐空间模型中往往容易丢失。
4.3 架构消融:Transformer 同样能打
非常有意思的是,论文还对网络主干进行了消融实验。当把精心设计的 MoT 主干替换为最普通的 Vanilla Transformer(序列和结构完全共享参数和 FFN)时,模型依然表现出了高度的竞争力,甚至在某些指标上反超了 MoT。
这有力地佐证了作者的核心观点:SimpleDesign 的成功,本质上来源于其巧妙的“无分词、数据空间、独立时间轴”的数学优化目标设计,而非特定架构带来的红利。 这种架构不可知性,为未来结合更强的视觉或文本生成主干模型打开了无尽的想象空间。
结语
在AI辅助分子生成与大语言模型快速演进的今天,许多研究陷入了“架构越叠越厚、Pipeline越拉越长”的怪圈。SimpleDesign 如同一股清流,证明了摒弃繁冗的 3D 结构分词器、回归最本质的数据空间坐标回归,同样能够实现 SOTA 级别的多模态协同设计。
对于从事计算化学以及大分子发现的研究者而言,这种可极大简化预训练流程、易于扩展到全原子(All-atom)的极简框架,无疑提供了一条极具潜力的新范式。未来,随着训练数据的进一步扩展和 Scaling Law 的发力,这种化繁为简的设计哲学必将在大分子生成领域大放异彩。