

智猩猩AI整理
论文作者投稿
最近看到一个很有意思的工作:Φ-Bench(Frontier AI Infra Bench)。它试图回答一个关键问题:Can LLMs Engineer the Infrastructure That Powers Them?
也就是说,未来的大模型是否不仅能够写代码、解决软件问题,还能够反过来优化支撑自身训练与推理的基础设施?
01
Frontier LLM Infra 问题是什么?
过去的 LLM Infra Benchmark 更多关注单个算子实现或局部性能优化,但真实的 Infra 工程往往更加复杂:模型需要理解大型代码库、定位系统瓶颈、设计优化方案,并通过反复实验持续改进。
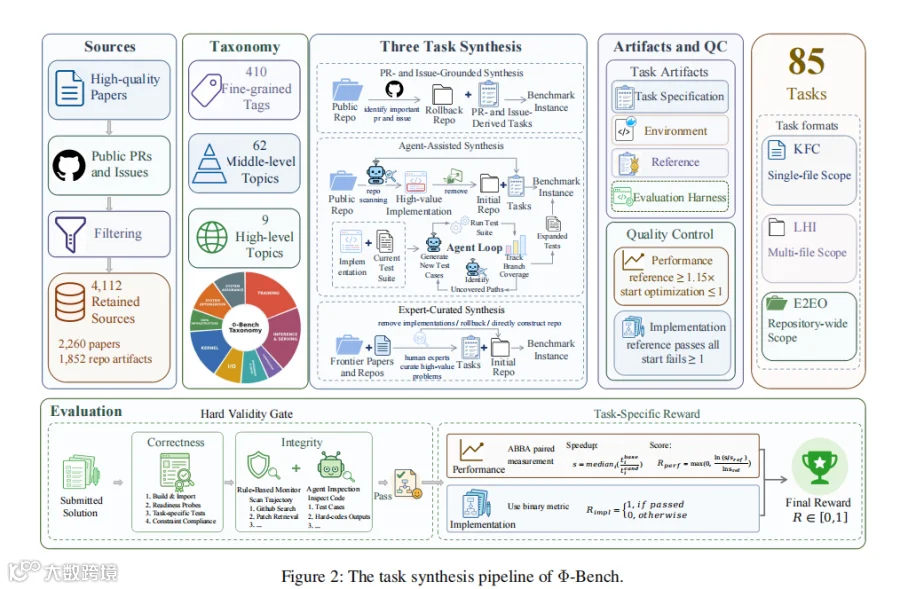
为了构建一个更全面的,更加贴近真实工程场景的 LLM Infra Benchmark,Φ-Bench 团队进行了大规模任务挖掘:系统性扫描主流 Infra 开源仓库中的 Issue、PR 和工程讨论,同时覆盖近 4 年 CCF-A 系统方向论文,共挖掘出 10000+ 任务来源。经过 Agent 粗筛、细筛以及领域专家逐项复核打磨,最终形成 85 个真实、高难度任务。

不同于聚焦单一算子级别测试的 KernelBench 类工作,Φ-Bench 覆盖三类任务:
Kernel Function Completion(KFC):面向单个算子 / Kernel 的实现与优化。任务明确给定接口和输入输出语义,模型需要在限定文件内完成正确、高效的计算原语实现,并通过正确性验证后进一步优化性能;
Long-Horizon Implementation(LHI):面向真实代码库中的长周期功能开发与工程实现。任务提供类似于 Issue 形式的需求,模型需要自主理解代码结构、定位相关模块、修改多个文件,并通过持续测试和调试完成端到端实现;
End-to-End Optimization(E2EO):面向完整系统级性能优化。任务提供真实工作负载、优化目标和约束条件,但不指定优化路径,模型需要自主分析系统瓶颈,制定优化方案,并进行跨模块、跨层级的代码修改与迭代优化。
️因此,Φ-Bench 评估的不只是“模型会不会写代码”,更关注模型是否具备真实 Infra 工程中的系统理解、问题定位和迭代优化能力。
02
现在的模型能解决 Infra 问题吗?
Φ-Bench 对当前主流前沿模型进行了系统评估,结果并不乐观。
整体来看,各模型得分均较低,表现最好的 Claude Opus 5 也仅获得 36.53 分,最低模型得分仅 13.31 分。
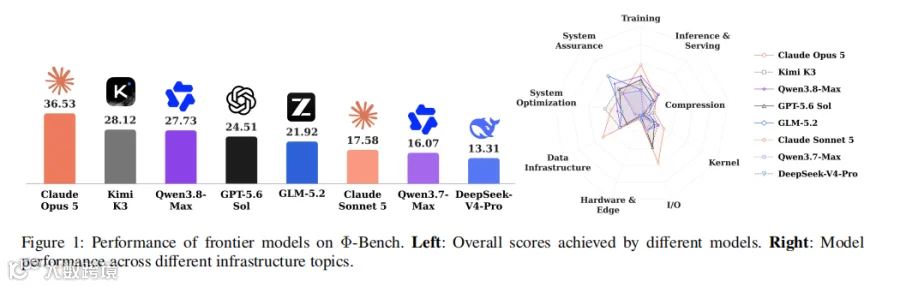
同时,不同模型展现出了明显的领域能力差异,但目前没有任何模型能够在所有 Infra 领域保持全面、稳定的能力。
尤其是在涉及底层硬件机制和系统优化的任务中,模型仍然面临较大挑战,说明当前 LLM 对复杂计算系统的理解和优化能力仍远未达到工程专家水平。
03
什么样的模型能做好 Infra 开发?
除了比较最终得分,Φ-Bench 团队还进一步分析了不同能力水平模型在端到端优化任务中的完整优化轨迹,试图回答:真正擅长 Infra 工程的模型,需要具备什么能力?

团队总结出了三个关键特质:
1. 谋定而后动
优秀模型不会盲目修改代码,而是通过低成本的假设筛选和验证机制,降低每次优化迭代的成本。
2. 实验求新知
优秀模型能够设计有效实验,控制变量和噪声影响,从每一次尝试中最大化获取有效信息。
3. 谨慎下结论
优秀模型不会简单根据性能变化归因,而是主动排除其他混杂因素,避免测量误差导致错误优化方向。
04
为什么这个工作值得关注?
Infra 优化可能是未来 Recursive Self-Improvement(RSI)的重要组成部分。过去,关于模型自我改进的讨论更多集中于数据、训练算法等层面;而 Φ-Bench 将问题进一步扩展到了支撑模型运行的基础设施:模型能否反过来优化那个“让自己得以运行”的系统?
如果未来的大模型能够自主理解复杂系统、发现性能瓶颈并持续优化 Infra,那么它们不仅是在使用计算基础设施,也可能逐渐参与构建下一代 AI 系统。
从这个角度看,Φ-Bench 也可以被理解为 RSI Bench-Infra,探索 AI 自我改进能力向基础设施层延伸的可能性。
END
关注+星标,获取AI前沿进展与开源一线动态