如果说提示词工程(Prompt Engineering)是在教大模型“如何说话”,那么上下文工程(Context Engineering)就是在决定大模型“能看见什么世界”。
随着模型能力的逼近极限,业界逐渐达成了一个共识:决定一个智能体表现上限的,不再是模型的参数量,而是输入给它的上下文质量。在这门日益复杂的工程学科中,其核心思想只有四个字——“恰到好处”。
不能多给,不能少给,必须精准投喂。这不仅仅是一句经验之谈,它背后隐藏着大模型的第一性原理,以及未来多智能体协同的终极架构——驾驭工程(Harness Engineering)。
一、第一性原理:为什么“恰到好处”是生死线?
要理解上下文工程的本质,我们需要回到大模型(LLM)的数学物理意义。大语言模型的本质是一个条件概率生成器。给定前置的上下文 C,它通过自回归预测下一个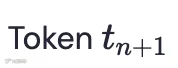 的概率分布:
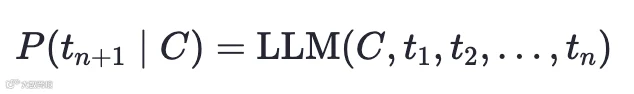
这个公式揭示了一个冷酷的事实:模型的输出质量,100% 被条件 C(上下文)所锚定。
OpenAI 联合创始人 Andrej Karpathy 曾给出一个极为精妙的类比:“LLM 是 CPU,而上下文窗口(Context Window)就是 RAM。” CPU 的算力再强,如果内存里塞满的都是垃圾数据,或者缺失了关键的寻址信息,计算结果依然是崩溃的。在这片昂贵的“内存”中,信息的供给必须恪守“恰到好处”的黄金法则:
多给,是“毒药”(注意力污染):即使现在的模型支持128K 甚至2M 的超长窗口,但“能装下” 绝不等于 “该装满”。Transformer 的核心是注意力机制(Attention),它是基于所有Token 进行Softmax 归一化的。无关的背景文档、冗余的历史对话越多,关键指令分到的注意力权重就被稀释得越厉害。最终导致 “指令漂移”(Instruction Drift),模型看了几万字,却唯独忘记了你让它干什么。

少给,是“失明”(幻觉与坍缩):如果为了省Token 而省略了关键信息(如团队的代码规范、特定术语的定义、API 版本),模型就会遭遇“信息真空”。为了填补真空,它只能退回到训练数据中去寻找“统计学上的先验概率”来瞎编。这就是幻觉(Hallucination)的根本来源——看起来通顺,实则驴唇不对马嘴。
因此,上下文工程的第一性原理,就是在有限的窗口内,追求“最小充分集”的绝对高信噪比。
二、上下文的三层架构:信息的漏斗与折叠
要做到“恰到好处”,我们必须承认一个事实:并非所有的信息都在同一个时间尺度和重要度上发挥作用。一个优秀的智能体系统,其上下文应该像人类的记忆系统一样,被严格划分为三个层次:
层次 |
时间尺度 |
核心内容 |
类似人类记忆 |
动态更新频率 |
长期上下文 |
产品线/组织级 |
领域本体库、知识图谱、架构演进史、安全合规底线。 |
语义记忆 / 长期记忆 |
极低(按周/月) |
中期上下文 |
项目级/史诗级 |
当前项目的需求文档、技术选型状态、已完成模块接口、团队协作契约。 |
工作记忆 |
中等(按天/小时) |
短期上下文 |
任务级/即时级 |
当前正在执行的 Task 描述、报错堆栈日志、最近 3-5 轮对话的反馈。 |
瞬时注意力 |
极高(秒级/实时) |
这三层的关系并非简单的文本拼接,而是一个漏斗式的降维过滤过程:

例如,当智能体要写一个支付模块的单元测试时:它不需要知道公司所有的几万篇文档(长期),只需要从中抽取“测试框架规范”;它不需要知道前端怎么画UI(中期),只需要知道“支付 SDK 的接口定义”;最后,将这些提纯后的规则,与当前要测的具体代码段(短期)组合在一起,形成那次“恰到好处的 Prompt”。
三、进阶:多智能体与“驾驭工程” (Harness Engineering)
当系统从“单智能体单打独斗”演进到“多自主智能体(Multi-Agent)协作”时,上下文的构建就从一门手艺,变成了一项庞大的系统工程。
在多智能体协同中,最可怕的不是大模型变笨了,而是上下文的时空错乱。 设想一个场景:需求分析 Agent 刚刚修改了数据库 Schema 的设计,但编码 Agent 的上下文中还停留在旧版本;与此同时,知识图谱中关于某个底层组件的 API 刚刚发生了变更。如果这些上下文不进行动态同步,整个多智能体流水线就会瞬间全线崩溃。
这就催生了上下文工程的终极形态——驾驭工程(Harness Engineering)。 “驾驭”一词,意味着你不再是静态地拼接一段文本,而是在动态地驾驶、调度和输送信息流。你必须解决三个核心难题:
动态供给:知识库和知识图谱必须是“活的”,任何局部的变更都要能引发全局图谱的更新。
真相单一源(SSOT):多个Agent 必须共享同一个中期项目的“状态机”,不能各自为政。
认知隔离:负责画图的Agent 不需要知道数据库怎么连,必须严格隔离不必要的上下文以保护注意力。
四、终极解法:规划 “上下文智能体集群”
为了实现真正的驾驭工程,我们必须在架构上做出切分——不要让工作智能体(Worker Agent)自己去管理自己的上下文,而应该引入专门的“上下文智能体(Context Agents)”来进行动态维护。
一个成熟的架构应包含以下守护者矩阵:
长期上下文守护者(Long-term Keeper):专门负责维护企业级知识图谱(Knowledge Graph)和RAG 向量库。当有新的技术文档接入或旧API 废弃时,它负责在后台默默整理图谱,更新实体关系,确保底层知识库的鲜活。
中期上下文守护者(Medium-term Keeper):它是一个项目状态机。它时刻监听各个Worker Agent 的产出(例如代码提交、文档生成),并将其总结归纳,更新到项目的“全局黑板(Blackboard)”上。它知道项目进行到了哪一步,哪些模块已经Ready。
短期上下文守护者(Short-term Keeper):它是最忙碌的“缓存清理员”。负责对当前任务的对话历史进行动态滑动窗口压缩、Token 截断和核心意图提取。
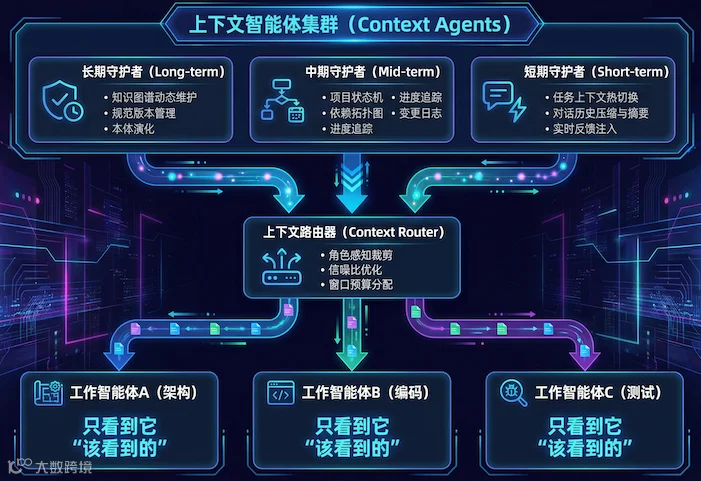
【上下文路由器 (Context Router)】 在这三位守护者之上,是一个核心的路由器。当某个具体的 Worker Agent(比如负责写前端的智能体)准备执行任务时,上下文路由器会瞬间从长、中、短三个守护者那里,抽取恰好匹配该前端角色、恰好符合当前任务节点的最小信息集,精准注入到它的 Context Window 中。
结语
从“提示词工程”的遣词造句,到“上下文工程”的信息过滤,再到多智能体时代的“驾驭工程”,AI 落地的深水区充满了对信息密度的博弈。
大模型的能力边界固然重要,但我们如何向它展开这个世界的方式,才真正决定了它能走多远。记住那个第一性原理——给得太多是干扰,给得太少是盲目。用多层级的上下文智能体集群,去动态驾驭信息的洪流,打磨那一份“恰到好处”,才是通向 AGI 工业化应用的最优解。