

最近DeepSeek Harness 团队负责人 Tianyi Cui 发了一个帖子介绍了 DeepSeek 新公开的三个代码仓库:
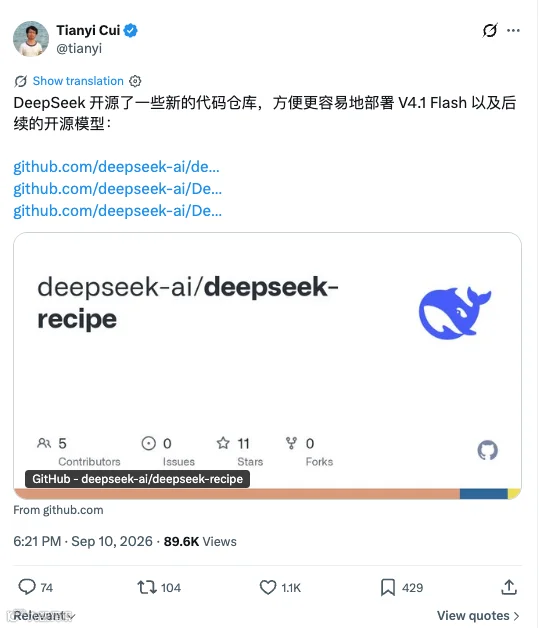
我看了一下,这三个工具是 DeepSelect、deepseek-recipe 和 DeepJIT,分别处理 TopK 算子、请求与响应的协议适配,以及内核编译运行。
前两天的技术解读,讨论的是 DeepSeek V4.1 Flash 怎样省计算和缓存。
DeepSeek-V4.1-Flash技术报告深度解读:长程 Agent 如何重新分配预算
顺着架构往下看,有一个很具体的工程问题:技术报告将 CSA2 层的 Top-K 设置为512;即便只读取这些位置,找到它们本身也要花时间。
DeepSelect:只选 512 个位置,怎么选得更快?
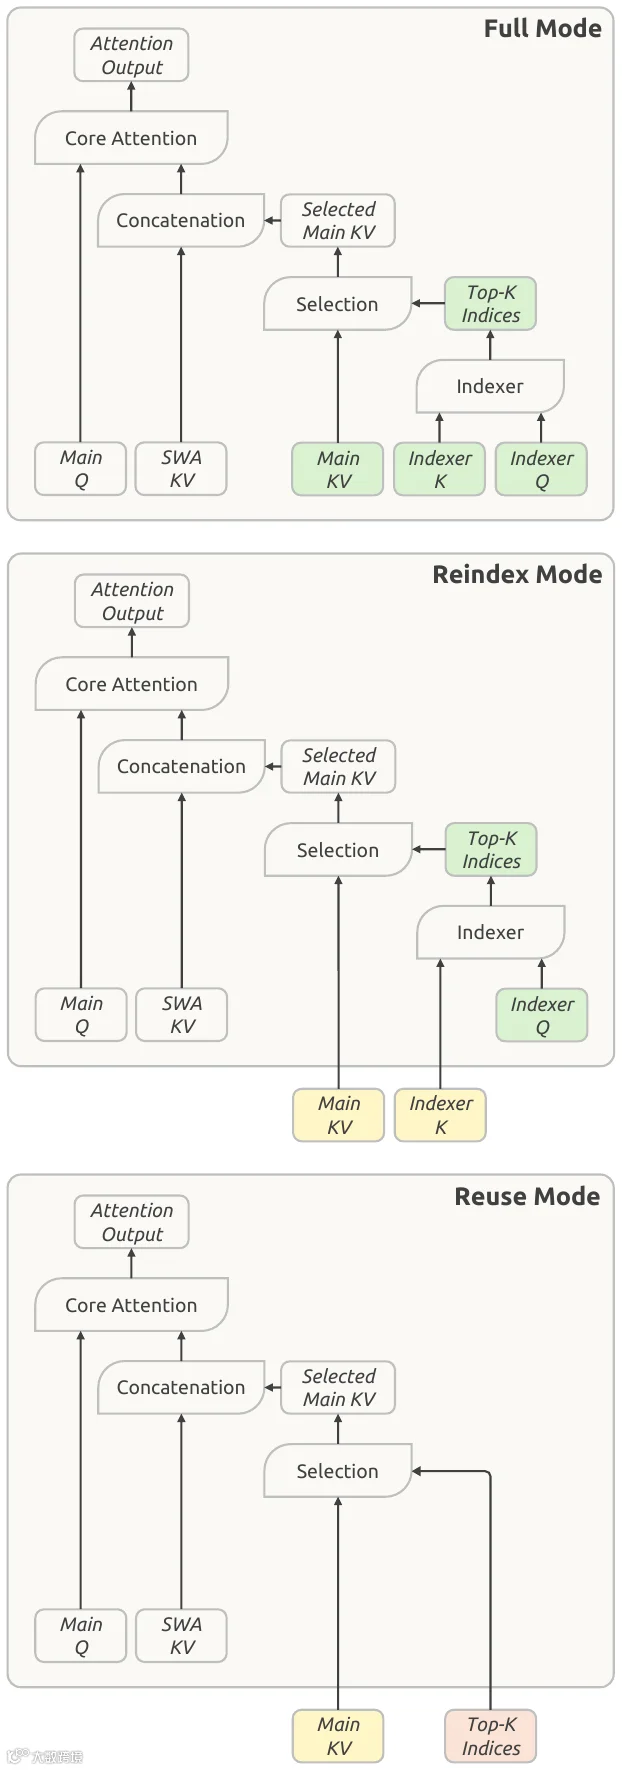
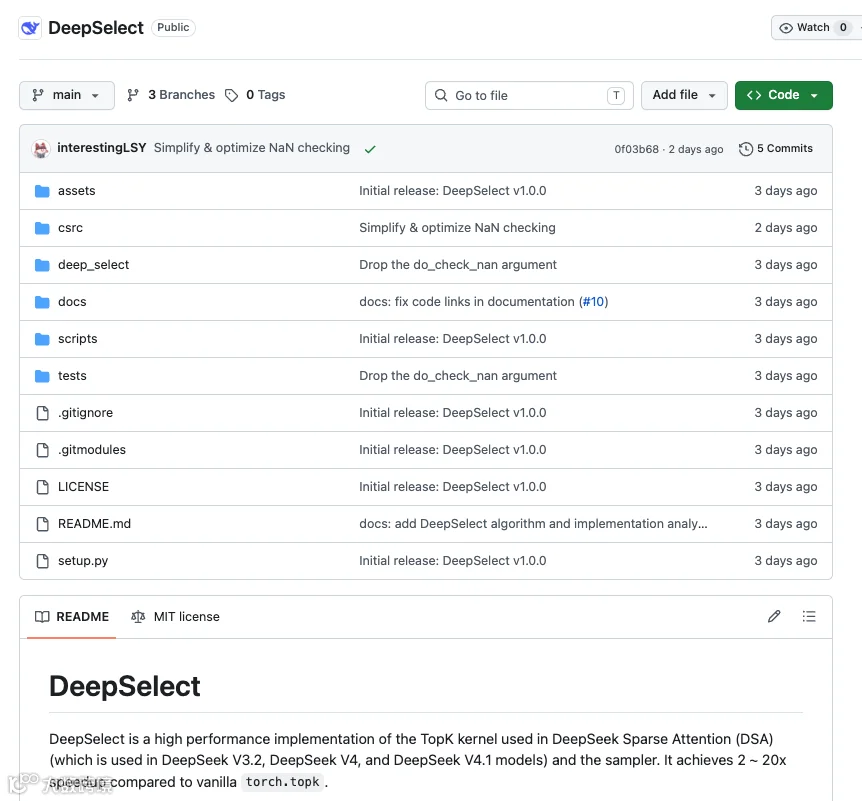
DeepSelect 优化的就是其中的 TopK 操作:从大量上下文位置的分数中,选出最相关的那一小部分。生成阶段也有类似需求——从较大的词表中选出候选 token。
它的算法可以压缩成三个动作:分块扫描,按当前阈值筛选,候选变多时再收紧。扫描按随机顺序进行,只有高于阈值的元素才进入候选缓冲区;缓冲区变大或扫描结束时,在共享内存中将候选精简到 K 个,再用其中的最小值更新阈值。随着阈值提高,后续更多元素可以直接被过滤。
结果是:在指定工作负载下,相比原生 torch.topk,DeepSelect 实现约2—20倍的算子加速。
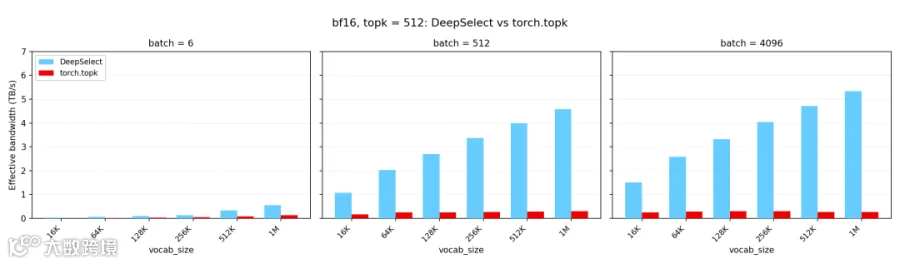
输入精度、batch size、候选规模和 K 值都会影响表现,测试针对的是其中一组特定场景。BF16 对照之外,还给出了 FP32 采样场景的结果。

TopK 处理的是“从分数里选位置”;报告指出,即使采用跨层索引复用,剩余索引器仍要对完整可见上下文打分,极长上下文中的这部分计算仍可能成为瓶颈。
因此,DeepSelect 给出的工程增量很明确:部署者拿到了一份针对相关负载优化的选择算子实现。
deepseek-recipe:把模型接进应用,格式怎么对上?
到了应用接入,另一个问题是:请求怎样正确编码给模型,输出又怎样还原成客户端期待的响应?
deepseek-recipe 把这部分适配工作公开了。它提供 Rust 库和 Python 绑定,将 Messages、Chat Completions、Responses 等格式的请求统一转换为 Conversation,再编码成 DeepSeek V4 和 V4.1 所需的 prompt 或 token IDs;模型生成之后,再转换为对应协议的完整或流式响应。
比如,同一个推理后端要接不同协议的客户端,服务层需要处理的不只是字段改名,还包括对话编码、图片、思考内容、工具调用和流式返回。recipe 提供了这些转换能力,减少逐套编写适配逻辑的工作。
它也给出了 Python 服务示例,但默认返回的 Hello world! 是 mock,不需要模型权重。要得到真实模型输出,仍需接入自己的推理后端。 模型推理、工具执行和 HTTP 传输都由外部提供,recipe 负责其中的格式与编码转换。
DeepJIT:内核编译过了,怎样避免重复干活?
最后一个仓库 DeepJIT,面向编写 C++/Python 扩展的开发者,处理内核运行时编译、编译产物缓存、设备加载和启动。
它可以在内存中复用已加载的内核,在磁盘上复用编译产物,减少重复编译和加载。CUDA 与昇腾后端共享这套运行时接口,设备内核源码及编译、启动选项仍需分别处理。
三个工具覆盖不同的工程问题,并不构成一键部署方案。但对准备接入 DeepSeek V4.1 Flash 的开发者,这次开源给出了具体的复用起点:开源权重之外,可复用的工程也在公开。
参考链接
-
Tianyi Cui 关于三个仓库的原帖:https://x.com/tianyi/status/2097993855778046379 -
DeepSeek V4.1 Flash 技术报告:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/df42c109f1defefcbfcedbe7d905718a12266e40/DeepSeek_V41_Tech_Report.pdf -
DeepSelect 官方仓库:https://github.com/deepseek-ai/DeepSelect -
DeepSelect 官方算法说明:https://github.com/deepseek-ai/DeepSelect/blob/main/docs/DeepSelect-deep-dive.zh.md -
deepseek-recipe 官方仓库:https://github.com/deepseek-ai/deepseek-recipe -
deepseek-recipe Python服务示例:https://github.com/deepseek-ai/deepseek-recipe/blob/main/server-py/README.md -
DeepJIT 官方仓库:https://github.com/deepseek-ai/DeepJIT