搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
扒完DeepSeek 最新论文,我发现了V4.1 Flash便宜大碗的秘密
>
扒完DeepSeek 最新论文,我发现了V4.1 Flash便宜大碗的秘密
APPSO
2026-09-12
8
导读:这是鲸鱼一以贯之的又快又便宜
DeepSeek
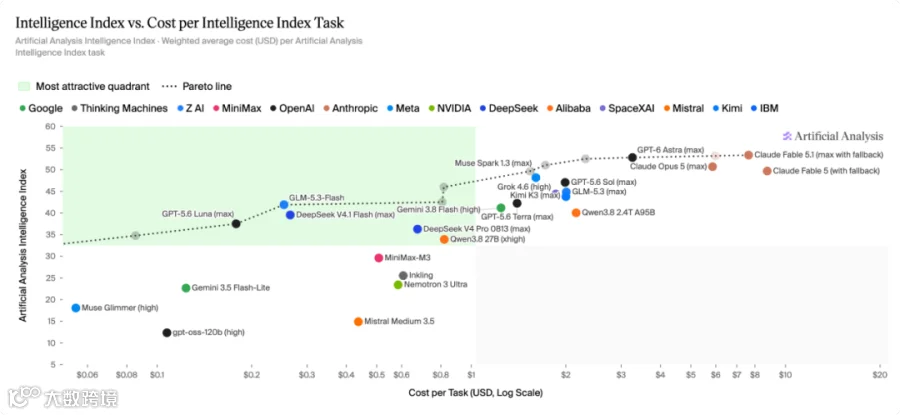
V4.1 Flash 正式发布,网页版与 App 同步更新,原有的「快速」、「专家」及「识图」模式已合并为统一入口。该模型集成了日常对话、图像理解与复杂问题解决能力,实质上融合了此前发布的 V4 Flash、Vision Exp 及 V4 Pro 的核心特性。
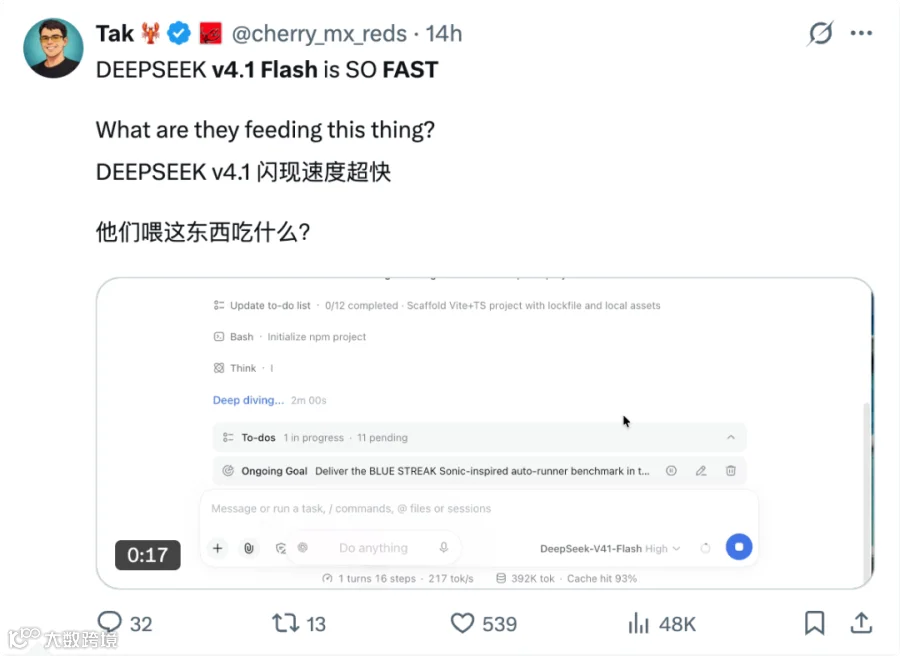
业界对 V4.1 Flash 最显著的评价在于其极速表现。测试数据显示,其运行
速度
可达 420-507 tok/s,优于 Gemini 3.8 Flash。尽管主干参数从 284B 激增至 552B,但得益于重新设计的模型架构与扩大的训练规模,其处理长输入及保存上下文的开销大幅降低。每 Token 的全局 KV cache 仅占 890 字节,约为上一代 V4-Flash 的四分之一,更是初代 DeepSeek-V1 的约 1/437。
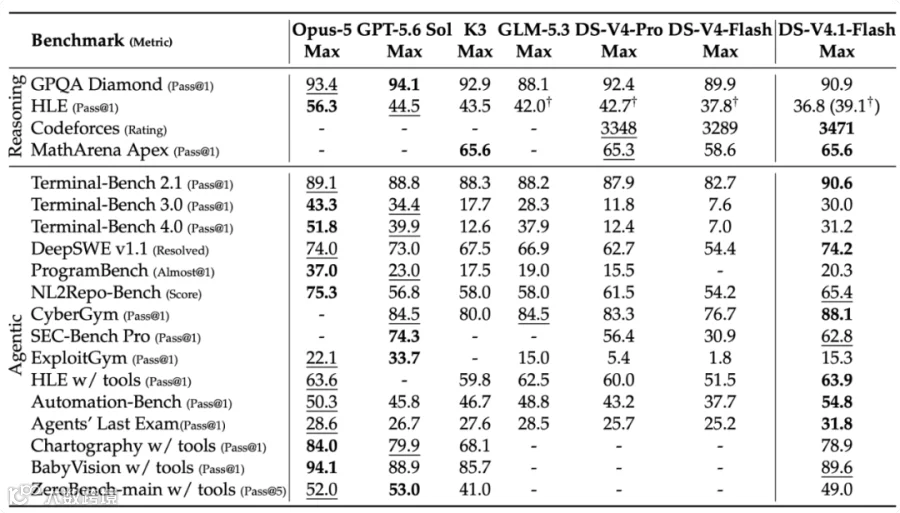
在参数增加的同时,V4.1 Flash 通过压缩 KV cache 实现了性能跃升。在多项 Agent 基准测试中,其表现持平甚至超越了 Claude Opus-5 和 GPT-5.6 Sol,展现了 DeepSeek 在构建高效率 Agent 时代模型上的技术路径。
图|技术
报告
来源:HuggingFace DeepSeek-V4.1-Flash
架构革新:模型变大,成本如何降低
KV cache 是模型处理内容后保留的中间状态,用于复用前文信息以节省计算开销。随着上下文
长度
增加,显存占用随之上升。DeepSeek 四代模型的演进史,即是一部 KV cache 压缩史:从 V1 的 389 KB/Token 降至如今的不足 1 KB。
CED 架构:编码器与解码器分离
V4.1 Flash 采用了因果编码器 - 解码器(CED)架构,将 40 层网络划分为前 20 层编码器和后 20 层解码器。解码器所需的全局 KV 缓存直接由编码器输出投影生成,这意味着大部分输入内容无需完整经过后半段网络。对于频繁调用
工具
、缓存命中率低的 Agent 负载而言,这种设计使预处理长文本的计算量近乎减半。
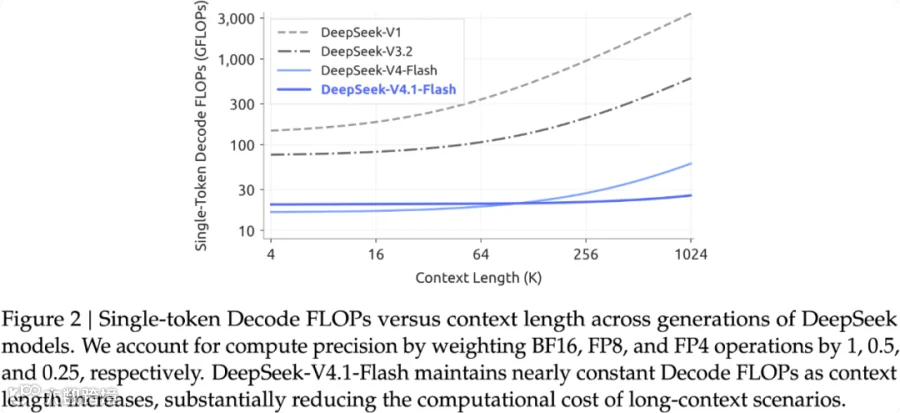
在传统 Decoder-only 架构中,每个 Token 需穿过全部网络层;而 V4.1 Flash 在处理输入时,每个 Token 仅激活约 80 亿参数,生成时激活约 160 亿参数。这种架构专为 Agent 场景设计,资料越长,节省的计算价值越大。
图|DeepSeek 各代模型在不同上下文长度下的单 Token 解码 FLOPs 对比
CSA2 与存储优化:压缩缓存,延长驻留
注意力机制升级为压缩稀疏注意力 2.0(CSA2),允许多个网络层共享全局 KV 缓存,避免重复计算。主 KV cache 采用 FP4 量化及 OCP 开放标准格式,以兼容更多硬件平台。
针对局部状态存储开销大的问题,V4.1 Flash 引入 SWA Bounded Replay 机制:将编码器局部状态存入仅保留几分钟的内存池,过期后若需恢复,则重算最近 128 个 Token。该方案以少量重算换取长期存储成本的降低,使持久 KV 缓存占用降至上一代的约八分之一,并可驻留 72 小时以上,极大降低了
服务
商在多轮对话中的算力成本。
此外,模型外挂 196B 的「条件记忆」模块 Engram,通过哈希表预存常见词组合,仅需查表即可调用,进一步降低了推理成本。
数据工程:确保模型准确率
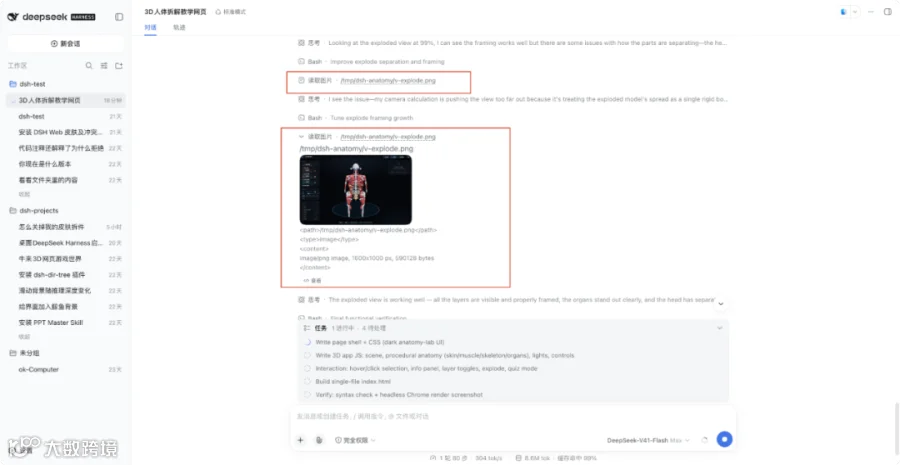
V4.1 Flash 基于 45 万亿 Token 的多模态语料预训练,原生支持图像与文本混合输入。这使得 Agent 能够利用截图检查工作成果,如校验网页排版或图表数据,增加了结果验证的维度。
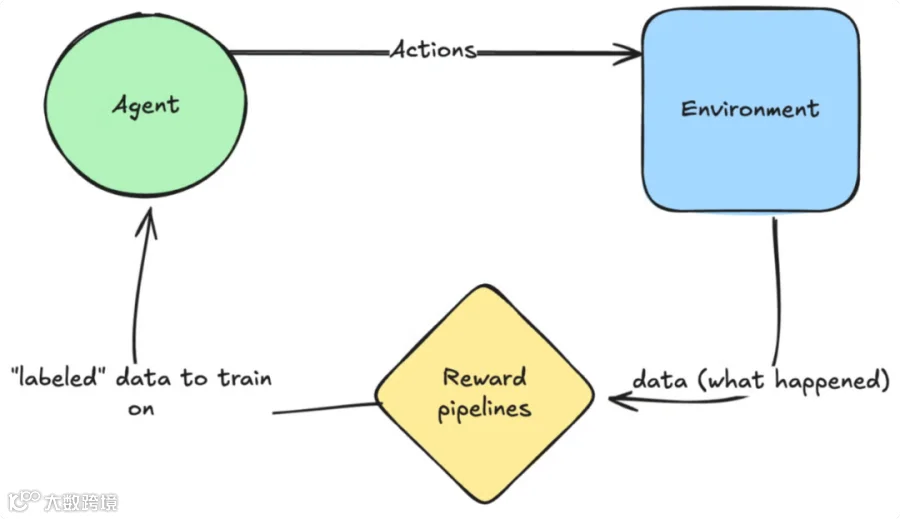
在后训练阶段,DeepSeek 延续了监督微调、强化学习和蒸馏策略,核心突破在于数据工程的精细化。团队将 Agent 任务拆解为问题、执行环境与验证系统三部分,利用内部员工与合作伙伴的真实工作记录重建工具环境,让模型在模拟场景中反复修正错误。
图|DeepSeek 通过读取图片检查结果
以编程任务为例,团队构建了出题、试做、验收的自动化闭环,独立 AI 负责检查题目
质量
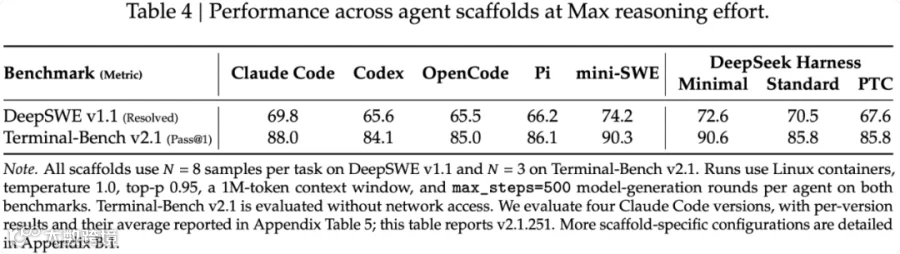
与答案合规性。这种机制确保了强化学习数据的多样性与可验证性,显著提升了模型在实际工作流中的表现。同时,DeepSeek 指出工具框架的配置差异也会直接影响模型输出,未来将持续优化模型与工具框架的协同。
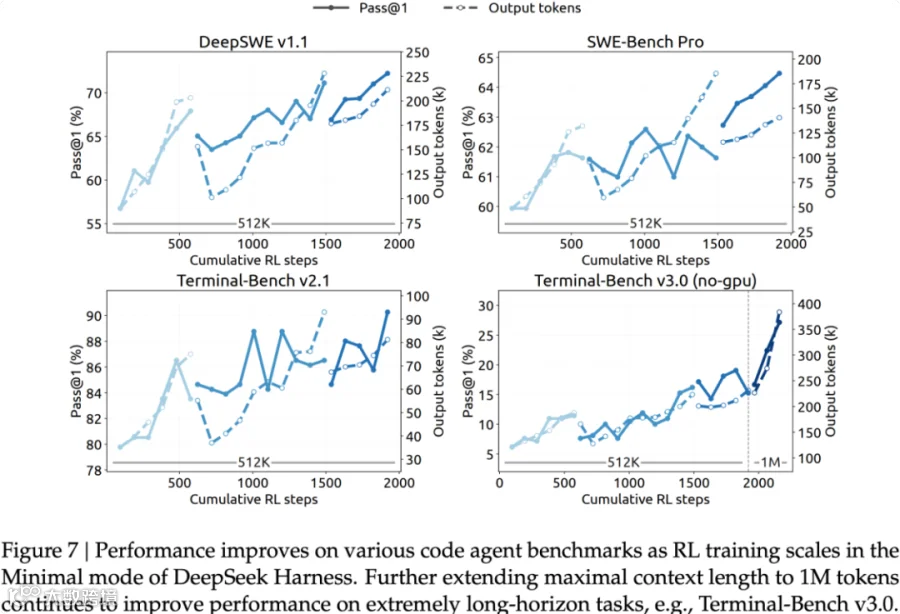
图|强化学习训练规模扩大带来性能提升
基准测试:Agent 能力显著增强
V4.1 Flash 在 Agent 相关测试中进步明显。在 DeepSWE v1.1 软件问题解决测试中,其得分达 74.2%,超越上一代 Flash(54.4%)及 V4-Pro(62.7%),并略高于 Opus-5(74.0%)和 GPT-5.6 Sol(73.0%)。Terminal-Bench 2.1 成绩从 82.7 提升至 90.6,AutomationBench 从 37.7 跃升至 54.8。
尽管在高难度任务上仍有差距,如 Terminal-Bench 4.0 得分为 31.2(Opus-5 为 51.8),GPQA Diamond 科学问答得分为 90.9(低于 V4-Pro 的 92.4),但在原生视觉支持的 Chartography 测试中,V4.1 Flash 以 78.9 分领先 Kimi K3,仅次于 Opus-5。
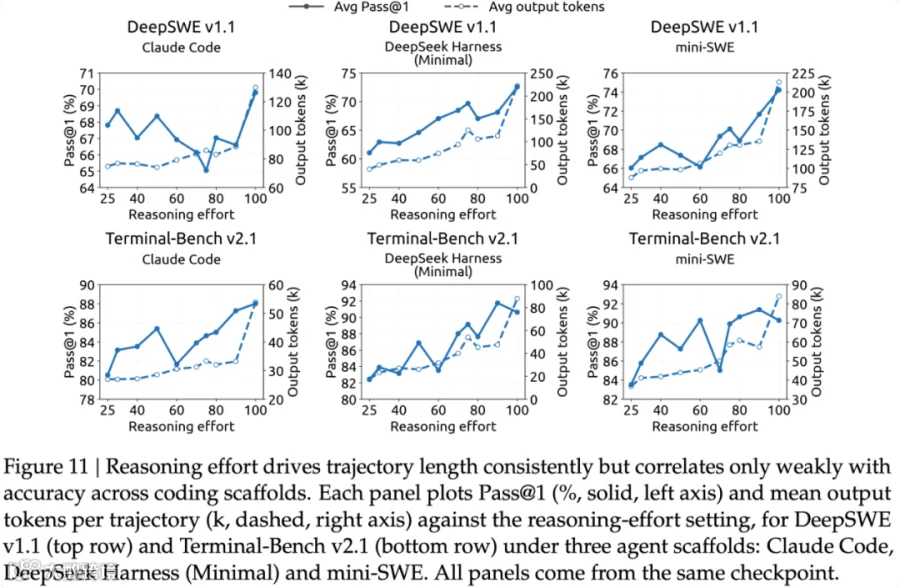
模型表现还受 Agent 框架影响。同一模型在不同框架下(如 mini-SWE、Claude Code、Codex)得分存在差异。此外,DeepSeek 引入了随推理档位变化的长度惩罚机制,提供 low、high、max 三档 API,让用户在成本与性能间灵活权衡。
图|增加推理投入可改善成绩,但存在边际效应递减
回顾 DeepSeek 过去半年的发布节奏,从 V4 Flash 到 V4 Pro,再到 Vision Exp 及如今的 V4.1 Flash,迭代速度前所未有。随着 Benchmark 分数逐渐触顶,行业竞争焦点正从单纯追求高分转向速度与效率的比拼。只要能在保证任务完成质量的前提下持续降低显存、延迟与总成本,模型就将更具竞争力。
【声明】内容源于网络
0
0
APPSO
AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
内容
15741
粉丝
0
关注
在线咨询
APPSO
AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
总阅读
431.1k
粉丝
0
内容
15.7k







 APPSO