

做实时数仓,很多企业遇到的第一个问题不是 Kafka,也不是 Flink,而是:
MySQL 里的数据,怎么尽快进入数仓?
订单、客户、库存、支付、营销活动,大量核心业务数据都在 MySQL 里。
数据量小时,最常见的方式就是写一个定时任务:
每天凌晨同步一次。
后来业务觉得太慢,改成每小时一次;
再后来经营看板要看当天数据,又改成每5分钟甚至每分钟一次。
直到最后发现:
同步频率越来越高,数据却不一定越来越准。
因为真正困难的从来不只是新增数据,而是 Insert、Update、Delete 如何持续、完整地传到下游。
这也是 CDC 开始发挥作用的地方。


假设订单表每天新增100万条数据。
最开始很好办:
WHERE create_time > 上一次同步时间
每天把新订单查出来就行。
可一旦订单发生修改,问题就出现了。
上午10点创建订单:
status = 待支付
10点15分用户完成付款:
status = 已支付
如果任务只根据create_time抽取,第二次状态变化根本进不了数仓。
于是很多项目会增加一个update_time:
WHERE update_time > 上一次同步时间
但这又依赖几个条件:
每张表都有更新时间;
每次业务修改都能正确更新它;
时间边界不会因为任务重跑、数据库时间差等问题发生遗漏。
Delete更麻烦。
一行数据已经从MySQL删除,再通过SELECT查询时,它已经不存在。
你连:
“刚刚删掉了谁?”
都不知道。
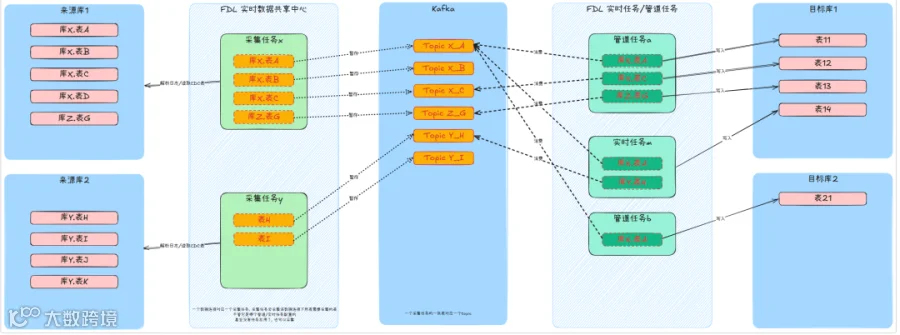
与此同时,同步频率不断提高,也意味着源库不断被查询。
一张几千万、几亿行的交易表,每分钟做一次增量扫描,即使有索引,也会持续占用连接、CPU、IO和网络资源。
所以做到分钟级甚至秒级以后,更合理的思路不是:
更频繁地查表。
而是直接读取数据库已经产生的变化。
MySQL本身会把数据变更记录到Binlog里,Insert、Update、Delete都会形成对应事件。ROW模式下,可以记录具体的行级变化。
这时同步链路也会随之改变。
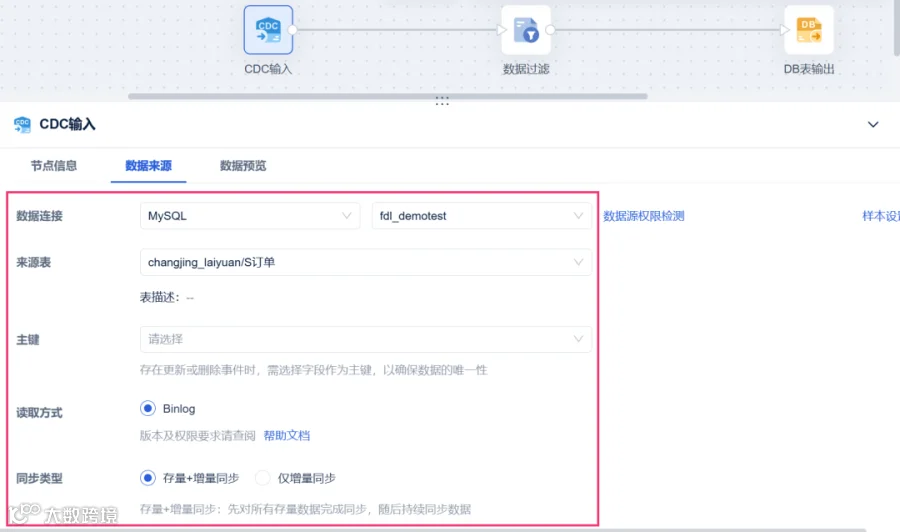
像 FineDataLink 5.0 里配置MySQL实时管道,本质上就是顺着这条Binlog变化往下接:
确定来源库、目标库和需要同步的表以后,可以先跑存量,再持续接后面的增删改;如果目标端本来就已经有完整历史数据,也可以直接从指定起点进入增量阶段。
这和维护几十张、几百张增量SQL是两种思路。
前者是在追踪:
数据发生了什么。
后者是在不断猜:
哪些数据可能变了。


很多人理解CDC,会把它简单概括成:
读取Binlog,然后写进数仓。
但真实项目还有一个绕不过去的问题:
历史数据怎么办?
假设一张订单表已经有5亿行数据。
今天下午3点启动CDC。
如果只从3点开始监听Binlog,那么3点以前的5亿条历史数据并不会自动进入数仓。
因此典型链路会分成两个阶段:
第一阶段:建立存量基线。
把已有5亿行数据完整同步到目标端。
第二阶段:持续消费增量。
把基线之后产生的Insert、Update、Delete继续接进来。
真正容易出问题的地方,就在两个阶段的交界。
假设全量同步需要3小时。
这3小时里,业务系统不可能停机等你。
订单还在新增,库存还在变化,客户资料还在修改。
所以系统必须记住一个明确的日志位置:
“这份存量快照对应到Binlog的哪里?”
存量结束以后,再从正确的位置继续消费变化。
位置早了,可能产生重复;
位置晚了,就可能漏数据。
这也是为什么一个真正可用的CDC方案,除了“能读取Binlog”,还必须考虑:
位点、Checkpoint、重启恢复和目标端幂等。
所谓幂等,就是同一条变化因为故障重试被处理两次时,目标端最终结果仍然正确。
因为实时数据链路里,“永远只处理一次”很难保证。
更现实的设计是:
即使重复处理,也不能把数据写乱。
因此,主键、唯一键和目标端更新策略,从来都不是小细节。


很多项目第一次做CDC,只检查一句:
Binlog开了吗?
这远远不够。
1.Binlog是否开启
首先确认log_bin。
MySQL 8.4默认开启Binary Log,但不同版本、自建环境和云数据库配置并不完全一致,项目里仍然应该实际检查。
2.日志是不是ROW模式
MySQL支持STATEMENT、ROW、MIXED等方式。
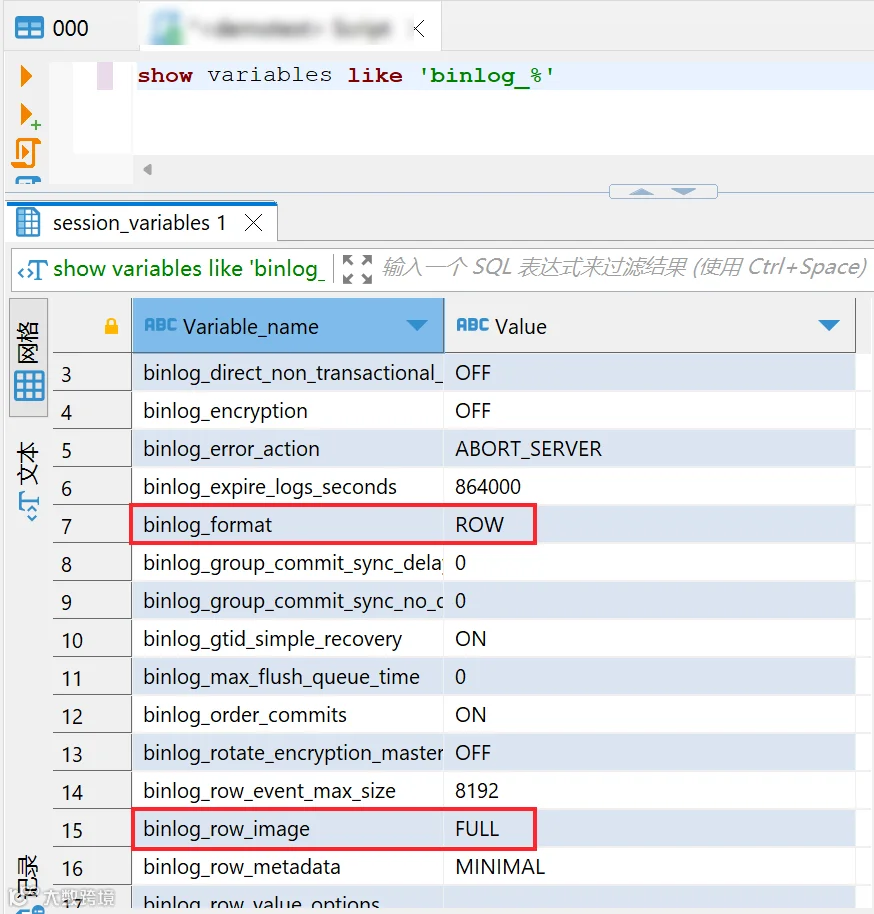
ROW记录的是行级变化,也是CDC常见的基础。MySQL 8.4当前默认使用ROW格式。
还要继续关注binlog_row_image。
因为UPDATE发生以后,日志到底保留多少修改前、修改后的字段,会影响下游解析。

3.Binlog能保留多久
这个问题非常容易在上线以后才暴雷。
假设CDC任务周五晚上停止。
周一上午才恢复。
但周六的Binlog已经被MySQL清理。
即使系统还记得原来的读取位置,也已经找不到对应日志。
所以Binlog保留时间不能随便设。
至少应该覆盖:
最大故障恢复时间 + 运维响应时间 + 安全余量。
4.主键稳不稳定
CDC捕获到id=10086发生UPDATE。
目标端必须能够准确找到同一条记录。
没有稳定唯一键的表,后续UPDATE、DELETE、重复消费都会明显更难处理。
5.表结构会不会变化
真实业务库一定会出现:
新增字段、修改字段名、调整字段类型。
也就是Schema Drift。
CDC任务不能只考虑“数据变了”,还要考虑:
表本身也会变。
真正开始配置几十张甚至上百张表时,这些问题就会从理论变成日常操作。
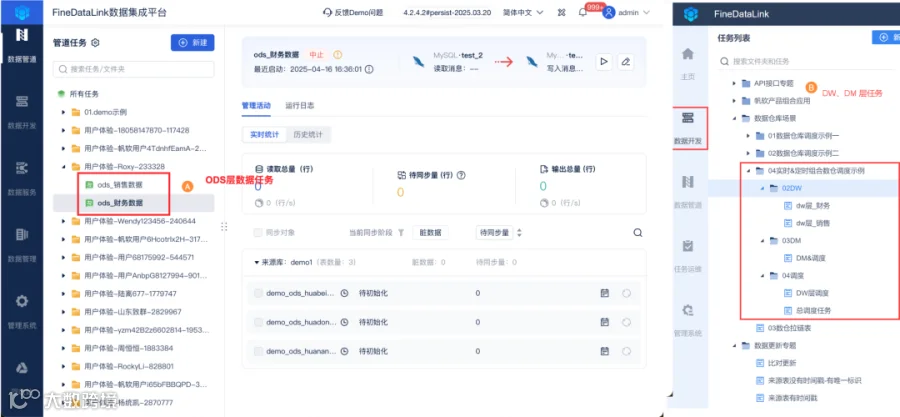
FineDataLink 5.0 的实时管道里,来源表和目标表的对应关系、目标表建立方式、主键以及字段类型映射都集中在同步配置中;
源表新增、删除字段或者修改字段名时,也可以根据任务设置继续同步结构变化。一个任务目前最多可以选取5000张表。

表少的时候,脚本散一点可能感觉不明显。
表多以后,真正麻烦的往往是:
半年后还有没有人知道某张表到底怎么同步、主键怎么配、目标表在哪里。


CDC解决的是变化捕获。
数仓还要解决另一件事:
变化应该以什么形式留下来?
最典型的就是Delete。
假设源端删除了一名客户。
目标端到底怎么处理?
第一种:跟着物理删除
MySQL删除,ODS也删除。
这样目标表更接近源表当前状态。
如果ODS承担的是源系统镜像,这种方式很好理解。
第二种:保留记录,只标记删除
例如增加:
is_deleted = 1
这样数据虽然已经不属于“当前有效数据”,历史记录仍然存在。
为什么很多数仓更在意这种方式?
因为分析经常问的不是:
现在有哪些客户?
而是:
去年12月31日,当时有哪些客户?
如果历史记录全部随着业务库删除,很多历史口径就再也还原不了。
UPDATE也是一样。
订单:
待支付 → 已支付 → 已发货 → 已完成
如果ODS永远覆盖最新值,你只能知道它最终“已完成”。
可一旦要算:
支付耗时、发货耗时、状态转化率,
变化过程本身就有分析价值。
所以CDC落库之前,至少要先想清楚:
ODS到底是镜像层,还是历史事实层?
这也决定了同步工具里的一个小配置最终会产生完全不同的数据结果。
FineDataLink 5.0 的实时管道可以选择源端删除后,目标表执行物理删除,还是保留记录并增加逻辑删除标记;同时还可以记录数据在源数据库实际新增、更新的时间戳。

这个地方不需要追求“哪种方式更高级”。
关键在于:
后面的分析到底需不需要回到过去。
实时同步只是把变化送过来,数仓设计决定这些变化最后能不能成为可解释的历史。


实时链路最危险的状态,并不是彻底挂掉。
彻底挂掉,反而容易发现。
真正麻烦的是:
任务还在运行,
但数据已经慢了、少了或者错了。
至少要长期看四类指标。
第一,延迟
源端10:00产生订单,
目标端10:00:03出现,
端到端延迟是3秒。
如果突然变成15分钟,即使任务仍然绿色,实时分析也已经失去意义。
所以不能只监控任务状态,还要监控:
读取速度、写入速度、积压和数据新鲜度。
第二,失败与脏数据
目标库连接中断、字段超长、类型转换异常、主键冲突,都可能造成部分数据写入失败。
如果一张表失败以后拖垮整个任务,影响范围会进一步放大。
第三,断点恢复
系统重启、网络闪断、Kafka异常都很正常。
关键不是追求永远不失败。
而是失败以后:
能不能从正确的位置继续。
否则一恢复任务就重新做全量,不仅成本高,还可能造成目标端重复写入。
第四,源端和目标端到底对不对得上
这是实时同步最后一道保险。
例如源端有:
100,000,000行
目标端只有:
99,970,000行
任务可能没有明显报错,但已经少了3万行。
这时候必须进一步定位:
-
是哪张表?
-
哪个时间段?
-
哪些主键?
-
是没有读取,还是写入失败?
到了长期运行阶段,FineDataLink 5.0 里能继续看到实时管道的读写统计、运行日志和脏数据;网络波动等情况可以设置失败重试,全量已经结束的任务再次启动时可以从断点继续。
当前版本还支持对来源端和目标端做一致性检测,检测不通过时通知相关负责人。
所以一条CDC链路上线以后,真正应该建立的是三层观察:
-
任务有没有活着;
-
数据有没有及时到;
-
到的数据到底对不对。
只看第一层,远远不够。


如果从头搭一套MySQL实时入仓,可以按照下面这条链路检查:
↓
Binlog ROW
↓
CDC捕获Insert / Update / Delete
↓
传输与缓冲
↓
ODS存量基线 + 持续增量
↓
DWD业务明细
↓
DWS主题汇总
↓
指标、看板、数据服务
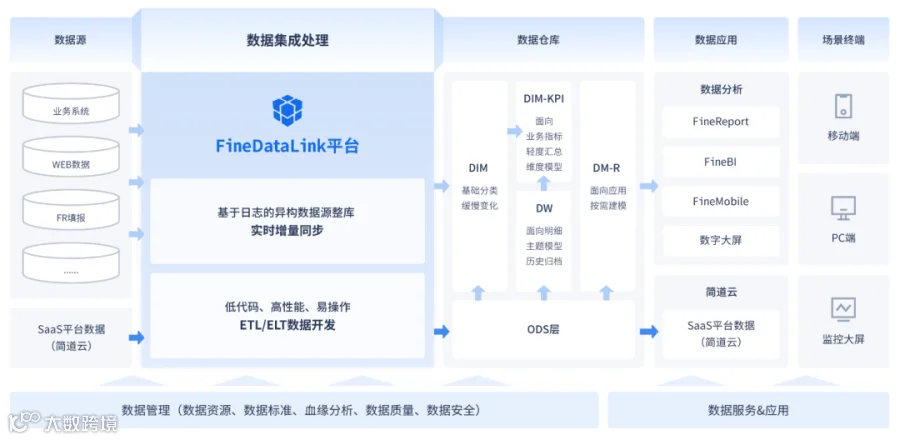
旁边还必须补上另一条保障链路:
前面决定:
数据能不能实时过去。
后面决定:
这条实时链路到底敢不敢长期用。
这也是很多CDC项目做到最后才会发现的一件事:
真正困难的并不是把MySQL数据“搬快一点”。
而是业务库每发生一次变化,下游都要知道:
谁变了、怎么变了、什么时候变的、失败以后从哪里继续、最终有没有正确落下去。
把这些问题想明白以后,CDC才不只是一个“实时同步工具”。
它实际上已经成为实时数仓的数据入口。
而判断一条MySQL CDC链路是否成熟,也可以浓缩成四句话:
-
变化捕获得到,
-
历史衔接得上,
-
故障恢复得了,
-
源端目标端对得上。
做到这一步,MySQL到数仓的实时同步才真正算跑通。

