

几周前,我使用 Cursor 进行了一次长时间的调试,随后意识到了一件奇怪的事。
AI 变得昂贵,并不是因为它在“思考”。而是因为它在读取太多无用信息。
日志。JSON blob。工具输出。Stack trace。SQL 结果。重复的上下文。
成千上万个 token。其中大多数是什么?噪声。这就是 AI Agent 隐藏的成本。而这正是 Headroom 改变游戏规则的地方。
Headroom 是我最近见过最实用的 AI 基础设施组件之一。
不是又一个 Agent framework。
不是又一个 orchestration layer。
也不是又一个“5 分钟构建 autonomous agents”的库。
它解决的是实际的瓶颈:
上下文膨胀。
对于构建 AI 系统的开发者来说,这比模型质量更重要。
因为如果你的上下文发生了膨胀,成本就会爆炸。
Github:https://github.com/headroomlabs-ai/headroom
Headroom 到底是什么?
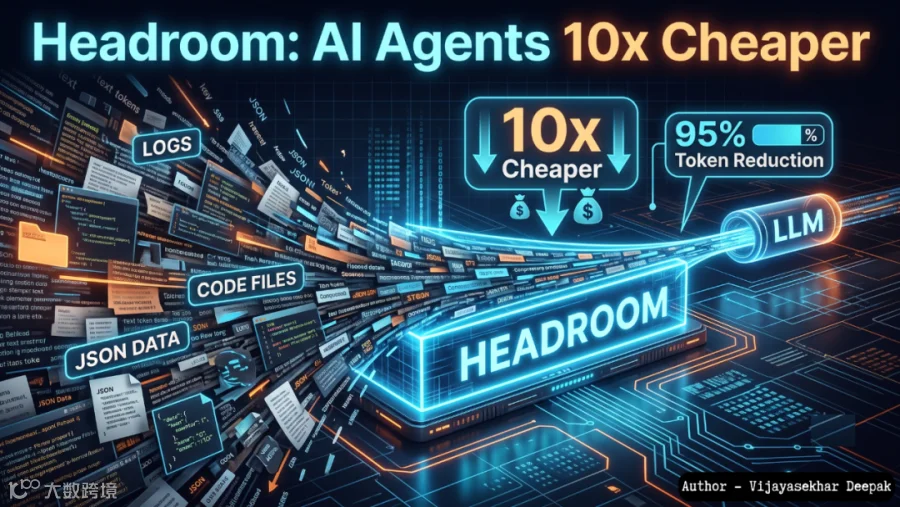
可以把 Headroom 理解为 Agent 与 LLM 之间的智能压缩层。
普通流程:
Agent → Tool Calls → Raw Data → LLM
使用 Headroom:
Agent → Tool Calls → Headroom → Compressed Context → LLM
Headroom 会在以下原始数据发送给模型之前对其进行压缩:
API 响应
日志
文件内容
RAG chunks
数据库结果
终端输出
结果呢?
根据官方基准测试:
减少 60–95% 的 token
输出质量不变
推理速度更快
账单更低
这非常惊人。尤其是当你运行生产环境中的 Agent 时。
为什么 AI Agent 会变得如此昂贵
大多数开发者认为模型定价才是问题所在。
错了。
真正的问题是:
1. 工具输出充满噪声
示例:
一次 npm install 日志就可能超过 8,000 个 token。
你的 Agent 可能只需要:
Build failed at package X
而不是完整的日志。
2. RAG 会发送无关 chunks
你的 vector DB 返回 20 个 chunks。Agent 只需要 2 个,却要为全部 20 个付费。
3. 读取文件非常浪费
Agent 读取一个 500 行的文件,但只需要其中 15 行。你却要为 500 行付费。
4. 对话历史不断增长
每次交互都会增加更多负担。这会变成 token 滚雪球。Headroom 会在雪球变成雪崩之前将其截断。
Headroom 的内部工作原理
这部分就很有意思了。Headroom 使用三个主要层:
1. CacheAligner
它会优化重复的前缀,以便 providers 可以复用 KV cache。对于 Anthropic 的 Claude 等模型来说,这一点非常重要。
含义是:
相同的上下文 = 更低的读取成本。
Headroom 会组织 prompts,以最大化 cache 命中率。仅这一点就能显著降低成本。
2. ContentRouter
并不是所有数据都应该使用相同的方式进行压缩。Headroom 会检测内容类型:
JSON
Logs
Code
Text
XML
CSV
然后根据内容类型进行路由。这比通用 summarization 更智能。因为糟糕地总结 JSON 可能会破坏其含义。
3. CCR(Compressed Context Retrieval)
这是杀手级功能。大多数压缩工具都会丢失数据,而 Headroom 会将原始内容存储在本地。
如果 LLM 需要更深层的细节:
它可以检索原始内容。
这使压缩变得可逆。
这一点非常重要。
因为它解决了人们最大的担忧:
“如果压缩移除了某些重要内容怎么办?”
Headroom 的使用方式
这正是开发者喜欢它的原因。它非常灵活。
选项 1:Python SDK
   from headroom import compress

compressed = compress(messages)
就这样。
可以轻松集成到:
LangChain
LangGraph
自定义 Agent
💡 喜欢这篇文章吗?
每个工作日,我都会发布实用、可用于生产环境的深度文章,涵盖 Web 开发、系统设计、开源项目、科技行业趋势以及 AI Engineering 和工具。
👉 免费订阅 Vijayasekhar Deepak 的 Newsletter
加入 600 多名不断提升技术栈的开发者。绝不发送垃圾邮件。
选项 2:Proxy 模式(无需修改代码)
这是我最喜欢的方式。
运行:
headroom proxy --port 8787
将你的 AI 应用指向:
http://localhost:8787
搞定。
无需修改代码即可完成压缩。
选项 3:包装现有的 Coding Agent
这很不可思议。Headroom 支持:
Claude Code
OpenAI Codex
Cursor
Aider
GitHub Copilot
示例:
headroom wrap claude
简单得令人难以置信。
Headroom 的实际开发者使用场景
这正是 Headroom 大放异彩的地方。
1. 调试生产环境日志
不使用 Headroom:
50k tokens。
使用 Headroom:
4k tokens。
仍然保留足够的信号。非常适合 DevOps。
2. 分析大型代码库
AI Agent 扫描:
200 个文件
大型目录
依赖项
Headroom 会压缩噪声,同时保留与架构相关的数据。
3. RAG 系统
这是一个重要场景。RAG 系统会过度获取数据。Headroom 会压缩检索到的 chunks。
这会减少幻觉并降低成本。
4. Multi-Agent 系统
多个 Agent 共享 memory?Headroom 会对上下文进行去重。
这对于 orchestration 来说非常重要。
为什么 Headroom 优于 Summarization
人们经常混淆这两者。它们并不相同。
Summarization:
不可逆
会丢失细节
经常产生幻觉
Headroom:
具备压缩感知能力
结构化
可逆
确定性
这是基础设施级别的可靠性。差别很大。
优点
大幅节省成本
有时能降低 10 倍,有时更多。
响应速度更快
上下文更少 = 延迟更低。
易于采用
Proxy 模式非常出色。
Local-first
你的数据会保留在自己的机器上。对于隐私来说非常重要。
几乎兼容所有东西
不会被厂商锁定。
缺点
我们实话实说。没有什么是完美的。
压缩可能会隐藏边缘场景的细节
这种情况很少见,但确实可能发生。尤其是在高度依赖上下文的调试场景中。
增加了另一层基础设施
更多活动部件。也需要更多监控。
并非所有工作负载都能同等受益
短 prompts 不会获得太多收益。大型上下文则会。
可能出错的地方(以及为什么这很重要)
开发者应该思考这一点。不良行为者也可以使用 Headroom。
例如:
以更低成本扩展 spam Agent
更多自动化。更低成本。更多滥用。
大规模 scraping pipelines
压缩大规模爬取内容。以更低成本进行提取。
更快的恶意代码生成循环
成本更低 = 迭代更快。
落入错误的人手中会很危险。这不是 Headroom 的错。
它是基础设施。
就像 Docker。
就像 Kubernetes。
工具会放大使用者的意图。永远如此。
作为一名工程师,我的看法
Headroom 让人感觉像是那种“事后看来显而易见”的想法。AI 行业花了两年时间优化模型。
但上下文呢?
仍然膨胀。
仍然低效。
仍然昂贵。
Headroom 直击真正的低效之处。这就是它重要的原因。
我认为,未来 12 个月内,每个严肃的 AI 技术栈都会包含某种形式的:
上下文压缩
智能缓存
可逆检索
Headroom 只是更早实现了这一点,并将其开源。
这非常强大。
你应该使用它吗?
如果符合以下情况,请使用 Headroom:
✅ 你正在构建 AI Agent ✅ 你使用 RAG ✅ 你处理日志 ✅ 你进行长时间的编码会话 ✅ 你关注 token 成本 ✅ 你使用大量依赖工具的工作流
如果符合以下情况,可以跳过:
❌ 你的 prompts 很短 ❌ 你的工作流很简单 ❌ 目前 token 成本对你来说并不重要
但对大多数开发者来说?
现在就值得了解它。因为 AI 并不会变得更便宜。上下文优化正在成为竞争优势,而 Headroom 正在引领这一转变。
最后的想法
下一代 AI 基础设施不会只关注更智能的模型,也会关注更智能的上下文。而这将改变一切。
感谢阅读!
希望这篇文章对你有所帮助并且内容有启发。如果你有任何问题或反馈,欢迎在下方发表评论。你的支持和参与对我意义重大。