2026年9月11日,陶哲轩把一封公开信贴上了自己的博客:《人工智能在数学中的严重错位》,共同署名的是25位菲尔兹奖得主,名单从1978年的德利涅一直排到2026年的邓煜。
信里没有一句话说"AI 不该做数学"。它承认 AI 有加速真正数学研究的潜力。它反对的是另一件事:匆忙宣布,来不及写出像样的论文,来不及提炼新方法,来不及引用他人在先的工作。
信中最值得软件行业抄在白板上的,是这一句判断:
解决问题只是一种工具,是通向首要目标——概念性的理解与洞见——的替代指标。在 AI 的世界里忘记这一点,可能会使工具反过来对抗首要目标。
Keras 作者 François Chollet 补了一个更难量化的观察:他在数学学生中听到一种非常普遍的情绪——"我不想再当数学家了"。AI或许不会在功能上取代数学家,但完全可能通过压垮年轻一代的心气,造成事实上的近乎灭绝。
现在换成软件工程。同样的三个词——匆忙、归属、传承——听起来是不是有点耳熟?
但我想先说一句可能让一部分读者不太舒服的话:
软件工程和数学不一样,而且这个不一样,恰恰是这篇文章最重要的前提。
数学的最终产品是理解,定理只是理解的副产品。软件工程的最终产品不是理解,是能用、能改、出事能收拾的系统。没有人要求交付一个电商结算服务时附带"概念性洞见"。
所以,如果论证只是"数学有危险,软件也有危险",那是廉价的类比。真正的问题要精确得多:
软件工程本来就不以理解为目的,那它到底为什么还需要理解?当理解变得昂贵而代码变得免费,这门学科会失去什么?
一、软件工程的诞生,恰恰因为"仅仅程序能运行"还不够
软件工程不是因为程序员打字太慢才诞生的。
1968年 NATO 那场会议之所以成为学科起点,是因为当时的"软件危机"暴露了一个事实:人们完全有能力写出能运行的程序,却越来越无法在规模变大之后,按时、按预算、以可接受的质量交付系统。
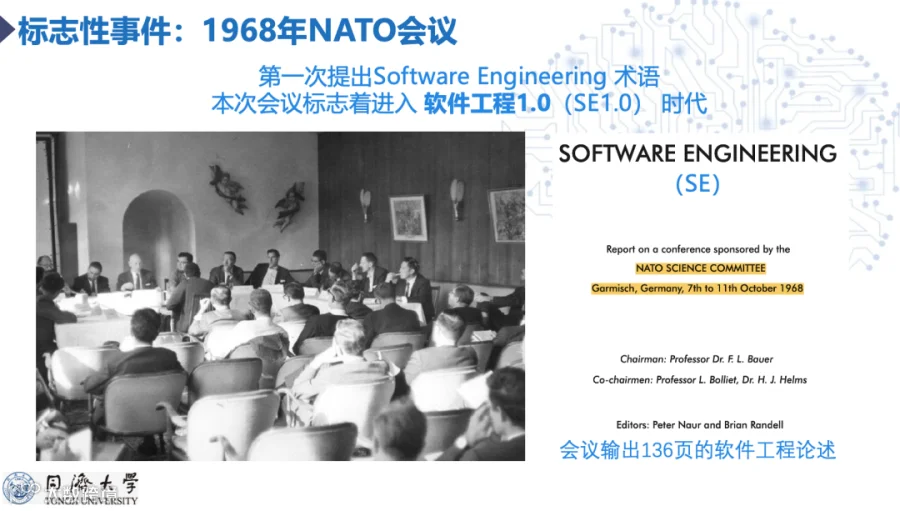
把程序写出来,和把软件建设好,从来不是同一件事。
布鲁克斯在《没有银弹》里区分了本质困难与附属困难:工具可以消除表达和实现上的障碍,但概念结构的复杂性、现实约束和持续变化不会随之消失。
AI确实可能开始触碰一部分本质困难,这点要诚实承认。但"模型完成了实现"仍然推不出"工程问题已经解决"。
拿一个退款接口举例。生成代码是几分钟的事,真正难的是:
-
同一请求重复到达,会不会重复退款? -
支付渠道超时,是交易失败,还是成功后响应丢了? -
服务在资金划出之后、状态落库之前崩溃,怎么恢复? -
旧版本服务和新版本数据库同时在跑,一致性还成立吗? -
出现纠纷时,审计记录能不能还原事实?
这些问题 AI 并非答不出。关键在于:它们必须先被识别,再被固化成设计约束、验证证据和运行机制。一段能跑通的代码,本身不证明这个过程发生过。
这里要防住一个滑坡:我不是在说"工程师应当享受理解的过程"。理解在软件工程里不是审美偏好,是风险管理手段。
系统会不断演化,也会出故障。演化和出故障的时候,必须有人或某种可靠机制能接管。理解的全部正当性,就在这一句。
所以软件工程真正的定义是:它是对代码进入现实世界之后所承担责任的系统性回答。
二、真正的错位:把容易展示的产出,当成难以衡量的价值
公开信批评的是一种熟悉的替换:本来用解题进展来观察理解的进展,最后只剩下追求解题成绩。
软件行业有自己的一整套替代指标,而且历史悠久。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
这些指标都有用。问题只有一个:指标能提供证据,不能代替目标。
而这一次,我们有实测数据。
2025年,独立评估机构METR做了一项随机对照实验:16 位经验丰富的开源开发者,在自己熟悉的成熟仓库里完成246个真实任务。开始前,他们预计AI会让完成时间缩短 24%。实验结束后,他们自我感觉快了约 20%。
实际测量结果是:使用AI工具时,任务完成时间增加了19%。时间主要流向了提示、等待和审查 AI 产出。
这项研究必须被谨慎解读:样本小,是早期2025年的工具,针对的是资深开发者在自己烂熟的大型代码库上作业——这恰恰是AI最不占优势的场景。METR 自己在 2026年2月也发文调整了实验设计。换一批人、换一类任务,结论完全可能反过来。
但它留下的那个缺口比结论本身更有价值:
感知提速 20%,实际减速 19%,中间有近40个百分点的认知偏差。
这才是"错位"在软件行业里最具体的形态。不是AI没用,而是我们评估自己是否变快的能力,比我们变快的速度退化得更早。
从需求到生产,要经过澄清、设计、实现、审查、集成、发布、运行。加速其中一环,瓶颈只会转移到下一环:实现快过审查,待合并队列变长;合并快过验证,缺陷流向生产;发布快过组织吸收,维护成本抬头。
生成端省下的时间,往往以审查、返工和事故的形式,在生命周期的另一端重新出现。
更深一层的错位在利益结构上:工具供应商要展示自动化能力,管理者要展示效率增长,工程团队承受长期系统后果。三方并非天然对立,但只有把生命周期成本算进同一张表,短期激励才可能和长期价值对齐。
所以,"我们90%的代码由AI编写"只是一句关于生产方式的描述。它不是质量证明,也不是效率成绩单。
AI没有发明我们对速度的迷恋,它只是让一个老问题变得无法回避:
我们究竟在奖励软件变好,还是在奖励软件变多?
三、AI时代更隐蔽的负担,可能是"认知债务"
技术债务的含义大家都熟:今天选了省事的方案,未来要付更高的修改成本。
AI 辅助开发可能放大另一种负担——认知债务:系统已经交付,但组织没有建立与其复杂性和风险相匹配的理解与控制能力。
两者的差别可以这样说:
技术债务是"我们知道这里欠了一笔账";认知债务是"我们连账记在哪里都不知道"。
代码可能写得很好。结构整洁、命名规范、测试充分、注释详尽。但团队仍然可能答不出:
为什么选了这种一致性方案?哪些业务约束绝对不能破坏?那个奇怪的特殊分支当初在防什么故障?哪个依赖一旦升级,整个设计的前提就不成立?
于是出现一种荒诞状态:代码刚刚生成,就已经像一个无人接手的遗留系统。
公平地说,这不是 AI 的专利。人员流失、草率外包、长期没有知识管理,都能制造认知债务。AI的特殊之处在于实现的增长速度,可以远远甩开组织理解的增长速度。
彼得·诺尔在 1985 年那篇Programming as Theory Building里说过:编程的产物不只是程序文本,还有程序员脑中关于问题、现实与解决方案的"理论"。程序可以被完整保存,理论却会随着人的离开而消失——这正是为什么很多遗留系统明明源码齐全,却无人敢动。
这也解释了一个很多人忽略的陷阱:AI 自动生成的设计文档,不能自动证明设计知识已经沉淀。它可能忠实记录了取舍,也可能只是给既成实现补了一段流畅的事后合理化叙述——读起来完全一样。
真正有价值的设计记录只回答四个问题:考虑过哪些方案,为什么排除了其他方案,这个选择依赖什么假设,什么变化会让它不再成立。
必须强调:这不要求人类逐行理解所有代码。现代软件本来就建立在编译器、数据库、操作系统和云服务这些黑盒之上,没有人理解全部细节。
我们需要的是与风险相匹配的理解:可以不懂数据库的实现,但必须清楚它的事务隔离提供什么、不提供什么;可以不读组件的每一行,但必须知道它的接口契约、故障模式和适用边界。
这种理解也不必全部来自人脑。它可以由AI、静态分析、契约、运行时守卫共同承担。
但理解可以被分担,不能被跳过。关键理解不应该等到凌晨三点的事故电话里,才第一次被提出需求。
四、测试通过、形式化验证通过,也不等于工程问题已经结束
AI 生成代码,再生成测试,最后解释测试为什么通过——这算不算一个完整的质量闭环?
可能算,也可能只是同一个误解被写了三遍。
实现和测试,如果建立在同一个错误假设上,它们会彼此完美吻合,然后共同偏离现实。
软件工程之所以要区分两个问题,原因就在这里:V&V
-
验证(verification):我们是否按规格正确地构建了系统? -
确认(validation):我们构建的,是否是真正需要的系统?
一个退款程序可以完美满足"累计退款不超过原付款额",同时完全没有处理账户冒用、跨币种结算和商家与平台的责任划分。
公开信发布前三天的 Navier-Stokes 争议,恰好提供了一个精确的例子:OpenAI 的证明在 Lean中完成了形式化验证——机器检查无误——但争议立刻转向了它施加的那个光滑外力项,而克雷研究所的标准表述针对的是无外力情形。
证明本身没有问题。出问题的是"证明覆盖了什么"这个边界判断。而边界判断,机器没有替你做。
这是软件行业最该记住的一课:形式化方法能在明确假设和可信基础之上,为特定性质提供极强的保证。它不保证规格完整,不保证被形式化的对象就是你真正想要的对象。
证明没有失效;危险的是我们把证明的射程想得过大。
软件运行在开放、变化、充满故障的环境里,所以可信度必须分层建立:类型系统和契约约束局部行为,测试与静态分析发现缺陷,必要时用形式化方法证明关键性质,灰度发布限制爆炸半径,监控、回滚和应急预案兜住剩余风险。
这意味着软件工程不必像数学界那样只能"呼吁慢一点"——它有能力把要求变成机制:
-
高风险操作设置独立于生成过程的授权; -
验收标准不能由生成实现的同一条链路自证; -
变更可追踪、影响可限制、上线可撤回; -
运行时持续校验关键不变量,而不只在 CI 里检查一次。
这些机制同样可以大量使用 AI。重点不是所有检查都由人手工完成,而是证据是否具备足够的独立性。
AI 越能自主行动,工程越必须写清楚:它被允许改变什么,用什么证据证明安全,出事之后如何收回控制权。
五、比岗位数量更深的变化,是工程师如何成长
"AI会替代多少程序员"是个重要问题。但还有一个时间尺度长得多的问题:
如果初级工作被自动化,未来的资深工程师从哪里来?
过去,一项初级任务同时生产两样东西:一个被修好的缺陷,和一个更懂系统的人。
工程师是在读旧代码、定位问题、被评审打回、参与事故复盘的过程中,慢慢长出判断力的:哪些需求其实没说清,哪个看似局部的改动实则危险,什么抽象撑得住变化,什么时候不该再加一个新服务。
AI 可以直接交付第一样产出,却不保证第二样随之发生。
如果组织只把初级岗位理解成"廉价的代码产能",结论几乎是自动的:代码能自动生成了,那就不必再为这些岗位付钱。
但省下培养成本,和提高生产效率,是两回事。
把培养新人的环节整体自动化,可能是在用未来的人才供给,补贴今天的效率报表。
这不等于必须保留所有枯燥劳动。反复敲样板代码培养不出判断力;新人对着陌生报错独自挣扎五天,也未必强过得到一次像样的指导。
需要保护的不是低效率,而是必要的认知参与。
AI完全可以是极好的导师:解释遗留代码、构造反例、模拟故障、比较设计方案,让新人比过去更早接触完整系统。但训练必须保持一个顺序——先判断,再看建议,最后解释自己为什么接受或拒绝。
具体可以要求新人:
-
在生成实现之前,先写出关键约束与失败条件; -
拿到两个都能跑的方案,说明长期取舍; -
为模型给出的程序设计一个能让它失败的用例; -
在需求变更和故障注入下修改、运行并恢复系统; -
在没有现成答案时,提出可验证的诊断假设。
最后回到Chollet那句话。数学学生说"我不想再当数学家了",软件行业同样可能听到"我不想再当工程师了"。
士气不是软性话题。一门学科可以在岗位还在的情况下先失去人心——年轻人不是被裁掉的,是被劝退的。
他们需要看到,软件工程没有退化成"在模型输出后面点确认"。识别值得解决的问题、驾驭复杂系统、创造更好的抽象,仍然是有智力尊严的工作。
一门学科能否延续,不只看它今天交付了多少产品,更看它是否还在培养明天能提出新问题的人。
六、当代码越来越便宜,开源社区会因代码泛滥而失控,公共代码资产会消失吗?
一个看起来自相矛盾的未来,正在变得可以想象:
公开代码越来越多,真正值得依赖的公共软件却越来越难找。
因为开源社区的稀缺资源从来不是代码。是维护者的注意力,是可信的贡献关系,是持续积累的工程判断。
1. 生成代码可以免费,判断代码是否值得合并从来不免费
这已经不是设想了。
curl项目维护者Daniel Stenberg在2024至2025年多次公开表达对AI生成安全报告的不满:涌入的漏洞报告写得格式工整、术语专业、语气笃定,实际上是编造的。团队必须逐份认真核查,因为真漏洞和假漏洞在文本上已经无法区分。2025年5月,他宣布对HackerOne提交实行更严格的AI使用披露与处理策略——原因不是报告太差,而是它们太像真的,浪费的正是最稀缺的那种注意力。
这就是那种不对称:
贡献者点一次生成,维护者付出几小时的判断与沟通。
低质量贡献当然不是AI发明的,AI也确实能帮助筛选和审查。但当输入规模超过处理能力,社区的理性反应就是提高门槛、限制提交、关闭部分渠道。
结果很讽刺:机器把贡献入口拓宽了,注意力压力却把协作入口收窄了。真心想学习的新贡献者,要一起承担这个收缩的代价。
而2024年的 xz-utils后门事件提醒我们另一件事:当维护者精疲力竭时,系统性风险是从人的关系里进来的,不是从代码语法里进来的。攻击者花了两年时间取得信任、接手维护权。对手利用的从来不是代码不够多,而是愿意认真看代码的人不够多。
2. 公共资产不会被删除,它会失去维护、出处和可发现性
一个无人维护的仓库仍然可以clone;一段来源不明的代码仍然可以复制;一个三年没人回复的issue仍然公开挂着。
但"可以访问"和"可以放心依赖",是两件事。
公共软件的价值不只在源文件里,还在这些关系里:
-
哪个版本值得用; -
哪些问题已知但未修; -
谁能解释设计边界; -
安全修复由谁发布; -
贡献遵循什么规则; -
新人如何一步步成为维护者。
这些关系一旦断掉,代码还在,公共资产的有效价值却大幅缩水。
还有一层更隐蔽的损耗:当生成工具只返回一段答案,不保留来源、文档入口和贡献路径,使用者拿到了代码,却失去了通往那个知识共同体的道路。他不知道该向谁提问,也不知道自己有一天可以成为回答的人。
许可证与训练数据的问题要依据具体事实和法律判断,把所有 AI 输出一概称为侵权既不准确也无益。但维护出处、履行适用的许可证义务、为关键依赖的维护出钱,是明确无疑的工程责任。
3. 开源不只是公开代码,更是公开"为什么"
开源社区是人类规模最大的一所分布式工程学校。
人们从代码里学"怎么做",从code review里学"为什么这样做",从被拒绝的PR里学"为什么不做",从事故复盘里学"当初的判断错在哪"。
这正好对应公开信里那条最沉重的判断:如果没有愿意接手的人去发展这些思想、把它们整合进正典,AI构想的想法永远不会真正活起来,那条关键的人类传承链会就此断掉。
开源就是软件行业的那条链。
好消息是这并非不可逆。AI同样可以改善文档、解释历史设计、翻译语言障碍、帮维护者从噪音里挑出真正重要的问题。它降低参与门槛的潜力是真实的。
但治理必须跟上:要求提交者说明真实问题、验证方法和后续维护意愿;对高频自动提交实施速率限制与披露要求;完整保留设计讨论与贡献归属;让受益最大的企业为关键项目的维护付费,而不是只赞助新功能发布会。
开源不会仅仅因为代码太多而死。真正的死因是:代码无限增长,而愿意理解、筛选、维护和传承它的人持续减少。
七、软件工程需要重新定义成功,而不是保卫旧工作方式
写到这里,必须挡住一个很容易滑过去的结论:人写的代码天然可靠,AI写的代码天然危险。
这不成立。人类同样忽略边界条件、制造漏洞、留下无人能解释的系统。而AI正在实实在在地帮我们啃遗留代码、扩大测试覆盖、构造反例、把形式化方法的使用成本压下来。
需要改变的不是工具准入名单,是成功的定义。
1. 对企业:从产出指标,转向生命周期结果
评估 AI 工具,不能只看生成速度。要看端到端交付时间、审查与返工成本、生产缺陷、事故恢复时间,以及最终用户拿到了什么。
METR那个"感知+20%、实测−19%"的缺口给出的第一条行动建议非常朴素:别用问卷衡量效率。自我感觉是所有指标里最不可靠的一个。
交付标准也不能只有"功能完成",应按风险分级,包含关键约束、验证证据、运行责任和恢复方案。
还有一条最容易被忽略:要允许"少写代码"成为成绩。拒绝一个不必要的需求,删掉一个冗余依赖,合并两个重复服务——这些可能比自动生成一万个文件更有价值。
当生成变得几乎免费,判断什么不该被生成,就成了最昂贵的能力。
2. 对教育:从完成答案,转向形成判断
既教学生用AI,也检验他们是否具备独立判断的底座。
考核应从一次性提交答案,扩展到需求澄清、方案比较、代码解释、故障定位和持续演化。参考:AI时代,重塑软件工程教育的新范式
保留必要的无辅助训练是对的,但目的不是证明人能重复机器的全部工作,而是确保当机器不可靠时,人还能识别问题并接管。
同时,组织要为新人训练安排真实的预算、导师和机会,而不是默认资深工程师会永远从别处凭空招到。参考:教师的快乐,也许正来自新的使命
3. 对研究:从生成能力,转向可信演化能力
代码生成只是软件工程研究的一小块。更该被研究的是:
-
如何把模糊意图转成可机器检查的约束? -
如何限制智能体修改系统的权限与影响范围? -
如何让验证证据随版本持续有效,而不是一次性通过? -
如何识别多个智能体共享的同一个错误假设? -
如何长期度量 AI 对维护成本、协作质量和人才成长的影响? -
如何把生成结果沉淀为可复用、可解释、可传承的知识?
这些问题不会因为模型更强而消失。模型能承担的任务越多,它们越紧迫。
软件工程要建立的,不是"机器永远学不会工程"的证明,而是一套方法:让越来越有能力的机器进入工程之后,系统仍然可信,组织仍然可控,知识仍然在积累。
结语:代码可以自动生成,信任不能自动成立
公开信的最后一段是这样写的:
数学是第一个被逼到台前、必须把自己的价值观明确写下来的学科。它不会是最后一个。
软件工程很可能是下一个。而且我们的处境比数学更尴尬一点:数学界至少还在争论"这样不对";软件行业已经把生成量写进了季度汇报的第一页。
但我们也有数学没有的优势。数学界面对 AI 公司只能发公开信——他们没有强制力,AI公司没有义务放慢节奏。软件工程不一样:评审规则、准入门槛、发布流程、验收标准、招聘预算,这些东西本来就握在我们自己手里。
所以这个问题从来不是一道等技术揭晓的预测题,而是一道制度设计题。
它具体地存在于:一份把生成行数当生产力的报表里,一次为了赶工被取消的设计评审里,一个"今年不招应届生了"的决定里,一位维护者面前那条永远处理不完的提交队列里。
AI不会因为更擅长写代码,就必然摧毁软件工程。它甚至很可能帮这门学科更充分地兑现自己的承诺。软件工程3.0三年之路:从概念到规模化落地的探索与实践
但如果我们把工程简化为生成,把评审简化为点确认,把培养简化为工具培训,把开源简化为免费的代码来源——那么这门学科确实会被掏空。仓库依然繁荣,交付照常进行,理解与传承却不再增长。
真正的分界线,不在于代码由人写还是由机器写,而在于技术是被用来增强工程能力,还是被用来免除工程责任。
所以值得整个行业回答的问题,不是"AI 能替我们写多少代码",而是:
当生成越来越便宜,我们还愿不愿意为判断、验证、维护与传承付钱?
答案不在下一代模型的参数里。它在今天的预算表、课程大纲、评审规则和每一次组织选择里。
代码可以自动生成,信任不能自动成立。