

信息来源:https://newsletter.semianalysis.com
谷歌自研TPU芯片已将近10年的时间,整个行业见证谷歌基于自研硅芯片构建起庞大技术帝国。谷歌拥有搜索、广告、YouTube等各种业务,同时Gemini 大模型也运行在TPU之上。TPU的成功离不开谷歌自身业务的支持与不断反馈。
现在的TPU,已经逐渐趋于成熟, 不再局限于谷歌内部使用,开始对外开放算力租赁或者直接对外进行芯片销售。
Anthropic 已经成为 TPU 最大的使用者,Anthropic高度认可TPU,已承诺采购超百万颗 TPU(约40万颗直接采购,60万颗通过GCP租赁),主要用于训练,同时也承担推理负载。其 TPU 使用规模将在 2029 年超过 DeepMind 自身的用量。

TPU相比GB200\GB300的性价比优势
谷歌内部使用 TPU 取得成功,这一点从无争议。真正的问题在于:行业其余参与者究竟能从这套技术中获得多少红利?
海外机构semianalysis对TPUv7 Ironwood的首批第三方推理实测数据中显示,对比 B200/B300,Ironwood 可以实现最高50% 的每美元性能提升。
TPUv7 Ironwood是谷歌第一代面向外部推理业务竞争的芯片,客户既可以直接采购硬件,也能通过谷歌云租赁使用。
在 FP8 聚合服务、单 token 预测的公平对照测试中,TPU 对比 FP8 模式运行的 B200、B300,每美元性能最高提升 50%。如果英伟达 GPU 采用 FP4 推理,会出现输出质量损失;TPUv7 没有原生 FP4 计算单元,因此 FP4 场景下英伟达 GPU 依旧领先。TPUv8i 将具备原生 FP4 硬件支持,因此我们认为 TPUv8i Boardfly 将可以与 Rubin NVL72 一较高下。
在用户交互速率 100token/s/ 用户的条件下,Ironwood 每百万总 token 成本约 0.181 美元;B200 为 0.222 美元,B300 为 0.276 美元。同等单用户生成速度下,TPU 成本比 B200 低约 19%,比 B300 低约 34%。
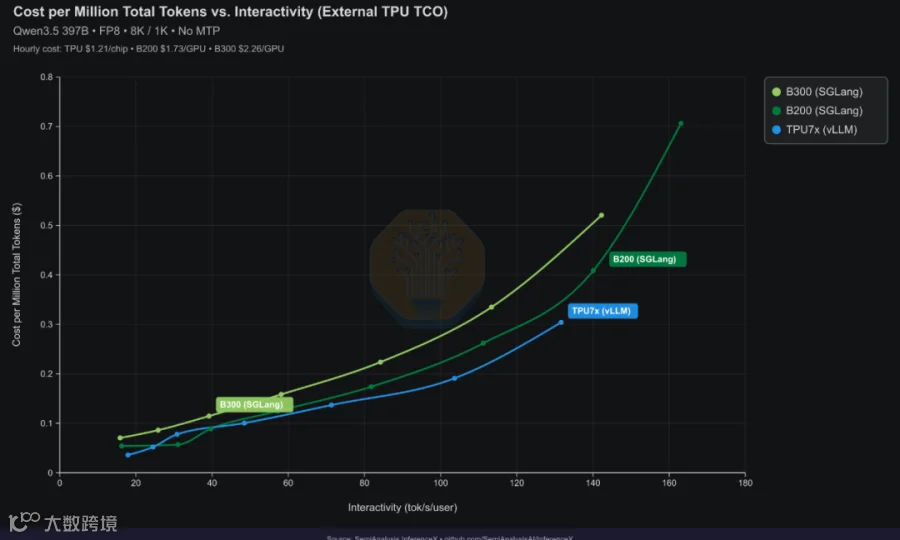
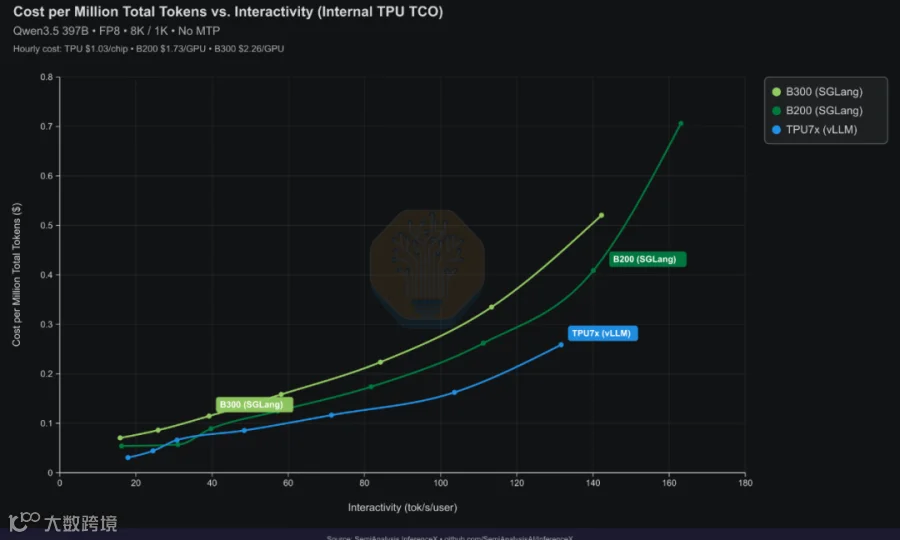
需要注意的是,在绝大部分原始吞吐量曲线上,TPU 绝对峰值性能并不优于英伟达 GPU;但单纯峰值对比忽略了 TPU 更低的 TCO。TPU 采购方最关心的是业务收益,即每美元性能、每瓦性能。
在交互速率 20token/s/ 用户的场景,Ironwood 原始吞吐量实现反超:单芯片总 token 吞吐 9364 token/s;B200 为 8903 token/s,B300 为 8925 token/s。该测试下 TPU 吞吐量相比两款 GPU 高出约 5%。叠加更低的小时成本之后,Ironwood 每美元产出 token 数量相比 B200 高出 50.4%,相比 B300 高出 96.0%。

如果采用谷歌内部 TPU TCO(单芯片小时成本 1.03 美元),并发 256 场景下,每美元性能优势扩大至:超 B200 达 76.7%,超 B300 达 130.2%。但高并发会带来延迟代价。例如并发 256 时,TPU 平均首 token 生成时间 TTFT 为 5.41 秒;B200 是 3.75 秒,B300 仅 2.40 秒。上文 50%‑96% 的性能优势特指该测试点,并不适用于全部延迟指标。

看端到端延迟指标,在超过最高吞吐测试点之后,Ironwood 依旧具备竞争力。当中位响应时间 20 秒,帕累托最优曲线上 TPU 每百万总 token 成本约 0.098 美元;B200 为 0.106 美元,B300 为 0.132 美元。TPU 相比 B200 成本低约 8%,对比 B300 低约 25%。
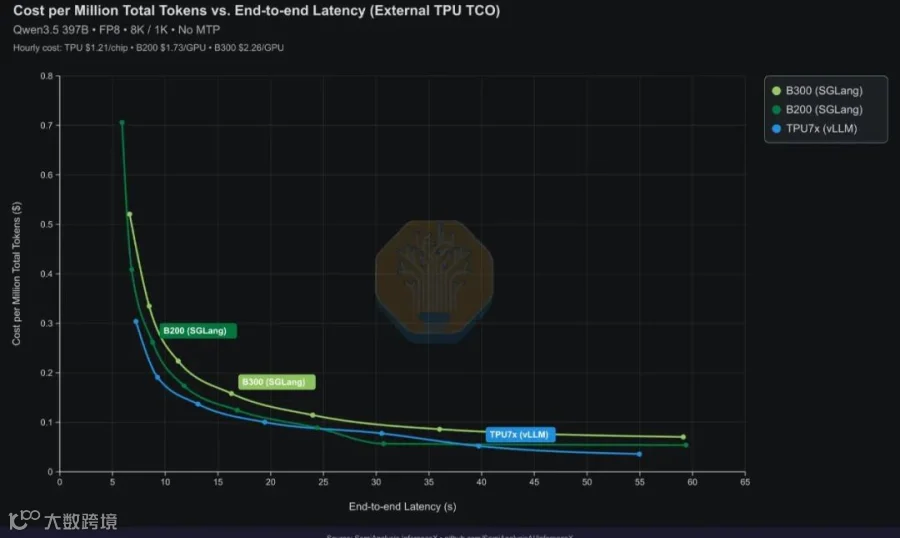
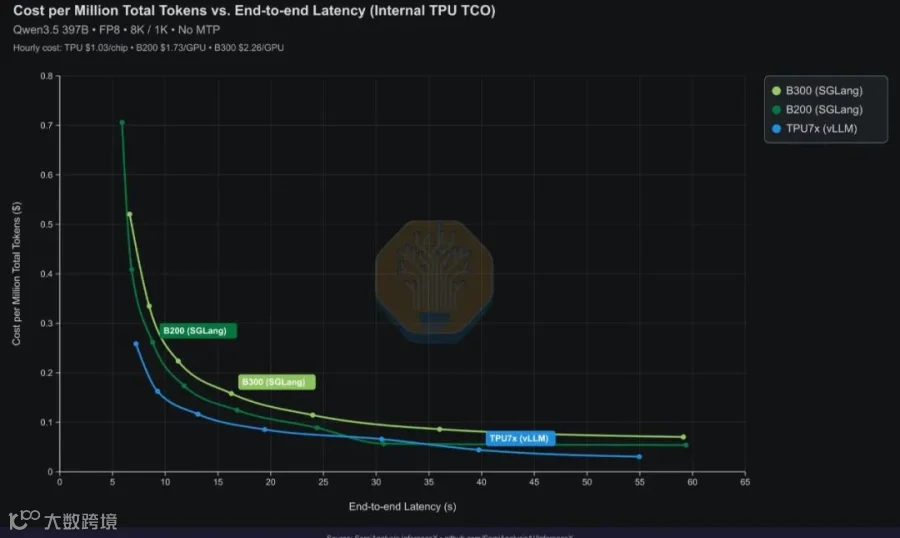
从上面的数据中可以看出,在整条公平对比曲线中,依然存在一小段区间 B200 表现更优,例如中位响应时间 30 秒附近。但当端到端响应时间进一步拉长,TPU 重新夺回更低 token 成本优势;在所展示的重叠区间内,TPU 始终优于 B300。
TPU 系统级协同设计与网络详解
谷歌推理每 token 成本优势来自软硬件协同设计。谷歌不片面追求单芯片峰值性能,而是计算 die、芯片间互联、编译器联合设计,把计算、通信作为整体统一优化。这套联合设计是 Ironwood 实现高性价比的根源。
Ironwood 芯片架构
TPUv7 Ironwood 告别 TPUv4、v5p 的 MegaCore 设计(两颗物理核心融合为一个逻辑加速器,共享内存空间)。Ironwood 拥有两颗独立计算 die,各自为独立逻辑设备;两颗 die 依靠高速片间 Die‑to‑Die 链路连接,而不是统一内存 fabric。JAX 等框架对外暴露每颗芯片上两个独立设备。单颗 Ironwood 芯片包含 2 个 TensorCore 矩阵核,4 颗第三代 SparseCore 稀疏核。SparseCore 专门加速嵌入查表等稀疏算子,这类任务会拖累稠密矩阵引擎。
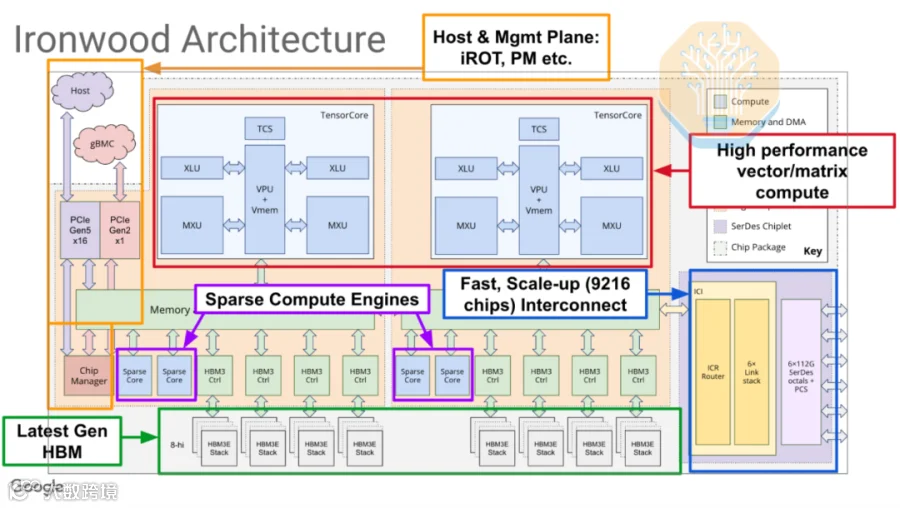
在芯片的内存设计上:单芯片 HBM 容量达到 Trillium(TPUv6)的约 6 倍,直接决定 KV 缓存上限与批处理规模。Ironwood 是 TPU 家族首个原生硬件 FP8,前代 TPU 只能软件模拟 FP8。

TPU的环面 Torus 互联拓扑
大规模训练、推理,成千上万颗芯片之间需要高频通信。TPU 依靠定制 ICI 芯片间互联做 P2P 通信,绕过 CPU 主机;芯片直接交换激活、梯度,不走 PCIe、普通网卡。ICI 拓扑持续迭代:TPUv2/v3 采用 2D 环面,每颗芯片 4 个邻居;TPUv4/v5p 升级 3D 环面,每颗芯片沿 X/Y/Z 正负 6 个邻居。Ironwood TPUv7 延续 3D 环面。最小逻辑单元是 4×4×4 立方体,合计 64 颗 TPU,刚好对应一个物理机柜。

普通网格 vs 环面 Torus:环面首尾回环连接,等价吃豆人迷宫,最坏跳数从 N 下降到 N/2。谷歌进一步使用 “扭曲环面 twisted torus”,类似莫比乌斯带,进一步降低平均跳数。
单 4×4×4 立方体之外,通过光电路交换机 OCS 拼接多个立方体,保留回环拓扑特性;最大可扩展至 Ironwood 完整 9216 芯片 SuperPod,聚合 FP8 算力 42.5 ExaFLOPS。OCS 价值:链路、芯片硬件故障时,数秒内用光链路重配拓扑,不需要技术人员现场更换线缆。

这套横向扩展架构具备革命性。在 NVL72 机架问世之前,如果模型无法塞进单机 8 卡,受限于 IB 机间带宽,只能使用流水线并行。TPU Pod 内部,ICI 环面可以提供类 NVLink 带宽,横跨数千颗芯片。DeepSeek‑V3 这类超大 MoE 模型,可以把张量并行、专家并行、数据并行(FSDP 权重分片)铺满整个 Pod,不需要把层切分到流水线分段。
尽管环面拓扑单条消息跳数高于 NVSwitch 单跳,但很多场景下,小专家并行消息,TPU 环面延迟甚至低于 NVSwitch 单跳。
关于Prefill‑Decode 解耦
Prefill‑Decode 解耦是另一项需要对外落地的关键优化:Prefill和Decode分别跑在独立 TPU 资源池;两套集群可以独立调优、独立扩缩容匹配业务负载。
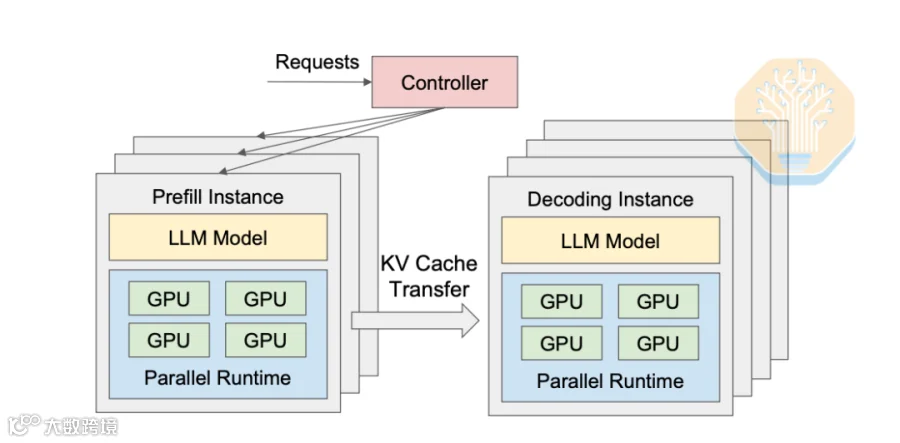
谷歌内部 Gemini 推理早已大规模 PD 解耦;面向外部的开发数月前才启动。包含 llm‑d 中的 TPU 支持、开源 TPU‑Sync(旧名 TPU‑Raiden)解耦 KV 缓存传输库。TPU‑Sync 原生兼容 JAX、TorchTPU 栈;提取 PJRTBuffer 硬件描述符实现零拷贝传输。预计PD 解耦落地后,TPUv7 将有力对抗甚至在部分指标超越 GB200/GB300 的每美元性能。
关于KV 缓存卸载
TPU‑Sync 同样原生支持 TPU KV 缓存 DRAM 卸载。大模型、中大 batch 场景,HBM 放不下全部用户 KV 缓存时,就必须依赖卸载。谷歌把内部 DRAM 卸载能力对外开源。
同时谷歌对接行业标准 Mooncake Store 缓存卸载库,支持 Mooncake DRAM P2P 内存池。Mooncake 的 TPU 传输支持基于 TPU‑Sync 原语实现。
P2P 内存池把多台 TPU 主机的 KV 缓存内存聚合为单一逻辑池;任意服务器 TPU 都可以访问其他服务器上的 KV 缓存。把多节点内存资源合并成统一逻辑资源池。Mooncake Store 还可以聚合多服务器 NVMe 存储,同时兼容 WEKA/Vast 分布式文件系统后端。

写在最后
国内因无法采购英伟达的芯片,被迫启动多元化的AI加速芯片采购渠道,海外云厂商的芯片自研更多的来源于性价比的考量。
TPU对外商业化的成功预示这英伟达在未来的AI芯片战争中将很难再一家独大。TPU不止是自身的成功,更是为更多的云厂商自研芯片树立了一个样板示范。
TPU对于国内公司的启示是,英伟达不见得是那个不得不做的选择。
【延伸阅读】
韬定律首款芯片:聊一聊逻辑折叠为麒麟9050 Pro带来了哪些收益
理性看待国产浸没式光刻技术发展,厘清产业市场预期
长鑫科技:从废墟里的火种到国产之光,中国存储芯片的十年逆袭之路