

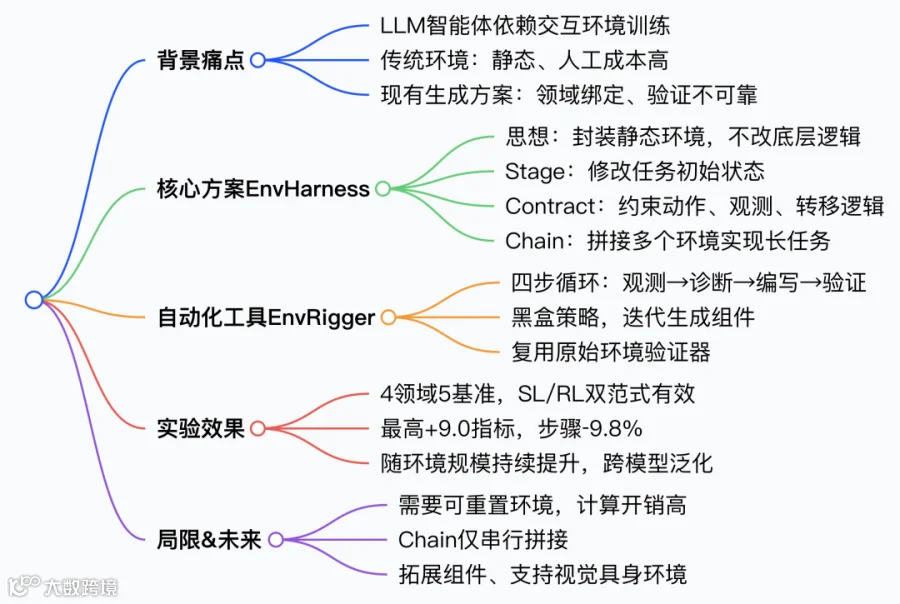
编者摘要:EnvHarness 是谷歌提出的框架,不从零新建环境,通过封装改造已有静态环境,解决 LLM 智能体训练环境固化、无法针对智能体弱点训练的痛点。包含 3 个可插拔组件:Stage 修改初始状态、Contract 改写交互规则、Chain 拼接多环境构造长时序任务。配套 EnvRigger 自动化流水线,把策略当黑盒,通过观测轨迹→诊断缺陷→生成组件→迭代验证,自动生成适配当前智能体短板的定制环境,保留原始环境可信验证器,无幻觉风险。
在 4 大领域 5 个基准测试,技能学习最高提升 9.0 个点,减少 9.8% 执行步骤;强化学习同样带来性能增益;环境数量扩大时性能持续上涨,优于领域专用生成方案。可适配多款开源 / 闭源大模型。局限:需要环境支持 reset 重置接口,计算开销较大,Chain 仅支持串行任务拼接。该工作将环境构建从 “从零编写” 转为 “包装改造”,为智能体交互训练提供新范式。
7 个关键问题问与答
Q1:EnvHarness 要解决什么核心问题?
A:传统智能体训练环境静态固化,不能针对智能体弱点训练;现有环境生成方案领域专用、验证不可靠、易幻觉。EnvHarness 改造已有环境,实现定向训练,保留原始可信验证。
Q2:EnvHarness 三个组件分别是什么作用?
A:①Stage:修改环境初始状态,改变任务起点;②Contract:改写动作、观测、状态转移交互规则;③Chain:拼接多个基础环境,构造长时序复合任务。组件可以自由堆叠组合。
Q3:EnvRigger 的完整工作流程?
A:观测(收集策略执行轨迹)→诊断(定位智能体行为缺陷)→编写(生成 EnvHarness 组件)→验证(新轨迹评估,迭代优化或采纳),整套自动化,不需要访问模型权重,把策略视作黑盒。
Q4:EnvHarness 对比环境生成类工作最大优势?
A:不生成全新环境,复用原有环境和人工验证器,没有大模型带来的验证幻觉;一套框架跨多领域,不用针对每个场景重写流水线。
Q5:EnvHarness 在哪些学习范式生效?
A:技能学习 SL、强化学习 RL 均有效。SL 提升准确率并减少交互步骤;RL 提供高质量优化信号,实现智能体‑环境协同进化。
Q6:EnvHarness 有哪些主要局限性?
A:①要求环境支持 reset 重置接口,真实不可回退业务场景无法使用;②EnvRigger 迭代采样推理计算开销大;③Chain 组件仅支持串行拼接,不支持复杂分支、共享中间状态。
Q7:这篇论文核心贡献是什么?
A:1)提出 EnvHarness,用可插拔组件封装静态环境;2)EnvRigger 实现自动化面向策略短板的环境定制;3)多基准验证效果,提出新思路:环境构建是包装改造,而非从零编写。
附录 EnvHarness:为智能体学习唤醒静态世界
作者:黄承松 ¹*,王子峰 ²,韩汝俊 ²,严骏 ²,陈雁飞 ²,崔卓伊 ²,姜科 ²,夏鹏⁴,余汉 ²,庄宇凡 ²,明逸飞 ²,潘佳琪 ³,巴瓦娜・达尔维・米什拉 ²,黄佳鑫 ¹,布拉克・格克图尔克 ²,托马斯・普菲斯特 ²,李镇宇 ² ¹ 华盛顿大学圣路易斯分校,² 谷歌云 AI 研究院,³ 谷歌云,⁴北卡罗来纳大学教堂山分校 *(本研究为黄承松在谷歌云 AI 研究院实习期间完成) arXiv 预印本:2608.19880v1 [cs.AI],2026‑08‑20
大语言模型智能体通过与环境交互完成学习,但现有的环境大多为人工构建且是静态的:它们无法感知智能体的短板,当智能体能力提升后,环境很快就失去训练价值。尽管近期一些环境生成方法试图解决该问题,但这类方案依赖领域专用流水线,需要高昂且不可靠的验证器,产出的依旧是静态环境。为减轻从零搭建环境带来的工程负担,本文提出环境适配层(EnvHarness):一套由可插拔组件构成的可编程层,对已有静态环境做封装,无需修改底层逻辑就可以改变环境行为。EnvHarness 基于标准接口运行,可适配多个不同领域,同时保证改造后的环境完全继承原环境的验证器。
为实现整个流程自动化,本文进一步提出EnvRigger。它将目标策略视作黑盒,观测智能体执行轨迹,自动生成 EnvHarness 组件,针对性修复诊断出的缺陷,并通过全新的执行采样对组件有效性做验证。
本文在 4 大领域共 5 个基准测试集上开展实验:相较于原始环境以及领域专用的环境生成流水线,EnvHarness 均取得更优效果;在未见过的测试样本上最高可提升 9.0 个点,同时执行步骤减少 9.8%。除此之外,EnvHarness 还可以为强化学习提供更优质的优化信号,实现策略与环境持续、定向的协同进化。
项目地址:github.com/google‑research/envharness;官网:www.envharness.com

图 1|整体实验结果左图:在软件工程与办公自动化基准(SWE‑bench Verified、OfficeQA、SpreadsheetBench)中,基于 EnvHarness 改造环境训练得到的智能体,性能持续优于在原始环境训练的智能体。 右图:SWE‑bench Verified 上的缩放实验。在同等环境数量预算下,EnvHarness 环境性能持续随环境数量提升;而真实环境、生成环境性能趋于平缓。
1 引言
当大模型被部署为自主智能体时,其学习来源从整理好的文本数据转变为交互式环境。无论是网页导航、代码库问题修复,还是具身平台控制,智能体都依靠对应的环境获取学习信号。环境作为交互的另一方,负责呈现任务、管理状态变化、响应智能体动作、评估任务是否完成。
但构建环境需要大量人力硬编码交互逻辑与验证器,这使得最终得到的环境是刚性静态的:无论和哪个智能体交互,无论智能体能力提升到何种程度,环境行为始终不变。这种静态特性从两方面限制智能体学习:
-
无法提供定向训练信号,不能针对某个智能体独有的弱点开展训练; -
一旦智能体学会解决现有全部任务,环境就不再具备教学价值。
由于人工构建环境成本高昂,越来越多的研究转向自动化环境生成。
尽管该类方案具备可扩展性,但存在两大核心缺陷:
- 强领域绑定
生成流水线专用于网页导航、编程、工具调用等某一场景,无法跨领域迁移; - 正确性难以保障,成本高且不可靠
环境与验证器均由大模型生成,需要大量生成样本再做过滤,即便如此也无法完全保证正确性。
本文并不从零创建新环境来获取训练信号,而是提出EnvHarness(环境适配层):可编程封装层,在不改动原有环境的前提下,把已有静态环境改造为可动态定制的环境。
图 2 类比了智能体适配层(Agent Harness)与 EnvHarness:智能体适配层为冻结权重的大模型增加外部记忆、工具调用、技能模块,使其完成复杂任务;EnvHarness 把这套思想迁移到环境侧,为静态环境装配模块化可插拔组件:
- 阶段组件(Stage)
设置交互片段的起始状态; - 契约组件(Contract)
约束允许执行的动作与观测返回内容; - 链式组件(Chain)
把多个基础环境拼接,构造更长交互片段。
智能体依旧沿用标准接口和环境交互,EnvHarness 负责接管中间交互流程。如此一来,同一个原始环境可以实现原本不具备的能力:隔离单项技能、拉长任务回合长度、调节难度,让智能体处于 “有挑战但最终可以完成” 的训练区间。最重要的是,所有修改都发生在接口层,因此 EnvHarness 具备领域无关的特性,改造后的环境可以安全复用原始环境经过人工校验的验证器。
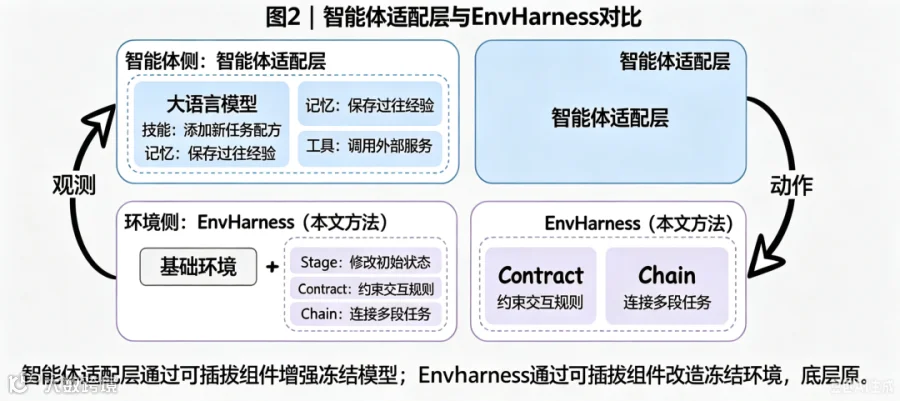
图 2|对比智能体适配层与 EnvHarness智能体适配层在不修改模型权重的前提下,通过可插拔组件(技能、记忆、工具)把冻结的大模型变成可用智能体。EnvHarness 把同样的思想应用到交互链路的另一端:通过可插拔组件定制冻结的原始环境,底层环境本身保持不变。
虽然 EnvHarness 提供通用框架,但具体配置需要适配目标策略与对应任务。为此本文提出EnvRigger实现定制流程自动化。EnvRigger 将策略视为黑盒,采集智能体在基础环境下成功与失败的执行轨迹,诊断行为层面的缺陷;基于诊断结果生成候选 EnvHarness 组件封装原始环境,随后运行全新采样做评估;未通过评估的组件迭代修改,直到满足条件。整套流程实现了完全自动化、受任务‑策略约束的环境定制。
本文在 4 个领域的 5 套基准开展实验:具身任务 ALFWorld、网页浏览 WebArena、软件工程 SWE‑bench Verified,办公任务 OfficeQA 与 SpreadsheetBench。实验覆盖两类主流学习范式:技能学习(SL)、强化学习(RL)。
-
技能学习场景:基于 EnvHarness 改造环境训练的智能体优于原始环境训练版本,在未见过任务上最高提升 9.0 个点,交互步骤减少 9.8%。 -
强化学习场景:EnvHarness 定制环境训练得到的策略性能同样显著提升,最高提升 6.5 个点。
反复运行 EnvRigger 循环,可以实现智能体与环境协同进化,获得累积式性能提升,性能随定制任务数量有效缩放。
表 1|智能体适配层与 EnvHarness 对比二者都依靠外部封装层拓展能力,而非修改核心系统。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
本文的三项主要贡献:
-
提出 EnvHarness:一套可编程封装层,基于环境原生 reset/step接口把静态环境改造为可控环境;实现三类可插拔组件,分别改造环境初始状态、智能体‑环境交互接口、拼接多个环境生成复合任务;原始环境任务与验证器完全保留,不做改动。 -
提出 EnvRigger,实现受任务‑策略约束的自动化环境定制。从执行轨迹诊断策略缺陷,迭代改写候选组件,直到新采样验证组件有效;生成的每个环境都定向针对该策略的具体短板。 -
在 4 个领域共 5 套基准验证 EnvHarness:提升效果(未见过任务最高 + 9.0 点)、训练效率(步骤减少 9.8%);强化学习下策略效果更强;当人工构建与生成环境性能饱和后,EnvHarness 依旧可以持续提升智能体性能。
2 EnvHarness
2.1 EnvHarness 范式
智能体适配层是封装大模型的软件层(执行循环、工具注册、上下文管理):智能体 = 模型 + 适配层,不改动模型权重就增加新能力。
我们将这套范式迁移到智能体‑环境循环的另一侧。EnvHarness 定义为封装已有静态环境的可编程层,将静态环境转变为可定制环境: 定制环境 = 静态环境 + EnvHarness
EnvHarness 完全通过标准接口修改信息流,底层环境本身完全不变。类比智能体适配层的工具与记忆模块,EnvHarness 由模块化可插拔组件组装而成,针对训练需求定制环境:隔离单项技能、拉长任务跨度、调节任务难度。
EnvHarness 形式化定义把环境建模为元组\(E=(S,A,O,T,R,s_0)\):S状态空间;A动作空间;O观测空间;\(T:S\times A \to S\)状态转移函数;R验证器给出的奖励;\(s_0\)初始状态。 EnvHarness 组件是环境无关的变换u:
\(E'=w(E),\ E'=(S',A',O',T',R',s_0') \tag{1}\)
变换u仅在接口层重塑环境,不会修改底层模拟器后端与实现细节。可以定制初始状态\(s_0'\)、过滤暴露给外部的空间\(A',O'\)、更新转移机制\(T'\)。所有干预均在外部完成,因此真值评估逻辑完整保留,原始验证器依旧可以对交互片段打分。
2.2 三类 EnvHarness 组件
公式 (1) 定义通用接口,任何遵循该接口的变换都是合法 EnvHarness 组件。本文实现三类组件,覆盖环境定制的三种基础模式,未来还可以拓展更多组件。每一类组件拥有自身参数,重写环境标准接口方法如reset、step。
下文以 ALFWorld 任务示例:“把干净马克杯放到桌面”。原始任务中马克杯直接暴露在外,放到桌面任务直接结束。
阶段组件 Stage:修改初始状态阶段组件\(w_{\text{stage},\delta}\)由一系列状态修改动作\(\delta=(a_1,…,a_k)\)定义。这些动作会在reset()返回初始状态\(s_0\)之后执行:
\(E'=w_{\text{stage},\delta}(E)=(S,A,O,T,R,s_0')\) 其中\(s_0'=T(\dots T(T(s_0,a_1),a_2)\dots,a_k)\)
该变换仅改变初始状态。Stage 可以修改智能体的任务起点:增加障碍,迫使智能体掌握特定技能;也可以预先完成部分子目标,缩短任务回合。
示例:执行动作序列「拿起马克杯、打开抽屉、把马克杯放进抽屉、关上抽屉」,马克杯被藏入抽屉,智能体必须先搜索物体,而不是直接拿取。也可以预先执行清洗马克杯,只留给智能体最后的放置步骤,简化任务。
契约组件 Contract:重写交互逻辑契约组件\(w_{\text{contract},r}\)由三组变换映射\(r=(f_A,f_T,f_O)\)定义,默认均为恒等映射,分别改造动作空间、转移动力学、观测空间:
\(E'=w_{\text{contract},r}(E)=(S,A',O',T',R,s_0)\) 其中\((A',O',T')=\big(f_A(A),f_O(O),f_T(T)\big) \tag{3}\)
实际使用中,可以强制动作前置条件、增加或屏蔽观测信息、为特定结果附加结构化反馈,引导智能体学习。
示例任务中的用法:
-
\(f_O\)截断房间描述,只保留前两句,迫使智能体通过多步交互构建空间认知; -
\(f_T\)增加约束:智能体没有手持马克杯时,禁止执行清洗马克杯动作,强制智能体必须先拾取物体; -
\(f_A\)移除瞬移导航的高级指令,强制智能体一步步移动、搜索。
链式组件 Chain:拓展环境链式组件\(w_{\text{chain},\ell}\)由\(\ell=(E_{\text{ext}},g)\)定义:\(E_{\text{ext}}\)是额外的环境,g是组合逻辑。组合逻辑把原始环境E与附加环境\(E_{\text{ext}}\)合并,输出遵循同一套接口的复合环境\(E'\):
\(E'=w_{\text{chain},\ell}(E)=\big(S',A',O',T',R',s_0'\big),\ E'=g(E,E_{\text{ext}}) \tag{4}\)
跨环境组合时,新空间取基础环境的并集(如\(A'=A\cup A_{\text{ext}}\));\(R'\)为复合后的奖励。组合逻辑g自由度很高,可以顺序拼接、交替执行、基于中间结果分支。可以从一开始就合并两个环境,也可以通过转移函数\(T'\),当满足特定条件时,动态切换到另一个环境。
示例:在马克杯任务之后追加子任务 “加热土豆放到台面”;只有两个子任务全部完成,复合环境\(R'\)才判定成功。迫使智能体即便完成第一个子目标,也不能停止思考,记住整体任务目标。
组件组合所有 EnvHarness 组件共享标准接口,可以自由嵌套叠加。例如对马克杯任务同时叠加 Stage、Contract、Chain:
\(E'=w_{\text{chain},\ell}\big(w_{\text{contract},r}\big(w_{\text{stage},\delta}(E)\big)\big) \tag{5}\)
例子中:Stage 初始化状态,马克杯藏进抽屉,要求空间搜索;Contract 截断观测,模拟部分可观测场景;Chain 追加后续任务,测试智能体对长期目标的坚持。
⚠注意:组件变换不满足交换律\(w_1 \circ w_2 \neq w_2 \circ w_1\),嵌套顺序决定环境如何构建,区分初始化阶段与运行交互阶段施加的约束。
3 面向智能体学习的 EnvHarness
3.1 问题设定
给定基础环境E与一批基础任务,目标策略智能体\(\pi\)。目标:自动生成针对任务t的改造环境\(E'\),暴露策略\(\pi\)的独有缺陷,实现定向提升。
单个 EnvHarness 组件本身与策略无关,公式 (1) 中变换u仅改造环境,同一组件可以直接用于任意策略。但是组件的选择、参数化,需要同时结合基础任务t和策略\(\pi\)的实际行为。因此本文定义受任务‑策略约束的映射\(\mathcal H\):
\(E'=\mathcal H(E,t;\pi)=\big(w_k \circ w_{k-1}\circ \dots \circ w_1\big)(E) \tag{6}\)
每一个\(w_i\)是定制好的 EnvHarness 组件,封装基础环境E,暴露策略\(\pi\)在任务t上的核心弱点。整套机制不需要查看模型内部权重,仅基于智能体输出,生成持续有效的矫正训练信号。
3.2 EnvRigger
EnvRigger 实现公式 (6) 的映射\(\mathcal H\)。它让策略\(\pi\)在任务t的环境中运行,分析轨迹,编写 EnvHarness 组件定制环境,再通过全新的策略采样验证改造后的环境。可以提供有效学习信号的候选环境组件会被采纳;不满足条件的候选组件会被拒绝或者迭代修改。完整工作流分为 4 步:观测(Observe)→诊断(Diagnose)→编写(Write)→验证(Validate)。验证阶段需要基础环境支持确定性重置,保证 Stage 引入的初始状态修改可以复现。
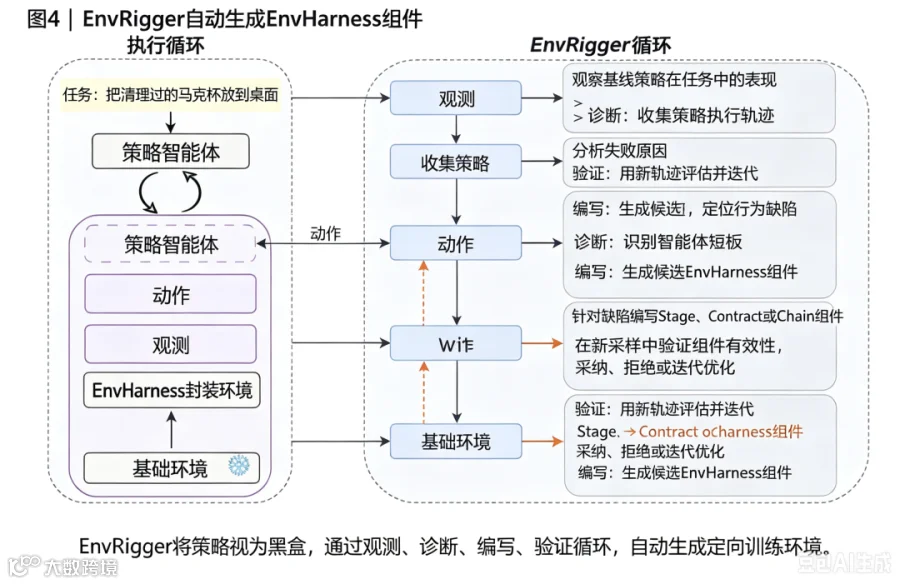
图 4|EnvRigger 工作流左侧执行循环:策略智能体与被 EnvHarness 封装的冻结底层环境交互,产生轨迹;轨迹送入右侧 EnvRigger 循环。EnvRigger 四步流程:观测基线采样、诊断智能体短板、编写候选 EnvHarness 组件、用全新采样验证;编写‑验证形成循环,生成候选组件,评估,失败则迭代修改。
- 观测 Observe
让策略\(\pi\)在原始任务t运行,收集一批执行轨迹。失败样例暴露任务内需要解决的弱点;成功样例帮助划定缺陷边界,明确哪些能力已经掌握、哪些场景下策略开始出错。 - 诊断 Diagnose
分析轨迹,定位行为问题根源,例如动作死循环、长观测解析失败、工具约束理解错误。同时确定环境定制方向: -
如果策略表现很差:需要脚手架,简化任务,补齐缺失步骤; -
如果策略成功率已经 100%:原始环境过于简单,需要提升难度,把潜在缺陷暴露出来。 输出文本形式诊断报告。 - 编写 Write
基于诊断结果生成一个或多个 EnvHarness 组件,针对性修复识别到的缺陷。一个缺陷可能需要组合多个组件,例如 Stage 修改初始状态 + Contract 过滤交互。举例:诊断发现策略依赖捷径绕过必要学习,可以编写 Contract 阻断该捷径动作,迫使智能体探索、掌握真正需要的技能。 - 验证 Validate
把候选组件封装到环境得到\(E'\),运行全新的策略采样。基于成功率、失败分布等轨迹指标,做三种决策:采纳、拒绝、迭代优化。迭代优化时轨迹与反馈送回 Write 阶段,重复编写‑验证循环,直到组件被采纳或者迭代预算耗尽。被采纳的组件加入 EnvHarness。
系统提示词、验证决策标准详见附录 A。
4 实验
4.1 实验设置
本章节重点研究技能学习范式:从环境中提取技能提升智能体能力;强化学习范式的实验与分析见第 5 章。
基准测试集与评估指标覆盖 4 个领域 5 套基准:
-
具身交互 ALFWorld; -
网页交互 WebArena; -
软件工程 SWE‑bench Verified; -
办公自动化 OfficeQA、SpreadsheetBench。
使用基准自带评估指标;针对 SWE‑bench Verified 额外统计平均执行步骤衡量效率。所有基准的训练、评估交互片段严格划分。附录 E.1 给出数据集划分细节。
模型配置:ALFWorld、WebArena 使用 Gemini‑3.1‑Flash‑Lite;其余任务使用 Gemini‑3.5‑Flash。EnvRigger 与策略智能体使用同一个模型主干,保证性能提升不是来自更强的外部模型。 训练集上 EnvRigger 运行第 3 章优化循环生成 EnvHarness 改造环境;参照 ReasoningBank 方法从改造环境轨迹中提取技能;装配技能的策略智能体在未见过的测试样本上评估。 自动化流水线暂不包含 Chain 组件(EnvRigger 难以观测拼接环境的内部状态);Chain 的效果单独放在第 5 章分析。
对比基线对比 4 类技能来源:
-
No‑Skills:原始冻结策略,不装配任何技能; -
Original Envs:从原始环境提取技能; -
领域专用生成基线:GenEnv、VeriEnv、SWE‑Smith(仅在对应领域生效)。
基线与 EnvHarness 使用完全相同的种子样本、环境数量、技能提取流水线、策略模型。EnvRigger 仅在训练交互片段运行,拥有同样的真值验证接口;每个评估样本仅尝试一次。基线细节见附录 E.2。
4.2 主要实验结果
表 2|ALFWorld、WebArena 上装配不同来源技能的智能体性能数值为三次独立运行均值;下标灰色数字代表标准差;指标越高越好;最后一行代表 EnvHarness 相对原始环境的提升。“‑” 代表该方法不适用该领域。
|
|
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
表 3|SWE‑bench Verified、OfficeQA、SpreadsheetBench 性能SR = 成功率,步骤越低越好;EM、F1、Pass@1、Mean Score 越高越好。“‑” 代表方法不适用该基准。
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
核心发现
- 静态环境存在性能天花板,EnvHarness 带来稳定提升
从 EnvHarness 改造环境提取的技能,在全部基准上持续优于原始环境提取的技能;ALFWorld 分布外样本最高提升 9.0 点。 静态原始环境提取的技能甚至会损害性能:SpreadsheetBench 上原始环境训练技能效果比完全无技能基线还差;SWE‑bench Verified 上原始环境反而拉长执行轨迹。静态环境只能让智能体重复已经掌握的行为,无法解决策略的真实短板,经常得到冗余、次优的技能。而 EnvRigger 的编写‑验证循环,只保留经过全新轨迹验证有效的组件,EnvHarness 在全部基准上都稳定优于无技能基线。 - 一套领域无关接口,跨多个基准泛化
接口协议、EnvRigger 循环、技能提取流水线可以直接复用在全部 5 套基准,仅需要少量领域提示模板做适配。对比专用生成基线,它们只能在单一基准生效。 在可以对比的基准上 EnvHarness 均优于领域专用基线:ALFWorld 上平均超过 GenEnv5.7 点,分布外样本高出 8.5 点;SWE‑bench Verified 对比专门构建的 SWE‑Smith,成功率高出 2.46,每个交互片段平均少 5.11 步。说明:通过统一接口定向修复诊断得到的缺陷,比单纯扩充领域专用流水线生成样本数量效果更好。 - EnvHarness 提升执行效率,消除无效行为
SWE‑bench Verified 中 EnvHarness 环境训练得到的技能,单片段平均步骤从 53.6 下降至 49.6;原始环境训练技能反而上升至 55.0。该效率提升和 EnvRigger 诊断直接对应:针对性的 Contract 与 Stage 组件消除动作死循环、过滤冗长观测,缩短执行轨迹。
5 补充分析
本章从 5 个维度分析 EnvHarness:作为强化学习训练信号的兼容性;与传统数据集扩充相比的缩放特性;跨不同策略模型家族、不同能力强度的迁移性;Chain 组件在长跨度任务的价值;EnvRigger 支持用户显式指定约束的能力。更多分析见附录 G。
EnvHarness 助力强化学习
除技能学习,本文探究 EnvHarness 改造后的环境是否可以为在线强化学习提供训练信号。实验基于 ALFWorld、WebShop,策略模型 Qwen3‑8B‑base,优化算法 GRPO。训练两组策略:一组仅用原始静态环境训练,一组完全基于 EnvHarness 改造环境训练,在同一批未见过样本上评估。
表 4|ALFWorld、WebShop 强化学习结果对比原始环境训练与 EnvHarness 环境训练策略。ALFWorld 指标为分布内、分布外成功率;WebShop 报告环境得分、任务成功率。
表格
|
|
|
|
|
|
|
|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
EnvHarness 环境训练在 4 个指标中 3 个取得更好结果:ALFWorld 分布内成功率 87.9(原始环境 81.4);WebShop 得分 79.2(原始 75.6)、成功率 67.4(原始 66.0)。ALFWorld 分布外存在微小可忽略的下降(88.8 对比 89.6)。 证明改造后的环境不只是辅助数据,还可以为在线策略学习提供高质量独立优化信号。
Chain 组件高效解决长跨度任务
现实任务往往需要长回合执行。Chain 组件把两组随机配对的基础环境拼接为一个长交互片段(该实验不接入 EnvRigger 自动循环)。提取技能在标准单环境测试集评估,统计成功率 SR、平均步骤 AS。
表 5|长跨度环境实验
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
54.30 | 43.12 |
Chain 组件提取的技能带来巨大效率提升,平均步骤从 53.58 下降至 41.96;单独使用 Chain 的成功率 49.63 略低于原始环境基线 49.88。这是因为 Chain 训练条件严苛,必须同时完成两半任务,优先训练长期目标保持能力,而不是追求短期任务成功率。 两套技能组合(Stage/Contract + Chain)取得最优结果:最高成功率 54.30,同时保持很高执行效率 43.12,两类组件能力互补。代表性技能见附录 F.3。
环境规模扩展实验
环境规模扩展实验固定总预算,对比三种资源分配方案:EnvHarness 环境、未修改原始基准环境、SWE‑Smith 生成环境。策略模型、总环境预算、技能提取检索协议完全一致。每 50 个环境构建一套技能库。 关键区别:基线生成环境与智能体当前能力无关;EnvHarness 每一批环境都专门针对当前已经装配过往技能的策略,实现环境‑策略协同进化。
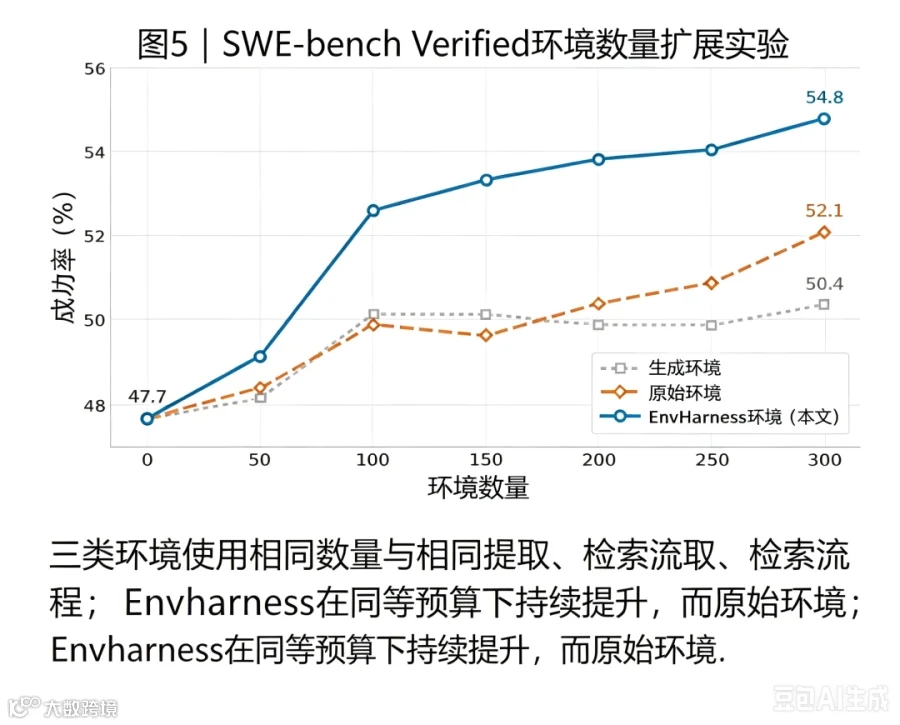
图 5|SWE‑bench Verified 规模扩展三者使用同等数量环境,送入完全一致的提取、检索流程。 EnvHarness:环境数量从 0 到 300,成功率从 47.67 提升至 54.79,300 环境时性能依旧保持上升。同等预算原始环境仅到 52.13,生成环境仅 50.37。 证明:针对智能体当前能力边界生成环境,效果远好于无差别扩充环境数量。每一轮代表性技能见附录 F.2。
跨大模型泛化能力
在 SWE‑bench Verified 上测试 4 个不同模型:Gemini 3.1 Flash‑Lite、Qwen3.6‑27B、Gemini3.5 Flash、Claude Sonnet4.6,覆盖开源、闭源,能力跨度很大。每组实验中,策略与 EnvRigger 使用同一个模型主干,提取流水线与协议不变。
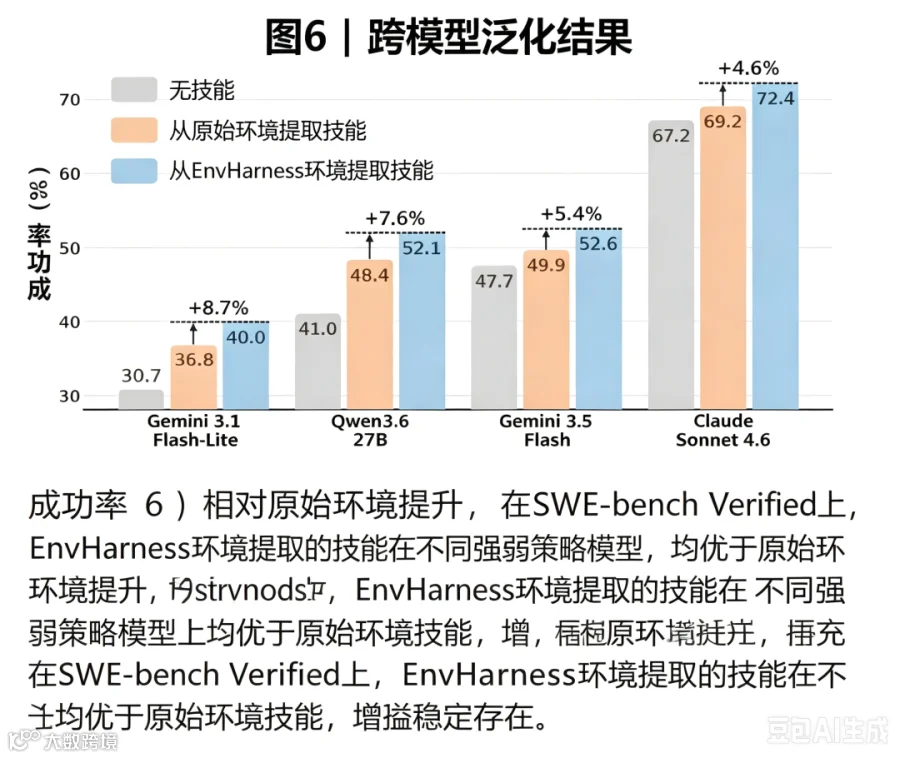
图 6|SWE‑bench Verified 跨模型结果每一组代表一个策略模型,从弱到强排序。三组柱状分别对应:无技能、原始环境提取技能、EnvHarness 环境提取技能;百分比是 EnvHarness 相对原始环境的相对提升。 结果:在全部 4 套策略上,EnvHarness 技能均优于原始环境技能,相对提升 2.7‑3.7 个绝对点;无技能基线成功率跨度从 30.7 到 67.2。 性能增益大小几乎与底层策略强弱无关:这套定制循环在最弱模型上不会失效,最强模型上也不会饱和;全程使用同一套流水线、提示词、接受判定标准。策略能力强弱只会改变诊断得到的缺陷内容,不会影响整套流程可用性。 两套最弱模型从技能获得的收益最大。
EnvHarness 支持用户显式约束
标准场景下 EnvRigger 通过行为诊断自动寻找训练目标;同时整套机制可以接收用户给出的显式约束。分为两类约束:定量指标目标(成功率、平均步骤,附录 G);自然语言描述能力短板。
示例:用户指定缺陷:策略在未运行失败测试的情况下直接提交补丁,修复没有经过验证。 EnvRigger 生成 Contract 组件:如果没有执行测试,拦截代码提交动作,强制智能体验证修复。从轨迹中提炼通用技能「验证驱动开发流程」。该技能不拟合单一任务,而是通用原则 + 可执行步骤。
6 相关工作
6.1 环境规模扩充
环境扩充是为智能体学习提供更多训练环境的研究方向。现有方案形式多样:用大模型模拟环境与反馈;世界模型仿真生成大量环境;程序生成可执行环境;在现有基准内部合成新任务实例。
另一类研究方向让环境适配学习者,包含强化学习课程学习、人工设计矫正反馈与奖励塑形。 与过往依赖基准专用流水线、人工课程设计的工作不同:EnvHarness 通过一套统一接口改造已有环境;改造过程基于诊断得到的当前策略短板;完整保留原始任务与验证器,不需要改动底层。
6.2 自进化智能体
自进化智能体不需要额外人工监督,从自身经验完成自我提升。现有工作进化智能体的不同部分:提示词与反思;技能库、工作流库;从轨迹蒸馏记忆;通过自生成奖励、自提出任务更新模型权重;还有最近的智能体适配层优化工作。
这些方案大多是智能体自身迭代,但学习所处的环境保持不变。EnvHarness 与之不同:智能体本身可以冻结,迭代改造的是外部环境,定向针对策略诊断出来的缺陷。
7 总结与结论
本文提出 EnvHarness,一套可编程层,将已有的静态环境改造为可控环境。通过 Stage、Contract、Chain 三类可插拔组件封装冻结的基准环境;全部改造基于标准reset/step接口完成。可以在原本不支持的环境上实现:隔离单项技能、拉长任务跨度、调节难度。EnvHarness 完全不触碰底层代码,同一套实现跨领域无缝工作。同时保留原始环境可信、人工构建的验证器。
为实现完全自动化定制,提出 EnvRigger 自主循环:从执行轨迹诊断策略缺陷,生成定向 EnvHarness 组件,输出精准训练信号。 本文把环境构建重新定义为封装包装问题,而不是从零编写问题,为智能体学习的大规模环境供给提供可行路径。
局限性与未来方向见附录 H、I。
附录
附录 A EnvRigger 提示词
代码库内部命名和论文命名映射: 论文 | 代码实现 | 输出字段 ---|---|--- Stage | Setups | in_env_actions Contract | Rules | rules_code Chain | Link | —
EnvRigger 设计智能体系统提示:你的角色是基准环境设计师,改造环境,给策略智能体提供正确训练信号。输出候选包含两部分:
rules_codePython 类_Rules,重写最多三个逐步骤钩子:过滤动作、修改转移逻辑、过滤观测;每个钩子默认是恒等透传;每个交互片段重新加载类。 in_env_actions一组工具调用,策略运行前由框架执行复现,实现初始状态修改。
⚠️重要约束:禁止把任务变得完全不可解;成功率直接归零没有训练价值;优先做细微、局部扰动,不要大规模封禁能力。先看基线采样,判断策略原本能不能解决任务,再决定调难还是做脚手架。迭代阶段不能只看单条轨迹,基于 K 次采样统计指标(成功率、失败分布、超时数量)做接受 / 优化 / 拒绝决策。
附录 B 和协同进化、合成框架的核心差异
- 对比 GenEnv(生成式协同进化)
GenEnv 用大模型作为仿真器,实时生成转移、观测、成功信号。风险:大模型幻觉带来评估漂移,破坏基准数学有效性。 EnvHarness:底层环境、转移函数、人工验证器完全冻结;所有定制在接口层完成,100% 确定转移逻辑,评估可信度高。 - 对比 EnvGen(自适应配置引擎)
EnvGen 修改模拟器内部配置、地图文件,高度绑定具体基准;每一个新领域需要大量人工工程,有状态逻辑损坏风险。 EnvHarness:领域无关。接入新环境只需要一次性编写轻量 Bridge 适配器,协同进化循环、环境设计师不需要修改,一套流水线运行在 ALFWorld/WebArena/SWE‑bench。 - 对比 Agent‑World(程序化环境合成)
从零编写全套可执行工具、数据库、任务实例,工程开销巨大;生成工具存在逻辑错误,干扰训练。 EnvHarness:不从头构建环境,复用已经成熟可信的现有基准;基于任务t诊断策略缺陷,自动生成面向挑战的封装层;大幅降低计算、工程开销,完整保留基准评判标准。
附录 C 接口协议与设计模式
EnvHarness 核心设计原则:无论原始基准,还是经过多层 EnvHarness 封装,对外提供完全一致接口。策略、调度器、组件层只依赖抽象类型,无法区分原始基准和被封装后的基准。
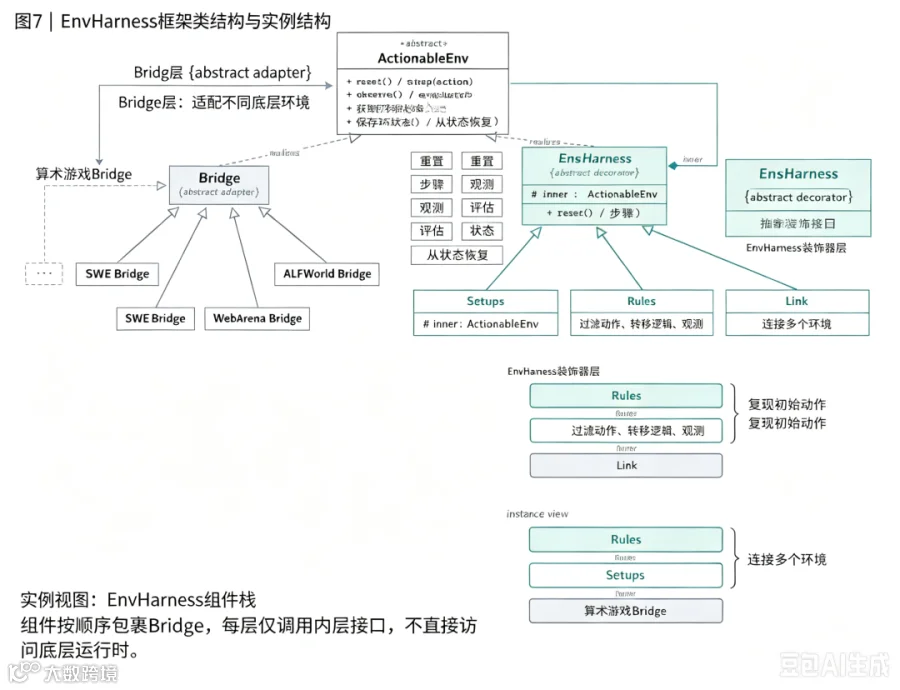
图 7|框架类结构与实例结构
-
左上方 Bridge:把异构运行时适配抽象 ActionableEnv接口;每个基准实现一套 Bridge。 -
右上方 EnvHarness 是抽象装饰器基类;三个组件 Setups/Rules/Link 继承自它。 -
实例视图:EnvHarness 是组件有序栈,一层层包裹 Bridge;每一层只调用内层接口,永远不直接访问底层运行时。
C.1 ActionableEnv 通用交互接口
抽象基类,定义所有环境必须实现契约。
-
Gym 风格交互循环: reset()初始化片段;step(action)执行动作返回五元组;observe()读取观测;evaluate()给出最终评估结果;get_env_state()输出安全只读状态视图,不含 Docker、浏览器句柄;组件钩子只允许读取这份数据视图,保证组件跨环境可移植。 -
状态持久化: save_state()输出可序列化字典,from_state()重建实例。
附加可选能力:逐步骤奖励钩子、回调通知、任务枚举、资源释放close()。
C.2 Bridge 适配器层
Bridge 是基准对 ActionableEnv 的实现,唯一感知底层运行时的层。本文实现 7 个 Bridge:Toy24 算术游戏;ALFWorld 文本冒险;SWE‑bench/OfficeQA/SpreadsheetBench 基于 Docker 容器;WebArena/WebShop 基于 Playwright 浏览器。Bridge 对外暴露工具注册表,生成大模型工具调用 schema。Bridge 可以选择两种持久化策略:完整快照;仅保存重置参数(适合容器、浏览器等重量级运行时)。同时输出env_state_schema(),把可读字段注入设计师提示词。
C.3 EnvHarness:装饰器模式实现可组合组件
EnvHarness 是抽象装饰器,本身是 ActionableEnv 实例,内部持有另一个 ActionableEnv 对象。默认全部方法直接委托内层对象执行;具体组件只重写自己需要修改的接口。组件可以无限嵌套。
- Setups(论文 Stage)
在 reset 之后复现一组动作序列,得到修改后的初始状态;全部复用环境原生 step 接口,不需要访问内部状态;复现结束调用回调重置计数器,保证准备阶段步骤不计入预算。依赖种子重置实现确定性。 - Rules(论文 Contract)
三个钩子: filter_action拦截改写 / 阻断动作;modify_transition修改环境返回响应;filter_observation修改返回观测。代码以字符串形式存储,加载时编译,运行在每个片段独立子进程,防止错误代码崩溃整个框架。不修改初始状态、不修改奖励。 - Link(论文 Chain)
组合两个 ActionableEnv 为一个交互片段。可以串行拼接、基于结果分支、中途切换环境。屏蔽子环境终止信号;复合任务成功要求两个子任务验证全部通过;每个子任务复用自身可信验证器。可以跨基准拼接环境。
附录 D Chain (Link) 算子代码示例
支持多种组合模式:
-
串行拼接:第一个子环境终止,自动切换到第二个。 -
基于任务结果分支:第一个任务完成,根据成功 / 失败,切换到更难任务 / 补救任务。 -
满足条件中途切换:检测特定动作发生,立刻切换目标环境。 -
交替执行:每一步在两个环境来回切换。
附录 E 实验细节
E.1 数据集划分
训练集:EnvRigger 改造任务;评估集只用原始未改造任务。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
E.2 基线细节
GenEnv:大模型仿真模拟器,生成难度对齐智能体当前能力的任务; VeriEnv:克隆网页生成可执行合成环境; SWE‑Smith:合成仓库级软件工程任务实例。 所有基线使用相同种子任务、模型、生成同等数量环境。
E.3 EnvRigger 超参数(全部基准共用)
-
Observe 阶段:每个任务基线采样 K=5 轮; -
Validate 阶段:每个候选采样 K=5 轮; -
改写‑验证循环最大迭代预算:5 次; -
设计师模型与策略模型完全相同。
采纳 / 拒绝基于 K 次采样统计,不看单条轨迹。
附录 F 补充分析细节
F.1 RL 强化学习实验细节
硬件:单机 8×NVIDIA H100;vLLM 推理,FSDP 全分片数据并行,开启模型、优化器卸载,梯度检查点。 超参:全局批次大小 16;PPO 小批次 256;单 GPU 微批次 4;最大 prompt 长度 4096,输出 512;最大片段长度 50 步;无效动作惩罚系数 0.1;采样温度 0.4;训练 150 轮;随机种子固定 0。
F.2 协同进化多轮提取的技能示例
第 1 轮:针对基础策略不会运行测试、不会正确编辑文件,生成组件强制使用pytest -x快速失败;强制使用patch做文件修改;强制指定测试文件,禁止全目录运行。 第 2 轮:策略已经掌握基础测试流程;组件模拟 pytest 命令行入口损坏、OOM 内存杀死,迫使智能体学会python -c "import pytest; pytest.main()"等编程式调用测试; 第 3 轮:修复解释器 PATH 解析问题,禁用不安全sed -i原地编辑,迫使智能体使用 grep 检索代码。
F.3 Chain 组件提取的技能
-
共享步骤预算管理:处理拼接任务时,不要过度消耗在第一个子任务,保留足够步骤资源处理第二个任务。 -
任务切换后环境重探测:切换仓库 / 任务后,立刻探测 conda 环境、解释器路径,不要沿用前一个任务的环境假设。
F.4 跨模型完整指标表
不同模型的成功率、平均步骤,揭示三种行为模式:
-
弱模型 Qwen3.6‑27B:无技能时步骤很长,大量无效试错;装配技能后步骤大幅缩短。 -
弱模型 Gemini3.1‑Flash‑Lite:无技能提前放弃,步骤短;技能让智能体坚持更长交互,解决更多任务。 -
强模型 Claude Sonnet4.6:本身动作方向明确,步骤几乎不变。
平均步骤本身不能单独衡量好坏:短可以代表高效,也可以代表提前放弃,必须搭配成功率一起解读。
附录 G 更多补充实验
- ALFWorld 留一法泛化实验
从全部任务类型中去掉一类训练,在该类上测试。EnvHarness 提取技能平均比原始环境高 3.1 点;证明改造环境迫使策略跳出记忆的固定流程,技能具备跨任务类型通用性。 - Token 开销统计
EnvHarness 设计师会消耗额外提示 Token,但是 Rollout 采样 Token 占绝大多数;和 VeriEnv 对比总 Token 消耗接近。GenEnv 总 Token 更低,但是它是大模型仿真环境,不是真实执行,会带来幻觉。 - 定量指标目标校准
ALFWorld 把任务成功率目标约束到 [0.4,0.6] 区间。原始环境仅 6% 任务落在区间,EnvHarness 改造后达到 80%;目标平均步骤区间 [25‑35],覆盖率从 18% 提升至 53%。EnvHarness 可以直接定向调节定量指标。 - 用户指定缺陷实验
9 组人为给定缺陷测试:ALFWorld、WebArena、SWE‑bench;设计师自动选择 Stage/Contract 不同轴生成组件,从轨迹蒸馏出对应的通用技能。
附录 H 局限性
- 设计循环计算成本高
每一轮候选都需要多次策略采样;弱的设计师模型需要更多迭代。该成本一次性消耗在环境生成阶段,不是每个训练片段都要支付;未来随着设计师能力增强开销有望下降。 - 要求环境支持可重置的 step/reset 接口
Stage 需要设置确定初始状态,Chain 需要回到已知状态。不支持不可回退的后端(真实账号邮件发送、物理机器人)。 - Chain 组件仅实现顺序拼接
Chain 只能做串行验证复合任务;不支持语义关联的子任务、共享中间状态、复杂分支。复杂语义组合还需要额外研究。
附录 I 未来方向
- 拓展更多组件类型
Stage/Contract/Chain 只是第一批组件;未来可以增加注入随机性、部分可观测、多智能体共享环境等组件,复用同一套接口。 - 超越纯文本观测
扩展到视觉 GUI、具身环境,观测不再是符号文本,需要重新定义状态指定、验证机制。 - 增强 Chain 的控制流
现在 Chain 串行拼接可以继承验证器;分支、交错执行很难继承原有真值验证;未来需要研究子任务兼容性度量,以及复合目标验证器。
参考文献部分从略