

就在不到十年前,工厂的采购员翻着厚厚的企业黄页打电话,一天能询价五家供应商算高效率;今天,大模型能把一份语焉不详的采购需求秒级解析成结构化清单,匹配上百家供应商。三年前,设备维护靠老师傅“听音辨障”,轴承异响意味着大修倒计时;今天,传感器数据流经过大模型推理,能提前72小时预警故障并给出维修工单。过去,查一个订单状态要打四个电话、问三个部门;现在,对着对话框敲一句“东莞仓的A型电机发到苏州了吗”,答案三秒回传。
这不是科幻叙事。大模型正在下沉,从互联网的流量池,沉到工厂的产线
、仓库和采购部。但工厂不是秀场,大模型要在轰鸣的机器旁边站稳脚跟,必须先在真问题上证明自己。智能采购匹配、设备预测性维护、供应链问答助手——这三个场景,是目前落地信号最明确、价值量最扎实的切口。
一、智能采购匹配:让非结构化需求不再“对不上人”
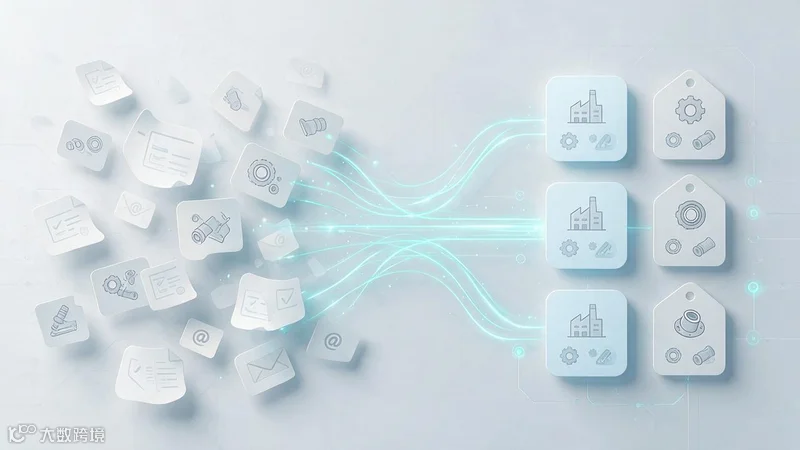
工厂采购最头疼的不是没有供应商,而是需求说不清、匹配全靠人肉。一家中型制造企业的采购需求,大量以非结构化形式存在:一封邮件写着“急需耐高温、耐腐蚀的密封件,用在化工泵上,介质是稀硫酸,温度180度左右”,或者一张草图随手标注“这个法兰要316L,压力等级别低于PN40”。过去,采购员得靠经验翻译成规格参数,再去供应商库里人工筛选,来回沟通成本极高,而且极度依赖个人判断。一旦熟手离职,整个寻源效率断崖式下跌。
大模型的介入改变了这条链路。它的核心能力恰好是理解非结构化语言,并将其映射到可执行的物料编码和供应商标签体系上。当采购员把那段需求描述输入系统,大模型能自动抽取关键参数——材质要求316L、介质稀硫酸、温度180℃、压力等级PN40——然后与物料主数据中的规格字段做语义级比对,而不是简单关键词匹配。这意味着,即使供应商录入的信息表述不同(比如“适用于酸性介质”“耐温≤200℃”),也能被模型识别为潜在匹配项。
更进一步,大模型还能结合历史采购记录、供应商绩效评分、交期承诺、价格区间等维度做综合推荐。比如某电子代工厂引入智能采购匹配后,寻源周期从平均五天压缩到一天以内,非标件的首次匹配准确率提升了约35%。降的不只是寻源成本,更是隐性知识从人脑向系统的迁移——老师傅的“什么料找谁”开始变成可复用的模型能力。
但要注意,这个场景的落地前提是物料主数据质量不能太差。如果企业连统一的物料编码都没有,大模型再聪明也无从对齐。所以智能采购匹配的第一步,往往是先做一轮数据清洗与物料标准化,这本身就是产业互联网的老课,大模型是催化剂,不是替代品。
二、设备预测性维护:从“坏了再修”到“提前72小时知道”
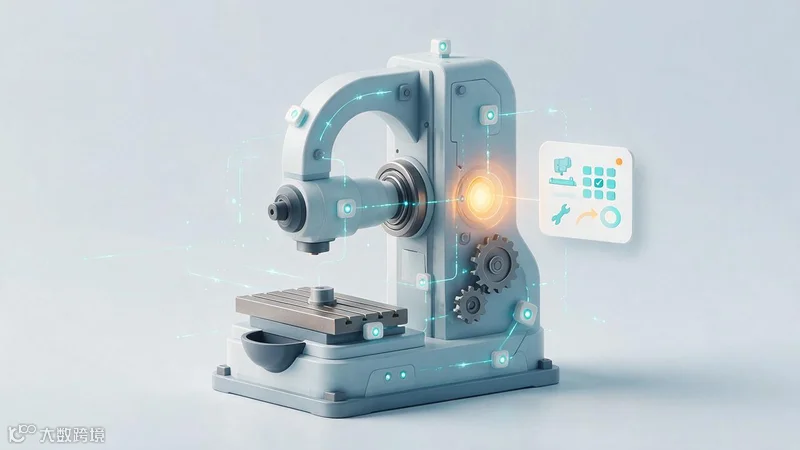
传统设备维护,要么是定期检修(不管坏没坏,到点就拆),要么是事后维修(坏了再抢修)。前者浪费,后者被动。预测性维护喊了很多年,真正落地的难点在于:传感器数据是死的,规则引擎只能处理已知故障模式,面对复杂工况的多变量耦合,误报率和漏报率居高不下。
大模型带来一个关键变化:它能把时间序列的传感器数据与历史维修记录、设备手册、甚至维修工单中的文字描述融合起来做推理。一台数控机床的振动频谱出现微妙漂移,传统规则可能不触发警报,但大模型如果“读过”这台设备过去三年的维修记录,知道上次出现类似漂移后36小时发生了主轴轴承过热,它就能给出一个带有置信度的预警,并推荐具体的维修方案——比如“建议停机更换轴承,预计耗时4小时,所需备件编号XXXX,库存现有2件”。
这种能力的本质,是大模型对多模态工业数据的联合建模能力。振动、温度、电流等结构化时序数据,加上维修工单、操作日志、设备说明书等非结构化文本,被模型编码到同一个语义空间里。当实时数据进入,模型做的不是简单的阈值判断,而是类比推理。它像一个经验丰富的老师傅,只不过这个老师傅同时盯着全厂五千个测点,而且永不睡觉。
现实案例中,某钢铁企业的高炉风机控制系统在引入大模型预测性维护后,非计划停机时间下降了约28%,单次抢修成本降低明显。更重要的是,维修建议的准确率让一线工程师愿意用了——这是关键。预测性维护系统最大的失败不是技术不准,而是维修人员不信。大模型给出的不是冷冰冰的告警代码,而是带有解释性的文字建议,这大幅降低了人的采纳门槛。
不过,这个场景的算力要求不低。实时高频传感器数据意味着边缘侧需要部署轻量化模型,云端跑大模型做异步分析。架构上一定是“云边协同”,别指望一个超大模型直接塞进产线。
三、供应链问答助手:让ERP、WMS、TMS第一次“开口说话”
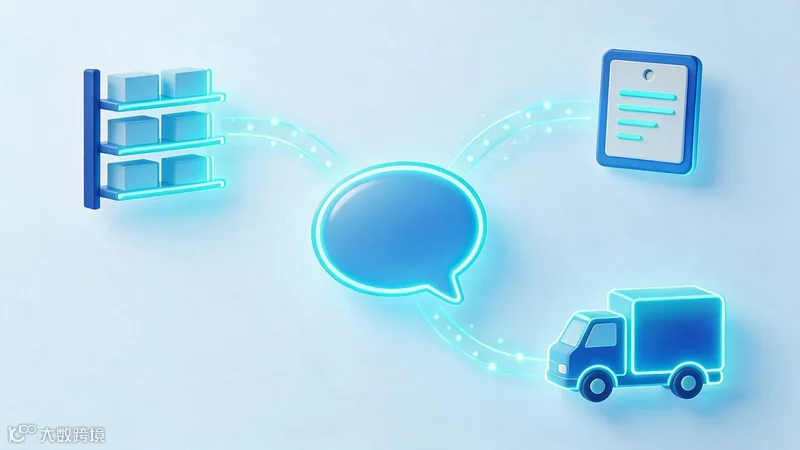
工厂里的信息系统普遍是孤岛。ERP管订单和财务,WMS管库存,TMS管运输,MES管生产执行。数据各自躺着,互不相通。供应链经理问一句“苏州客户的那个加急订单到哪了”,需要在三个系统里来回切换,账号密码都能烦死。这就是供应链问答助手的切入点。
大模型在这里的角色是自然语言接口。但不是简单地把问题转成SQL语句去查数据库——那种做法太脆了,用户表达稍微一变化就崩。更现实的方案是:大模型理解用户意图后,通过API调用去各系统的接口拉数,然后把结果汇总成一句话回复。比如用户敲“查一下A客户上个月的所有订单交付情况”,模型知道这是要跨ERP(订单状态)+ WMS(出库记录)+ TMS(签收信息)三个源,然后依次取数、拼接、生成一段结构化总结。
这种能力看起来像“智能客服”,但含金量在背后:它要求模型理解供应链业务逻辑。查“库存”要区分可用库存、锁定库存、在途库存;问“订单状态”要能区分已下达、已排产、已完工、已发货、已签收。如果模型不懂这些术语背后的业务含义,回答就会牛头不对马嘴。所以供应链问答助手的落地,本质上是把供应链领域的知识图谱或规则体系与大模型的语言能力结合——RAG(检索增强生成)是目前主流的折中路径。
某家电制造企业上线供应链问答助手后,供应链计划团队的日常数据查询工作量下降了约40%,跨部门沟通邮件数量明显减少。但必须诚实地说,这个场景的价值密度取决于员工使用频率。如果一线人员习惯没改过来,还是打电话问,系统再好也白搭。所以上线后的运营推广,跟技术开发同等重要。
四、落地成本与边界:算力、数据、微调,以及大模型不能碰的决策
以上三个场景听起来美好,但工业落地绕不开成本账。 因为这里有三本帐要算。第一,就是算力投入。大模型推理不是免费的。预测性维护需要边缘算力,采购匹配和问答助手需要云端GPU集群。对中小企业而言,从头训练行业大模型完全是奢望,现实路径是用开源基础模型(如Llama系列、通义千问等)做轻量级微调,配合RAG和Prompt工程。推理成本可以通过量化、蒸馏、批处理等手段压下来,但依然是持续性支出。一个中型工厂如果三个场景全上、使用频次中等,每年的GPU推理成本大致在数十万到百万元级别,这还没算IT团队的维护人力。
第二,是数据治理。这往往是被低估的最大隐性成本。大模型的效果天花板由数据质量决定,而大多数工厂的数据现状是:物料编码不统一、维修记录写的是“修好了”三个字、传感器采集数据有断点。要让大模型真正可用,前期数据清洗、标注、结构化的工作量可能占整个项目周期的60%以上。数据治理不是一次性的,而是与模型迭代并行的长期工程。
第三,是模型微调。通用大模型不懂工业行话,必须输入行业语料。这个过程的成本不算暴高,但需要懂业务的人参与标注与评估。一条非标采购需求的理解准确率从80%提升到95%,背后可能就是几千条高质量标注数据的差距。微调的技术门槛在降低,但业务know-how的门槛没有降低。
最后,也是最关键的,是大模型的边界。它可以在给定条件下做匹配、做预测、做总结,但不能替代那些需要承担责任的决策。产线排产冲突时,该优先哪张单?设备预警后,是否真的停机?供应商谈判中的价格底线该不该让?这些决策涉及商业风险、安全责任和组织政治,大模型给的是参考,签字负责的必须是人。工厂的本质不是信息处理系统,而是权责体系。大模型能压缩信息处理的成本,但不能替代承担后果的主体。那些试图让AI替人拍板的项目,最后都会在第一次事故面前现出原形。
大模型进工厂,目前最务实的姿态是:把三个场景做成闭环——采购匹配省时间、预测维护降损失、问答助手提效率。跑通一个算一个,别贪大求全。产业互联网的节奏从来不是互联网式的闪电扩张,而是车间里的渐进演化。
在视频剪辑领域,AI工具同样遵循着“辅助而非替代”的逻辑——智能剪裁和自动字幕让创作者从重复劳动中解放,但叙事节奏的把控仍需人的审美判断。工厂同理:大模型把采购员从信息检索中解放,把维修工从盲目巡检中解放,把供应链经理从跨系统查询中解放,但判断、权衡、担责,始终是人。
大模型的真正价值,不在于它比人聪明,而在于它让人能专注做那些只有人能做的事。正如AI视频剪辑工具的价值不在于取代剪辑师,而在于让创作者有更多精力投入创意本身【引文1】。工厂里的逻辑一样:让机器处理信息,让人承担决策。边界清晰了,落地才不虚。