

导读
很多边界明确的企业任务,通用大模型已经跨过可用门槛。新的问题不再只是模型能不能做,而是能否用满足质量要求的最小模型稳定完成。本文拆解一条更现实的路径:先用大模型验证任务并生成候选样本,经过筛选形成蒸馏数据,再用监督微调让小模型承接高频任务,同时说明 LoRA、缓存和模型路由各自解决什么问题。
 ⬆️AI生成
微调回来了,但不是原来那种回来
早期做大模型应用,团队最常问的是:这个任务,模型到底能不能做?专业术语听不懂,固定格式老出错,中文指令也不够稳。团队只能整理和标注任务数据,再通过监督微调(Supervised Fine-Tuning,SFT)让模型学习预期的输入输出关系。
那时微调主要补能力。
后来,通用大模型变强了。对分类、抽取、审核、格式转换等边界明确的任务,Prompt、少量示例和检索增强生成(RAG)往往已经能把结果做到可用。OpenAI 当前的模型优化流程也是先做评测和 Prompt 工程,再判断是否值得微调,而不是拿到任务就训练。
于是问题换了。
既然强模型已经证明任务能做,我们还有必要让它处理每一次请求吗?如果一个任务每天重复成千上万次,每次都携带一长段示例和规则,再便宜的 API 单价也会慢慢长出牙齿。
我接触的一些团队,讨论重点已经从“要不要微调”变成了“这一步到底值不值得调用最贵的模型”。
这一次,微调不是为了追赶能力上限,而是为了把已经验证过的能力压进更小、更便宜的模型。回来的不是能力焦虑,是经济账。
大模型负责验证,小模型负责重复交付
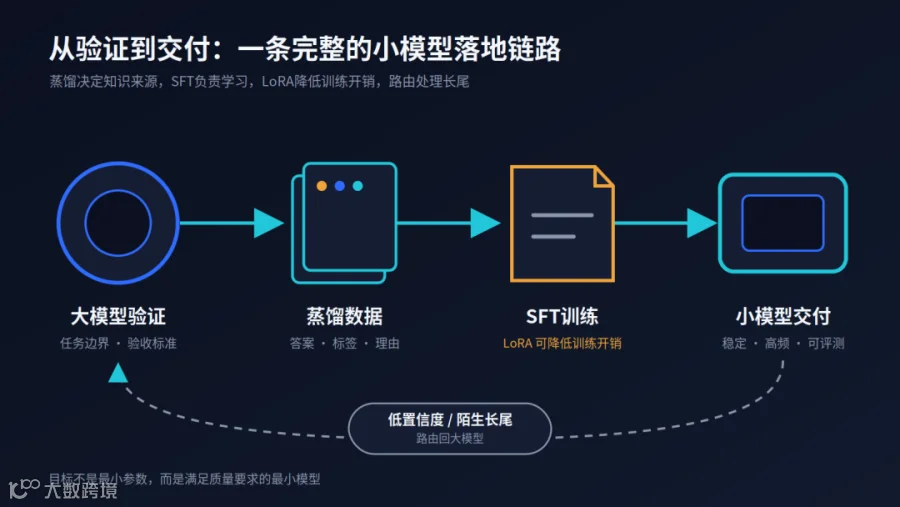
一条稳妥的落地路径,大致分成四步。
先让大模型跑通任务
用强模型探索任务边界,明确输入、合格输出、失败类型和验收指标。这里的大模型像一名成本不低的资深工程师:先把陌生问题做对,顺便告诉团队“好结果长什么样”。
别跳过评测。没有一组覆盖正常样本、边界样本和高风险错误的测试集,后面所谓“小模型接近大模型”,多半只是挑了几道顺眼的题自我感动。
把运行结果变成蒸馏数据
强模型生成的答案不能直接整包倒进训练集。需要筛掉事实错误、格式漂移和越权输出,保留经过规则或人工确认的样本。大模型还可以生成解释过程或任务理由,给小模型提供比最终标签更丰富的监督信号。
这一步就是知识蒸馏。大模型充当教师,小模型充当学生;教师提供答案、标签或理由,学生不需要复制教师的全部通用能力,只学习当前任务需要的那一部分。
Google Research 在 2023 年提出的 Distilling Step-by-Step 就利用了这条思路:不只让大模型给标签,还提取理由来训练小模型。论文在四个自然语言处理基准上的实验说明,经过专项训练的小模型,有机会用更少训练数据达到大型 Few-shot 模型在指定任务上的表现水平。
企业需要的不是一场模型竞赛,而是一个清楚的交付判断:小模型能否在指定任务上达到业务要求。评测集只需要回答这件事,以及哪些长尾请求仍应交回大模型。
再用SFT适配小模型,LoRA负责降低训练门槛
蒸馏解决“训练知识从哪里来”,SFT 解决“怎样让小模型学会这些样本”。SFT 是用“输入—理想输出”样本继续训练模型。数据如果来自教师大模型,这就是用蒸馏数据完成 SFT;数据如果全部来自人工标注,则只是普通 SFT,不一定属于蒸馏。
LoRA(Low-Rank Adaptation,低秩适配)解决的是训练开销。它冻结大部分原始参数,只训练少量新增参数,从而降低训练显存和存储压力。
这三者是一条可以衔接起来的链路:大模型产生蒸馏数据,小模型通过 SFT 学习,训练时再用 LoRA 降低资源需求。
模型也不是越小越好。正确目标是寻找“满足质量要求的最小模型”:从候选小模型开始评测,逐步缩小,直到准确率、延迟、稳定性或安全性触碰业务底线。停在底线之前,而不是一路缩到跑不动。
保留大模型处理长尾
小模型接管稳定、高频、容易验收的主干请求;开放式规划、复杂推理、陌生输入和低置信度结果,路由回大模型。这样做的不是一套“小模型至上”架构,而是一套大小模型分工的复合系统。
大模型负责探索边界,小模型负责复制确定性。
小模型微调,比继续省Token更省钱吗
有可能。不能一口咬死。
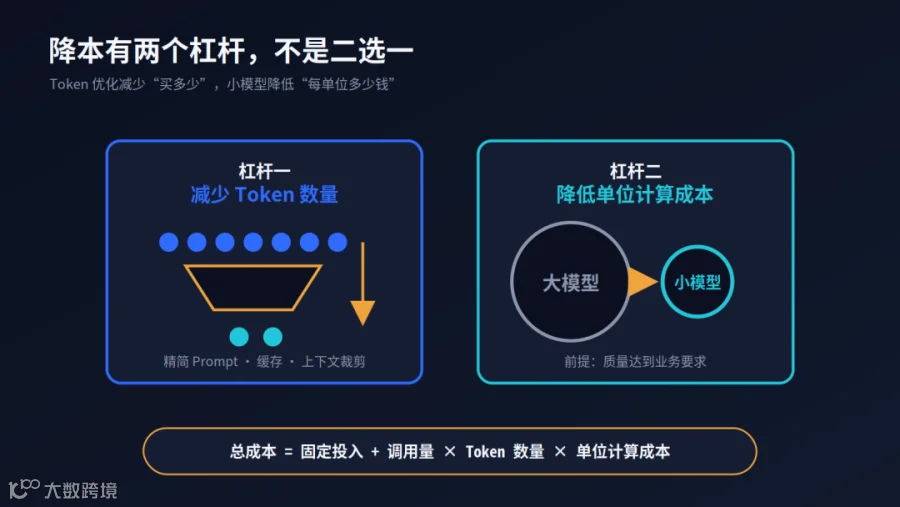
Token 优化和小模型微调动的是两笔不同的账:Prompt 精简、缓存和上下文裁剪减少 Token 数量;换用小模型降低每个 Token 的计算成本。前者是在少买一点,后者是在降低单价。
最佳答案通常不是二选一,而是:先删掉不该产生的 Token,再让剩余 Token 尽量由满足要求的最小模型处理。
判断微调值不值,可以先看一个朴素的不等式:
“训练、评测与维护成本 + 调用量 × 小模型单次成本 < 调用量 × 优化后大模型单次成本
调用量越大、任务越稳定,前期训练投入越容易摊薄。反过来,一个月只调用几百次、规则又频繁变化的任务,为它维护专用模型,可能比继续调用大模型更折腾。
还有第三条路:路由。
模型路由(Model Routing),指系统先判断请求的难度和风险,再决定调用哪个模型。简单、低风险的任务交给小模型;复杂任务、低置信度结果或关键操作升级到大模型。它不改变模型本身,而是在每次请求到来时分配能力。
比如客服系统可以让小模型处理意图分类、字段提取和固定回复,遇到多轮投诉、规则冲突或无法判断的问题,再转给大模型。微调让小模型更擅长这些窄任务,路由决定当前请求该交给谁。两者可以一起用。
路由也不是免费的。判断错了,简单任务可能被送进昂贵模型,复杂任务也可能被小模型接走。因此,路由器本身同样需要评测,并设置低置信度升级机制。
FrugalGPT 通过模型级联,让便宜模型先回答,必要时再升级到强模型;论文在其测试设置中报告了匹配最佳单一模型表现时最高 98% 的成本下降。RouteLLM 则学习在强弱模型间动态选择,在部分评测中把成本降低到一半以下,同时保持回答质量。
这些数字不能直接搬进每一家公司的预算表。它们真正说明的是:训练专用小模型不是唯一降本方案。当任务尚未稳定、调用量不足,先做缓存和路由,常常比立刻开一条训练流水线更稳。
哪些任务值得交给微调后的小模型
我会用五个问题筛一遍:
-
任务是否稳定? 输入输出定义三个月后还成立,才值得把行为写进权重。 -
结果是否可评测? 有标准答案、规则校验或清楚的业务指标,才能判断小模型有没有掉队。 -
调用是否足够频繁? 只有节省的推理成本能覆盖数据、训练和维护投入,经济账才闭合。 -
错误是否容易兜底? 低置信度结果可以升级到大模型,高风险操作还能交给规则或人工复核。 -
知识是否频繁变化? 高频更新的事实更适合放在检索系统里,不要反复训练进模型权重。
这套判断到了 Agent 场景会更有价值。Agent 把一次用户请求拆成规划、工具选择、抽取、格式化、校验等多次调用,其中不少步骤重复、窄且容易验收。2025 年一篇讨论 Agent 架构的立场论文据此提出:许多重复调用适合由小语言模型承担,通用对话和复杂决策则留给大模型,组成异构系统。
注意,它是一篇立场论文,不是行业已经盖章的结论。但方向很合理:Agent 放大的不只是 Token 数量,也放大了模型分工的收益。
所以,文章标题里的“微调又回来了”,并不是说行业绕了一圈,又回到每个任务都训练模型的年代。
恰恰相反。
大模型先把路走通,数据和评测把这条路固化,小模型再来跑那些稳定、重复、量大的班次。至于偶尔出现的陌生岔路,仍然交给更强的模型。
不是所有能力都值得按最高价购买。
参考资料
-
OpenAI 监督微调文档: https://developers.openai.com/api/docs/guides/supervised-fine-tuning -
LoRA 原始论文: https://arxiv.org/abs/2106.09685 -
Google Research《Distilling step-by-step》: https://research.google/blog/distilling-step-by-step-outperforming-larger-language-models-with-less-training-data-and-smaller-model-sizes/ -
Distilling Step-by-Step 原始论文: https://arxiv.org/abs/2305.02301 -
FrugalGPT 原始论文: https://arxiv.org/abs/2305.05176 -
RouteLLM 原始论文: https://arxiv.org/abs/2406.18665 -
《Small Language Models are the Future of Agentic AI》: https://arxiv.org/abs/2506.02153
文章仅做学术分享,如有侵权请联系删除,非常感谢!