

你好,我是郭震。如今,AI 工具已能精准复刻爆款视频:仅学习动作与运镜,无需照搬人物形象与画风。
通过上传参考视频,用户可将原视频中的人物替换为目标角色,甚至彻底改变画面风格。实测发现,真正的技术难点在于如何准确还原原片的动作细节、走位逻辑及运镜节奏。
本文将基于 LibTV 的「深度动作捕捉」功能,详解其实现原理与操作流程。
效果实测:从舞蹈到科幻场景
第一组测试选取了一段模仿《Beat It》的舞蹈视频,将原视频中的女性舞者替换为身着银白色服装的男性角色。
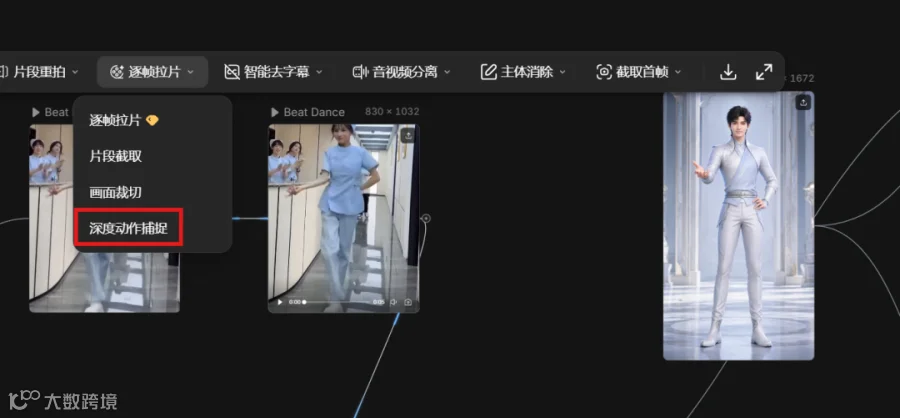
结果显示,生成视频中男角色的摆手、转身、抬腿及走位均与原片高度一致,但人物特征、服装及整体画风已完全重构。这种对连续动作的精准把控,仅靠提示词描述难以实现。
第二组测试提升了难度,选用了一段蝙蝠侠在科幻场景中奔跑、跳跃、翻越并落地的片段。该视频包含复杂的镜头跟随与空间位移。
测试中,将黑衣蝙蝠侠替换为白衣女侠。生成结果不仅完美对齐了人物的奔跑方向、跳跃落点与身体重心,还完整保留了镜头的推进节奏与跟拍逻辑,精确复现了角色与建筑、地面间的空间关系。

深度动作捕捉操作指南
LibTV 的操作流程简洁高效。首先将参考视频上传至画布,选中后点击顶部工具栏的「逐帧拉片」,在下拉菜单中选择「深度动作捕捉」。
处理完成后,画布将生成一段黑白灰度的“深度参考视频”。该视频弱化了原人物的面部、服装颜色及场景细节,仅保留核心的动作轨迹、走位路径、运镜方式及前后空间关系。
基于此,提示词(Prompt)的编写逻辑得以简化:只需定义目标角色与场景,动作与运镜直接由深度视频驱动。
以【场景素材】为底片,仅将【原人物】替换为【目标角色】,其他画面保持不变。
人物动作、走位和运镜参考【深度视频】,全程保持角色与场景一致。
针对复杂的蝙蝠侠跑酷片段,可先剪辑出关键分镜,逐个进行深度动作捕捉,再结合新角色图片与原始场景素材生成最终视频。

深度动作捕捉的核心价值
为何不直接上传原视频作为参考?对比测试揭示了答案。
测试使用一段 10 秒的原片(红衣女性奔跑、撑墙、翻越、倒地),目标是将其替换为银发未来女战士,场景改为月球基地。
方案一:直接使用原视频生成
虽然角色与场景替换成功,但动作出现明显偏移:起始镜头变为大远景,翻越位置错乱,且后半段无故增加了火花与金属装置等干扰元素。
方案二:使用深度动作参考生成
保持其他参数不变,仅将参考源替换为 LibTV 生成的深度视频。结果显示,奔跑、撑墙、翻越及倒地动作与原片高度吻合,人物位置稳定,镜头距离控制精准。
简而言之,深度动作捕捉通过弱化原视频的视觉干扰(人物、服装、背景),强制 AI 聚焦于“人物怎么动、往哪里走、镜头怎么跟”的核心逻辑。
智能剪辑:口播创作效率升级
除动作复户外,LibTV 的「智能剪辑—口播创作」功能同样表现出色。该功能可自动识别并删除录制素材中的停顿、重复及口误,将多段碎片素材整合为流畅视频。
传统人工剪辑需反复审片、裁剪拼接及添加字幕,耗时费力。而使用智能剪辑节点,仅需上传素材并输入简要指令即可。
实测中,两段合计 67 秒的原始口播素材,经自动粗剪后缩减至 44.4 秒,删减比例约 34%。系统自动去除了冗余内容并优化了叙事顺序。

确认粗剪无误后,系统可继续自动生成字幕与重点花字。原本需 1 小时的后期工作,现在仅需 10-15 分钟即可完成。
总结
本次实测表明,LibTV 的「深度动作捕捉」有效解决了 AI 视频生成中动作失控的痛点。它让 AI 能够精准参考原片的动作、走位与运镜,在更换角色或场景时依然保持空间关系的稳定性。
同时,「智能剪辑」功能显著降低了口播视频的制作门槛,自动处理无效片段,大幅缩短后期周期。
核心结论:深度动作捕捉让 AI 视频的动作逻辑更可控,确保换人换景而不“跑偏”;智能剪辑则实现了口播内容的自动化精修。