

今天翻DeepSeek官方定价页时,我注意到一句很关键的话:API整体价格计划在近期上调,而且预计涨幅显著。
新价格还没公布。我先不猜涨多少,而是回头看现有调用:哪些任务最花钱,缓存有没有命中,失败请求重试了几次。
已经把DeepSeek API接进客服、翻译、内容、研究或代码流程的团队,可以直接照着后面的步骤查。整套检查从最近30天日志开始,最后落到一份能复算的成本表和一套路由规则。
只有网页版、拿不到调用日志的团队,暂时做不了这套检查。API Key、客户原文和个人信息也不要上传,后面只处理脱敏后的计费字段。
先看一个常见现场:一家跨境SaaS团队每天要处理英文客服回复、产品文案翻译、长报告摘要和代码排错。负责人只看充值余额,却说不清哪类任务最花钱、缓存有没有命中、失败请求重试了几次。团队每月给AI API留了500美元预算,这次要做的,就是把这笔模糊账拆开。
我按这个顺序做:先导出30天调用数据,再用干活AI整理5张表,最后挑一个低风险任务跑7天对照。
PART 01
一、先把消息看准
核验日期:2026-08-08。
当前页面列了两种模型,我把单价分开记下来。
V4 Flash
-
缓存命中输入:0.0028美元/百万Token -
缓存未命中输入:0.14美元/百万Token -
输出:0.28美元/百万Token
V4 Pro
-
缓存命中输入:0.003625美元/百万Token -
缓存未命中输入:0.435美元/百万Token -
输出:0.87美元/百万Token
官方同一页面还写明:计划近期提高DeepSeek API整体价格,预计涨幅显著,具体价格方案以官方通知为准。
DeepSeek官方定价页
官方还没有公布新价格和执行日期。下面出现的1.5倍、2倍、3倍,只用来测试预算承受能力,不是对实际涨幅的预测。
官方Chat Completions响应中的usage对象可以直接得到:
prompt_tokens:输入Token
completion_tokens:输出Token
prompt_cache_hit_tokens:缓存命中输入Token
prompt_cache_miss_tokens:缓存未命中输入Token
total_tokens:输入与输出总Token
completion_tokens_details.reasoning_tokens:推理Token
其中:
prompt_tokens = prompt_cache_hit_tokens + prompt_cache_miss_tokens
DeepSeek Chat Completions官方文档
PART 02
二、先把最近30天的花费算清楚
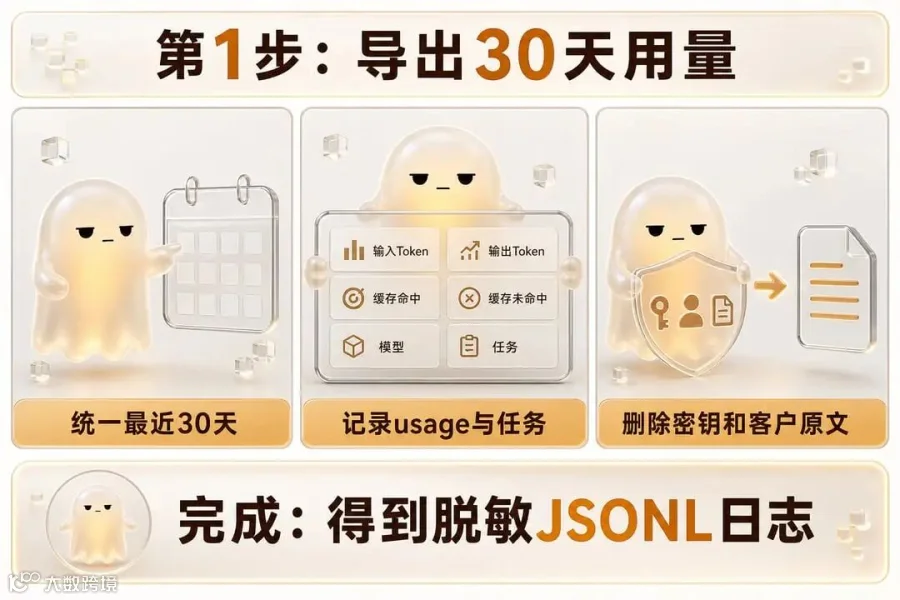
第1步 · 先得到可计费、可复算的脱敏JSONL日志
先定好数据边界
统计最近30个完整自然日,不包含今天。日志中保留计费和任务字段,删除以下内容:
-
API Key与请求签名; -
客户姓名、邮箱、电话和订单号; -
完整Prompt与完整模型回复; -
数据库连接、Cookie和内部访问凭证; -
可以反推个人身份的原始文本。
把每次调用记成同一种格式
如果你的网关能记录JSONL,每次调用保存一行:
{
"timestamp": "2026-08-01T09:30:00+08:00",
"task": "customer_reply",
"model": "deepseek-v4-flash",
"usage": {
"prompt_tokens": 12000,
"completion_tokens": 800,
"prompt_cache_hit_tokens": 9000,
"prompt_cache_miss_tokens": 3000,
"total_tokens": 12800
},
"latency_ms": 1850,
"success": true,
"human_rework": 0
}
task字段不要写项目名,要写可以横向比较的任务类型:
customer_reply:客服回复
translation:翻译
product_copy:产品文案
report_summary:长报告摘要
research:研究分析
code_debug:代码排错
如果现有日志没有task,先用接口名称、调用入口或业务流程人工映射,不能让AI凭内容猜客户隐私。
用这段脚本把JSONL转成CSV
将下面代码保存为deepseek_cost_audit.py,把日志文件命名为deepseek_usage.jsonl,两个文件放在同一目录后运行:
import csv
import json
from collections import defaultdict
from pathlib import Path
PRICES = {
"deepseek-v4-flash": {
"cache_hit": 0.0028,
"cache_miss": 0.14,
"output": 0.28,
},
"deepseek-v4-pro": {
"cache_hit": 0.003625,
"cache_miss": 0.435,
"output": 0.87,
},
}
SOURCE = Path("deepseek_usage.jsonl")
DETAIL = Path("01-deepseek-call-cost.csv")
SUMMARY = Path("02-deepseek-task-summary.csv")
def calc_cost(model, hit, miss, output):
price = PRICES.get(model)
if not price:
return None
return (
hit / 1_000_000 * price["cache_hit"]
+ miss / 1_000_000 * price["cache_miss"]
+ output / 1_000_000 * price["output"]
)
rows = []
summary = defaultdict(lambda: {
"calls": 0, "hit": 0, "miss": 0, "output": 0,
"cost": 0.0, "success": 0, "rework": 0,
})
with SOURCE.open("r", encoding="utf-8") as source:
for line_no, line in enumerate(source, 1):
if not line.strip():
continue
record = json.loads(line)
usage = record.get("usage", {})
model = record.get("model", "unknown")
task = record.get("task", "unclassified")
hit = int(usage.get("prompt_cache_hit_tokens", 0))
miss = int(usage.get("prompt_cache_miss_tokens", 0))
output = int(usage.get("completion_tokens", 0))
prompt = int(usage.get("prompt_tokens", hit + miss))
cost = calc_cost(model, hit, miss, output)
if prompt != hit + miss:
raise ValueError(f"Line {line_no}: prompt_tokens != cache_hit + cache_miss")
row = {
"timestamp": record.get("timestamp", ""),
"task": task,
"model": model,
"prompt_tokens": prompt,
"cache_hit_tokens": hit,
"cache_miss_tokens": miss,
"completion_tokens": output,
"cache_hit_rate": round(hit / prompt, 4) if prompt else 0,
"cost_usd": round(cost, 8) if cost is not None else "PRICE_REQUIRED",
"latency_ms": record.get("latency_ms", ""),
"success": bool(record.get("success", False)),
"human_rework": int(record.get("human_rework", 0)),
}
rows.append(row)
if cost is not None:
key = (task, model)
agg = summary[key]
agg["calls"] += 1
agg["hit"] += hit
agg["miss"] += miss
agg["output"] += output
agg["cost"] += cost
agg["success"] += int(row["success"])
agg["rework"] += row["human_rework"]
if not rows:
raise SystemExit("No usable records found")
with DETAIL.open("w", newline="", encoding="utf-8-sig") as target:
writer = csv.DictWriter(target, fieldnames=rows[0].keys())
writer.writeheader()
writer.writerows(rows)
summary_rows = []
for (task, model), agg in sorted(summary.items()):
total_input = agg["hit"] + agg["miss"]
summary_rows.append({
"task": task,
"model": model,
"calls": agg["calls"],
"cache_hit_rate": round(agg["hit"] / total_input, 4) if total_input else 0,
"total_cost_usd": round(agg["cost"], 6),
"avg_cost_per_call_usd": round(agg["cost"] / agg["calls"], 8),
"success_rate": round(agg["success"] / agg["calls"], 4),
"human_rework_rate": round(agg["rework"] / agg["calls"], 4),
})
with SUMMARY.open("w", newline="", encoding="utf-8-sig") as target:
writer = csv.DictWriter(target, fieldnames=summary_rows[0].keys())
writer.writeheader()
writer.writerows(summary_rows)
print(f"Created {DETAIL} and {SUMMARY}")
运行:
python deepseek_cost_audit.py
预期输出:
Created 01-deepseek-call-cost.csv and 02-deepseek-task-summary.csv
输入样例与费用复算
假设一个月产生:
缓存命中输入:1000万Token
缓存未命中输入:500万Token
输出:300万Token
按当前官方价格复算:
V4 Flash:1.568美元
V4 Pro:4.82125美元
这只是Token计费示例,不包括你的网关、存储、向量数据库、重试、人工复核和其他服务成本。
我跑完脚本后,先核这几件事
-
两个CSV能正常打开,中文不乱码; -
每一行有时间、任务、模型和Token字段; -
prompt_tokens等于缓存命中与未命中之和; -
未识别模型显示 PRICE_REQUIRED,没有偷偷套用其他模型价格; -
原始Prompt、回复和API Key没有出现在CSV中。
有问题先查这里
-
没有缓存字段:先记录 prompt_tokens和completion_tokens,缓存成本标“无法拆分”,不要假设全未命中; -
没有任务字段:按接口或流程补映射表,不上传原始客户内容; -
金额与平台余额不一致:检查赠送余额、充值余额、重试、流式中断和统计时区; -
模型名称变化:到官方定价页更新 PRICES,不要沿用旧价格; -
JSON解析失败:定位报错行,确认每行是一个完整JSON对象。
PART 03
三、把账单交给干活AI拆成5张表
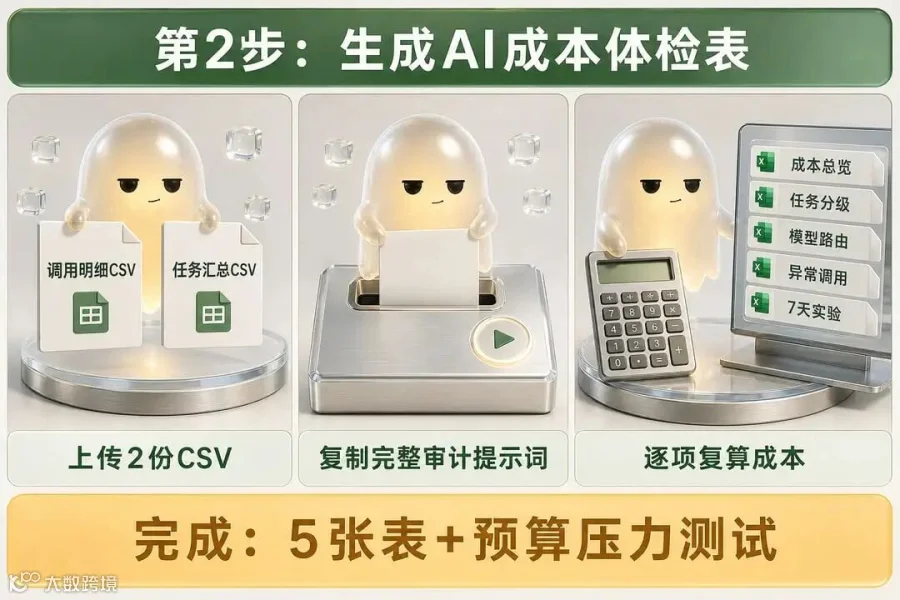
第2步 · 用同一份数据生成成本总览、任务分级、模型路由、异常调用和7天实验
上传:
01-deepseek-call-cost.csv
02-deepseek-task-summary.csv
另外手工填写一张任务标准表:
任务:customer_reply
业务重要度:高
质量验收:事实正确、语气合规、无虚构承诺
人工返工上限:5%
响应时间上限:5秒
允许降级:否
任务:translation
业务重要度:中
质量验收:术语一致、数字不变、语言自然
人工返工上限:10%
响应时间上限:10秒
允许降级:是
把这段审计要求一起贴进去
你是AI API成本审计员。我上传了:
1. 逐调用成本明细;
2. 按任务与模型汇总表;
3. 任务质量标准表。
请严格按顺序执行:
A. 数据检查
- 检查日期范围、模型名称、Token字段、任务字段和空值;
- 验证prompt_tokens=cache_hit_tokens+cache_miss_tokens;
- 缺字段时先停止,列出缺失项,不要猜。
B. 当前成本基线
- 按任务、模型、日期统计调用量、总成本、单次成本;
- 统计缓存命中率、成功率、人工返工率;
- 标出成本最高的前20个任务组合;
- 不使用行业平均值。
C. 预算压力测试
- 以当前成本为基线,分别计算价格1.5倍、2倍、3倍的月预算;
- 这些只是情景,不得写成DeepSeek已公布涨幅;
- 标出超过团队月预算的情景与日期。
D. 任务分级
- 分为S级关键、A级重要、B级标准、C级批量;
- 质量标准优先于成本;
- 不因成本高就自动降级关键任务。
E. 模型路由
- 给出“当前模型、候选模型、触发条件、回退模型、人工复核”五列;
- 只使用我提供并验证过价格与能力的候选模型;
- 无官方证据的价格标待核验;
- 不输出API Key或客户原文。
F. 异常识别
- 标出单次成本异常、缓存命中骤降、失败重试、输出Token异常、无人使用的夜间调用;
- 每条异常引用原始文件行号;
- 给出负责人和截止日字段。
G. 输出Excel
生成5张工作表:
1. 成本总览;
2. 任务分级;
3. 模型路由;
4. 异常调用;
5. 7天实验记录。
H. 最终结论
只能三选一:
- 保持当前路由;
- 修复后再调整;
- 立即限制异常调用。
所有数字必须可用上传数据复算,不得保证节省比例。
这5张表分别用来做什么
成本总览:放日期、任务、模型、调用量、成本和缓存命中率。表里的总成本必须能从原始CSV复算。
任务分级:记录任务重要度、质量标准、返工上限、是否允许降级和负责人。
模型路由:记录主模型、触发条件、回退模型和哪些请求必须人工复核。
异常调用:每条异常都要带证据行、影响、负责人和截止日期,不能只写一句“成本偏高”。
7天实验记录:把组别、质量、成本、延迟、返工和结论放在一起,最后据此决定保留、修复还是停止。
在这组示例数据里,结论会这样写
结论:修复后再调整。
发现:
1. 长报告摘要占总成本42%,但业务重要度仅为B级;
2. 客服回复缓存命中率从68%下降到21%;
3. 失败请求平均重试3.4次;
4. product_copy使用V4 Pro,但质量通过率与Flash测试样本差异待验证;
5. code_debug为S级任务,不建议仅因价格降级。
先修复:
- 排查缓存Key和固定前缀;
- 给失败重试设置次数与退避;
- 对product_copy跑7天对照;
- 保持code_debug主模型不变。
PART 04
四、挑一个任务跑7天对照

第3步 · 只做保留、修复或停止三选一
先别全量切换
每个候选任务至少准备20个脱敏、可重复验收的样本。先选一个B级或C级任务,不拿关键客服、支付、法律或安全任务做第一轮实验。
对照组:当前模型与当前Prompt
实验组:候选模型或新路由
固定项:输入、温度、最大输出、工具、质量标准
观察项:成本、通过率、P95延迟、返工率、失败率
每天照这个模板记录
日期:2026-08-09
任务:translation
样本编号:T-001
组别:对照/实验
模型:
输入Token:
输出Token:
缓存命中Token:
成本:
质量通过:是/否
人工返工:0/1
延迟毫秒:
错误类型:
审核人:
每天把这些数据记全
我不只看成本。质量通过率、人工返工、P95响应时间、失败和重试次数必须放在同一张记录里,否则“更便宜”没有判断意义。
出现这些情况,我会停掉实验
-
关键事实错误或客户承诺错误; -
人工返工超过任务标准; -
失败重试抵消节省的Token成本; -
P95延迟超过业务可接受上限; -
路由规则无法解释或无法回退; -
日预算超过团队预设红线。
我把7天拆成三个阶段
前两天只做数据准备:保存官方价格页、导出30天日志、运行脚本并生成两份CSV。
第3天处理基础问题,包括缓存Key、失败重试和没有任务标签的调用。基础问题没修好,不进入模型对照。
第4天开始选一个B级任务做实验。后面每天记录质量、成本、延迟、返工和失败;第7天根据异常样本和回退策略决定保留、修复还是停止。
PART 05
五、最容易踩的几个坑
-
只看到充值余额:改为逐调用记录 usage字段。 -
把1.5倍写成正式涨幅:改回预算压力测试情景。 -
缓存成本算不清:检查命中与未命中Token字段。 -
AI推荐了不存在的模型:候选池只放已经核验过的模型。 -
成本下降但返工上升:以任务质量标准否决这条路由。 -
日志泄露客户内容:只上传脱敏计费字段和任务标签。 -
一次切换全部任务:先跑一个低风险任务的7天对照。
PART 06
六、提交前我再核一遍
[ ] 官方价格与核验日期已保存
[ ] 最近30天调用日志已脱敏
[ ] 两个CSV能复算总成本
[ ] 五张Excel工作表完整
[ ] 每个任务有质量标准和负责人
[ ] 涨价情景明确标为假设
[ ] 路由有主模型、回退模型和停止条件
[ ] 7天实验记录质量、成本、延迟、返工与失败
[ ] API Key、客户原文和个人信息未上传
PART 07
我最后留下的判断
这次检查最有价值的结果,不是猜DeepSeek会涨多少,而是把每类任务的Token、缓存、重试和模型选择放进同一张表。
基线建好以后,官方价格变化时只需要更新单价。哪些任务需要高成本模型,哪些异常调用应该先停,也都有记录可以追溯。
本文不构成采购或投资建议;模型价格、能力与接口支持范围,以DeepSeek官方最新页面为准。