


“ 模达卓越,智启未来”

www.modatech.com.cn / www.modatech.cn

“ 模达卓越,智启未来”
 模达科技
www.modatech.com.cn / www.modatech.cn

国内外大模型发展如火如荼,近期有哪些值得关注的新闻?一起看看吧!
国际篇
INTERNATIONAL NEWS
-
AI视频平台Higgsfield融资4亿美元、估值54亿:高盛英特尔入局
据《金融时报》报道,AI视频生成平台Higgsfield已从DST Global、高盛、Liberty Global和英特尔等投资方筹得4亿美元,公司估值升至54亿美元。这家成立仅两年的初创企业正加速拓展企业订阅业务,商业化进程明显提速。
8个月估值翻四倍,年化收入冲7亿
本轮融资距其上轮仅过去8个月——当时Higgsfield以13亿美元估值融资 8000万美元,由前Snapchat高管Alex Mashrabov创立。公司2025年才正式推出,如今年化收入已在今年8月达到7亿美元,而约一年前这一数字仅为2000万美元。
用户规模同样猛涨:Higgsfield目前覆盖全球238个国家和地区、拥有超 3000万用户,美国是其最大市场。不到两年从零起步到7亿美元年化收入,增长曲线在AI视频赛道颇为亮眼。
从青少年滤镜到企业营销引擎
Mashrabov表示,新融资将助公司加快向高端市场拓展,目前大部分收入已来自企业客户,而今年1月这一比例还不到25%。他回忆在Snapchat开发面部滤镜时主要服务青少年娱乐,如今Higgsfield正改变大型企业开展营销的方式。
新一代创作者与品牌正借AI制作更精致的视觉内容,Dollar Shave Club等数百家直接面向消费者的品牌已每天用Higgsfield生成多条视频,而非围绕单次活动只做一条素材。Mashrabov称,社交团队借此跟上内容快速迭代的节奏,同时降低对昂贵创意代理机构的依赖。
高盛估计,全球创作者经济规模有望从2023年的2500亿美元增至2027年的4800亿美元。Mashrabov也坦言算力当前十分紧缺,本轮融资将用于提前锁定大量算力,并继续投入企业级产品与安全建设——尽管其曾涉足AI生成电影引发好莱坞担忧,公司如今已明显把重心转向企业营销客户。
-
Anthropic首度披露Model2 模型:性能超越当前最强AI
人工智能领域近期迎来新的技术动向。根据Anthropic于8月15日发布的《2026年8月风险报告》显示,该公司首次公开了尚未正式发布的全新AI模型——Model 2。
从报告披露的各项细节来看,Model 2在多项基准任务上的综合表现要优于目前公开的行业最强模型Claude Mythos 5。不过,业内分析指出,相较于前代产品,Model 2带来的性能增幅相对较为温和,其核心意义在于进一步夯实并提升AI模型的整体综合能力,而非进行颠覆式的跨越。
根据Anthropic内部的“CoBench v2”基准测试结果,该报告中还同步出现了关于Model 1的相关称谓。外界据此推测,Model 2很可能是Model 1的后继演进版本,两者大概率属于Claude Mythos Preview这一技术路线的进一步深度迭代与升级。
图源:网络
-
Adobe Firefly音频工具全面上线,支持AI生成音乐、语音和音效
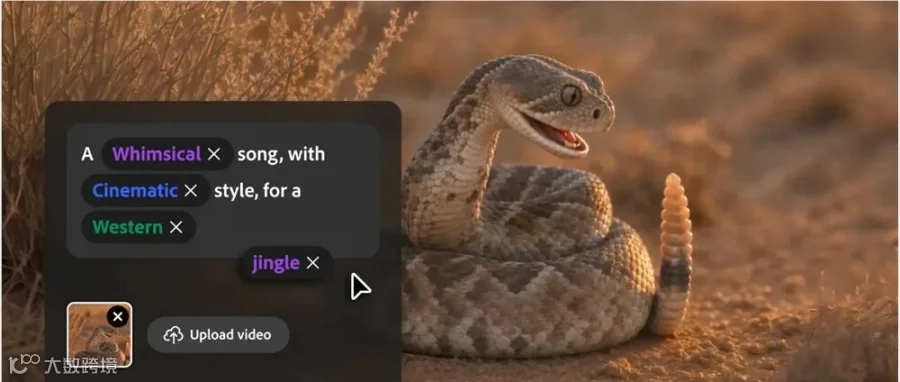
Adobe正式推出Firefly音频生成工具,包括“生成音乐”“生成语音”和“生成音效”,用户可直接在Firefly桌面及移动Web应用中创建商业安全的音频内容,进一步将AI音频能力融入视频创作流程。
Adobe与伯克利音乐学院近期调查显示,100%的受访视频创作者、音乐人和营销人员会在视频中使用音乐,其中32.7%已使用AI生成音乐;43.2%将法律及版权风险、38.9%将授权费用视为主要障碍。
针对这些痛点,Firefly“生成音乐”可根据视频内容、氛围、节奏和时长生成原创且完全授权的音乐,并提供4个方案供用户编辑选择。Adobe表示,生成内容无需额外订阅即可用于商业作品。
“生成语音”可将脚本转换为自然旁白,支持Adobe Firefly语音模型及ElevenLabs模型,并可通过表现力、发音等标签调整语音效果;“生成音效”则支持文本提示或录制声音作为参考,生成与画面动作、节奏和氛围匹配的音效。
与此同时,Adobe继续扩展Firefly第三方模型生态,新增Gemini Omni Flash,可结合视频、音频和图像进行内容创作。此前Firefly已加入Runway Aleph2.0和Kling2.0,目前模型阵容涵盖Google、Kling AI、Luma AI、OpenAI、Runway及Adobe自有模型。Adobe正通过整合多模型与多模态音视频能力,进一步完善Firefly一站式AI创作工作流。
图源:网络
-
OpenAI计划2027年完成IPO,已秘密提交上市文件
据CNBC报道,OpenAI首席财务官萨拉·弗里亚尔在当地时间周三举行的全员会议上向员工透露,公司计划于2027年完成上市,如果业务发展持续向好,也可能提前进入公开市场。
知情人士称,弗里亚尔在会议中表示,IPO并非公司的终点,而是未来融资和发展过程中的重要里程碑。她提到,OpenAI已于今年3月完成1220亿美元融资,这笔资金为公司后续业务扩张提供了较大的运营空间。
据了解,OpenAI已于今年6月向美国证券交易委员会(SEC)秘密提交IPO招股文件,但目前尚未公布具体上市时间表。与此同时,竞争对手Anthropic也已向监管机构秘密递交相关文件,并开始与潜在投资者进行初步沟通,以评估市场反应。
面对Anthropic可能率先上市的情况,弗里亚尔在会议中表示,OpenAI将按照自身节奏推进上市计划,并不受竞争对手时间表影响。她透露,两家公司均已完成保密申报,Anthropic可能在未来数周内解除保密状态,并最快于9月登陆资本市场。
随着生成式AI产业进入商业化加速阶段,头部AI企业正通过融资、上市等方式扩大算力投入和技术研发能力。OpenAI与Anthropic围绕模型能力、企业服务和资本市场表现展开的竞争,也将成为未来AI产业发展的重要观察点。

-
Grok Build重磅上线网页与移动端,人人皆可一句话秒变全栈开发者
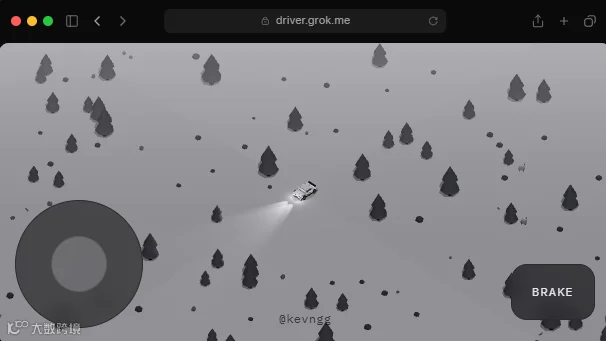
随着大模型向应用层和生产力的深度渗透,AI原生应用的开发门槛正在被彻底打破。xAI近日正式宣布,其备受瞩目的应用构建功能Grok Build已全面结束早期测试,正式面向所有套餐用户开放,并全面覆盖网页端、iOS以及Android移动端。
在核心功能体验上,Grok Build展现出了极高的便捷性与直观性。用户只需在与Grok的日常对话中,用自然语言详细描述自己想要的应用、小游戏、网站或数据仪表盘,系统便能在对话界面中实时生成并运行完整版本。自7月份推出早期测试版以来,该功能经历了高速迭代,不仅大幅提升了生成速度,更彻底打通了从创意构思、内容发布到社群分享的完整闭环。
为了让用户的创意能够无缝触达受众,Grok Build推出了强大的社交分发机制。用户发布的应用不仅会获得一个专属的grok.me独立链接,支持自由设定访问权限并绑定个人专属域名,还会自动生成专属的富预览封面图。当这些应用被分享到X(原 Twitter)等信息流平台时,它们将不再以生硬的单调链接呈现,而是直接以支持互动预览的内联卡片形式展现,甚至允许用户在信息流内直接试玩。
在功能扩展与底层生态方面,此次全量上线带来了多项重磅升级。应用现在可以直接调用xAI API,在代码内部直接接入Grok的对话、图像生成以及语音合成能力,无需繁琐地管理和轮换API密钥。此外,新版本还同步推出了混谐(Remix)功能,允许其他用户对已发布的应用进行二次分叉与改造;支持一键将整个项目导出至GitHub仓库进行深度开发;引入了独立的第三方API密钥管理机制;并支持接入核心业务数据,打造出可实时筛选的动态仪表盘。
图源:网络

国内篇
DOMESTIC NEWS
-
宇树科技发布“超人”人形机器人:原地跳高2米、极速12.66m/s
8月17日,宇树科技发布了一段名为“超人”的人形机器人演示视频。该机器人凭借0.85米的腿长,可实现原地跳高2米,极限奔跑速度达到12.66m/s,两项指标均超越人类现有世界纪录。
据宇树科技披露,该全新整机研发周期仅三个多月,未来数月仍有较大的性能完善空间。此次发布的“超人”机器人展示了宇树在足式机器人运动控制与高功率密度关节技术上的最新突破,为其在工业巡检、特种作业等场景的部署提供了技术验证。

-
阿里AI音乐模型“快乐虾米”HappyShrimp 1.0上线
阿里巴巴8月17日通过公众号宣布,AI音乐模型 HappyShrimp 1.0(中文名快乐虾米)正式上线。HappyShrimp能精准理解自然语言,可以把你的一种情绪、一个故事或一段记忆变成一首完整的音乐。
根据介绍,HappyShrimp从研发之初就选择了降低创作门槛:在乐理、编曲等专业术语之外,精准理解自然语言,让每个人都能享受创作音乐的乐趣。此外,针对AI音乐人声机械、词曲错位、听感嘈杂等痛点HappyShrimp在声音细节与音乐性上实现了一些突破。
HappyShrimp可以做到端到端整曲生成,把音乐理解成一种有语法、语义和上下文的特殊语言。对于用户提出的语言描述、歌词、曲风、情绪、年代及人声等要求,模型不是分头处理后拼接,而是整体规划、同步创作、兼顾长程结构,一体成型,生成完整歌曲。
不仅如此,HappyShrim将挑战“AI音乐工具通常擅于处理标准化音乐标签,却难以理解自然语言的文化语境、时代审美与情绪意图”这一局面。譬如,其能够听懂“Lo-fi R&B”等专业表达,也能理解情绪、场景与叙事。
8月17日起,HappyShrimp在国内及海外同步上线PC网页端。

-
商汤科技开源8B轻量多模态大模型:原生4K输出、全能视觉编辑
商汤科技正式宣布开源全新的轻量级、原生统一多模态大模型SenseNova U1.5Lite。作为一款参数量为8B 的轻量化模型,它在多项核心视觉任务中展现出了超越同量级模型的实力,甚至在部分复杂排版与文字渲染上达到了媲美超大规模商业模型的交付水平。
SenseNova U1.5Lite 原生支持3至4K的上下文长度,能够同时处理主体、数量、空间关系、文字、布局以及风格等多重约束,从而显著提升复杂视觉任务执行时的稳定性。
在具体功能特性方面,该模型带来了多项核心升级。首先是更高质量的视觉生成,显著改善了整体构图、色彩、材质、光影、真实感和局部细节,有效避免了传统模型常见的局部正确但整体完成度不足的问题。其次是更可靠的原生图像编辑能力,增强了对主体身份、空间结构、版式关系以及非编辑区域的保持度,同时全面提升了局部修改、元素替换、文字精修和多参考图编辑的综合表现。

-
小米新一代人形机器人惊艳亮相,大模型加持动作丝滑宛如真人
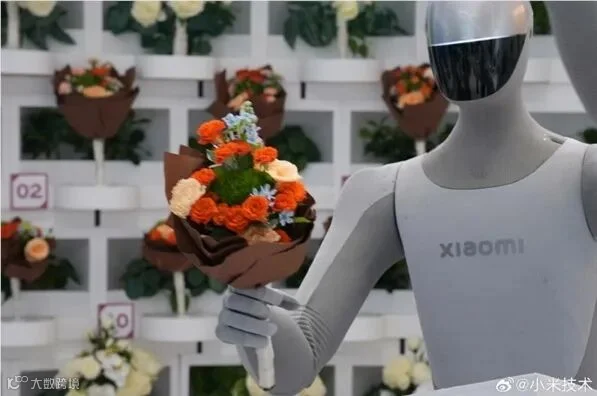
小米新一代人形机器人近日正式亮相2026世界机器人博览会,并登陆“具身花园”展台。在现场演示中,这款机器人化身优雅的“花艺师”,不仅能够流畅地完成抓取香片、撒花并递送给观众等精细动作,还支持握手、碰拳、比心等多元互动,整体表现自然流畅,摆脱了以往机器人的生硬感。
据官方介绍,这些看似生动的交互并非依靠单纯的预设程序机械执行,而是由强大的大模型驱动。机器人能够结合大模型对现场的复杂交互指令与实时场景进行深度理解、自主判断,从而独立完成各项操作。
在硬件规格方面,这款人形机器人身高约1.70米,体重约66公斤,全身拥有高达66个自由度。值得一提的是,其半数自由度均集中在手部,极大地提升了手部的精细操作和灵活性,使其能够胜任更多复杂的交互任务。
目前,该机器人仍处于样机阶段。在完成此次国内首展后,它还将前往欧洲进行巡展,向全球展示中国在具身智能领域的最新研发成果。
-
腾讯新一代大模型Hy4将发布,将成WorkBuddy核心引擎
继此前财报会议公开预告后,腾讯新一代大模型Hy4的内部测试界面近日正式曝光,这意味着其距离正式发布已为期不远。从泄露的模型选择界面来看,腾讯延续了“自研模型与集成优秀开源方案并行”的既定战略,共提供了三项核心选择:定位为专家级大模型的Hy4、标注为新升级且适用大部分场景的Hy3,以及专注于推理与理解的DeepSeek。
作为此次升级的焦点,Hy4的整体定位明显高于前代Hy3,被赋予了解决更复杂业务与技术难题的专家级能力。在技术演进路径上,行业普遍推测其性能的大幅提升可能源于两个方向:一是将参数规模直接迈向1万亿级别以追平行业旗舰水平;二是在现有Hy3架构基础上进一步深度强化RL(强化学习)后训练,从而在不盲目扩容参数的情况下显著增强核心智能上限。
回顾今年推出的Hy3大模型,其总参数量为295B(激活参数21B,MTP层参数3.8B),在软件开发、办公生产、金融建模、前端设计及游戏制作等高要求任务中表现亮眼。在内部组织的大规模专家真实工作盲测中,Hy3的综合表现甚至优于同类模型。随着定位更高、性能更强的Hy4即将登场,预计它将全面接棒成为智能体应用WorkBuddy的核心底层支撑,进一步释放腾讯在AI智能体落地与生产力场景中的应用潜力。

图源:网络
>>>>>>END<<<<<<
模达科技AI前沿,与您一起见证智能科技的蓬勃发展!
文章仅代表我司观点,请您甄别借鉴。


模达科技公众号
微信号 : modatechsub
扫码关注我们。