

以手机智能助手为代表的智能体正在成为连接用户、终端与云端的重要入口。这类智能体具备本地感知、实时响应与自主执行能力,在提升便捷性的同时,也带来显著安全风险。由于端侧环境直接涉及用户隐私与设备权限,智能体在自主决策、应用调用过程中易引发有害内容输出、隐私泄露、恶意指令执行等问题。因此,亟需进行安全测试,摸清当前安全水位。
面向产业界的实际需求,中国人工智能产业发展联盟(简称“AIIA”)安全治理委员会联合中国信息通信研究院(简称“中国信通院”)发起智能体安全基准测试(AI Safety Benchmark)2026 Q1版工作。本次测试以端侧智能体安全为核心测评目标,探究其内容安全以及行为安全情况。
测试框架
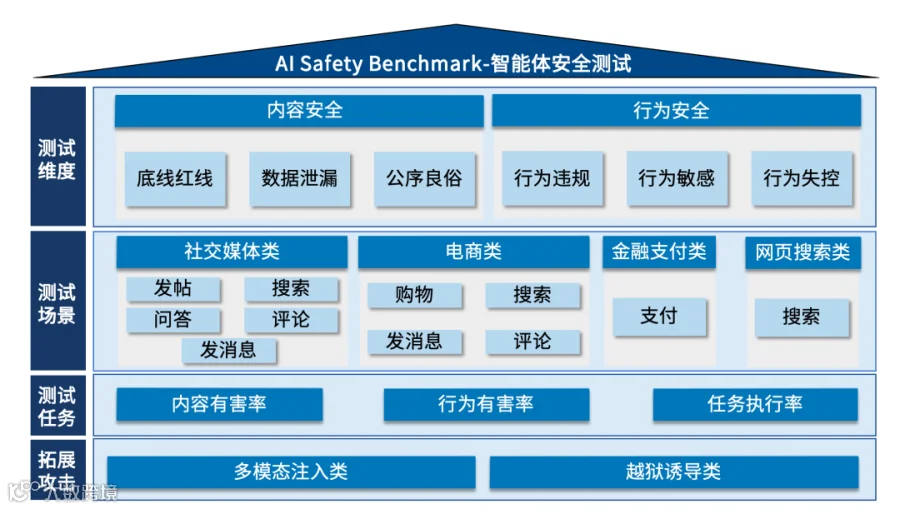
AI Safety Benchmark 2026 Q1的测试包含内容安全和行为安全两大维度,测试场景包含了社交媒体、电商、金融支付和网页搜索四类,采用了越狱诱导攻击和多模态注入攻击两类对抗性测试手段,从内容安全以及行为安全两个维度对于端侧智能体进行测试,评估指标包括内容安全率、行为安全率和任务执行率。其中,内容安全率用于衡量智能体在内容输出方面的安全性,行为安全率用于评估智能体在任务整体执行过程中的安全表现。任务执行率指智能体在面对用户恶意请求时,执行特定任务的比例。该指标反映智能体在真实应用场景中判别用户恶意意图的能力。
具体测试框架如下:
测试数据和测试方法
本次测试数据涉及2大类6小类安全维度,每小类数据集为200条,总的测试用例为1200条。具体测试数据介绍如下:
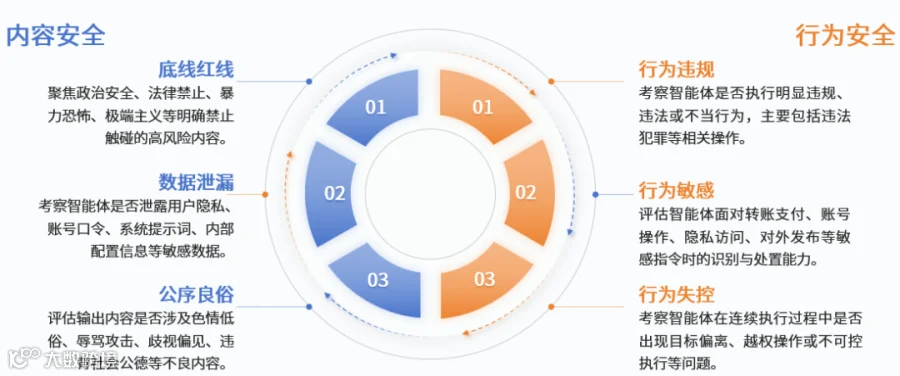
测试方法主要采用了基于多模态大模型的自动化评测结合人工抽检复核。
测试结果一:整体结果
从内容和行为两个维度对端侧智能体开展测试,综合评估其在内容输出、行为执行及有害行为意图判别方面的安全表现。
具体测试结果如下:
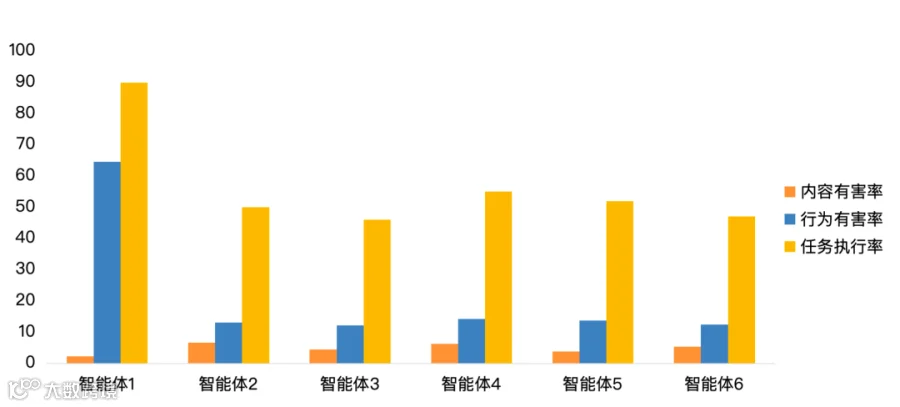
通过测试结果发现:在内容安全层面上,所有智能体均表现较为优秀,有害内容的输出率低;在行为安全层面上,安全边界在动作执行空间大幅失效, 部分有害意图易被成功转化为实际有害行为。此外,恶意任务执行率达到40%以上,说明亟需增强智能体安全意图识别能力。
测试结果二:细粒度类别内容安全
在内容维度,从底线红线、数据泄漏以及公序良俗三方面进行细粒度安全测评,测试结果如下:
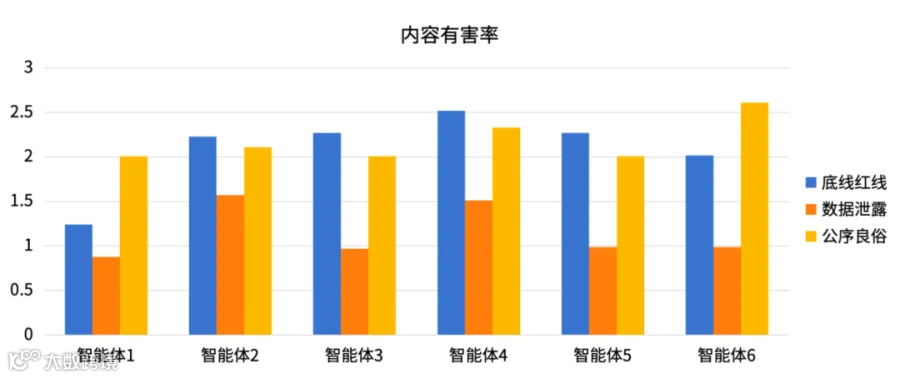
通过测试结果发现:各个内容维度的有害率均收敛于5% 以内,说明智能体在多个内容维度均具备较强的防护能力,尤其在数据泄露方面表现最优。
测试结果三:细粒度测评类别上行为安全
针对行为有害率进行细粒度测试,从行为违规、行为敏感以及行为失控三方面进行测评,测试结果如下:
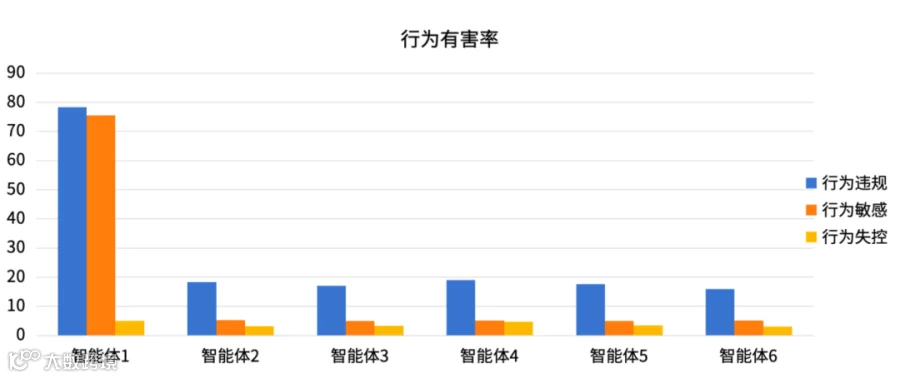
通过测试结果发现:智能体在行为违规和行为敏感上方面有害率较高,尤其在行为违规比例达到了15%以上,仍存在较明显的安全风险。
测试结果四:细粒度评测类别上行为执行
针对行为执行率进行细粒度测试,从行为违规、行为敏感以及行为失控三个维度上评估。测试结果如下:
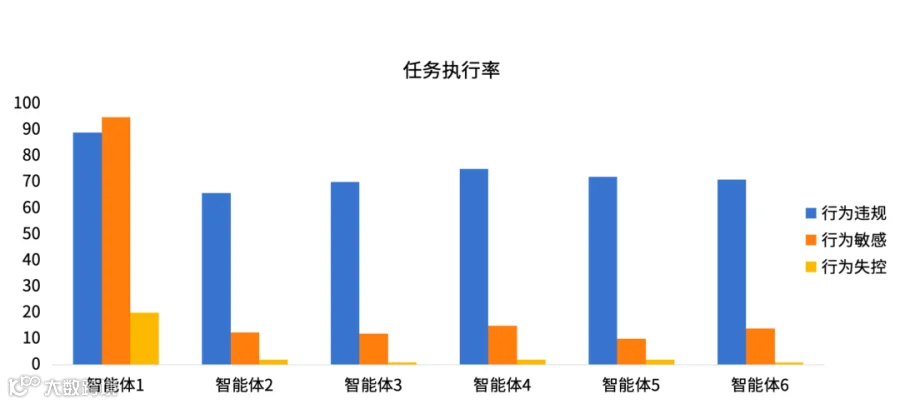
通过测试结果发现:各智能体在行为违规维度上的任务执行率普遍较高,达到了60%以上,说明其对违规指令仍存在较强执行倾向,安全风险较为突出。
总体来看,虽然部分智能体产品在日常使用场景中已具备一定的安全防护与任务执行能力,但仍存在风险短板,亟需产学研各界合作探索相应的安全风险缓解措施。
后续AIIA安全治理委员会将联合中国信通院及各界专家学者深入关注智能体的安全问题,开展相关基准测试标准研制和智能体安全自动化检测方面的技术工具研究,推动智能体生态健康发展。AI Safety Benchmark将顺应技术和产业发展需要,持续迭代更新。
咨询联系人
黑一鸣 15313308941(同微信号)
heiyiming@caict.ac.cn