大数跨境

强烈推荐!AI蛋白质设计,AI抗菌肽设计,合成生物学基因线路设计与CADD线上直播课程!

强烈推荐!AI蛋白质设计,AI抗菌肽设计,合成生物学基因线路设计与CADD线上直播课程! 生物信息与育种
2026-01-07
73


六大专题顶尖课程


01  AI蛋白质设计线上直播课

02  AI抗菌肽设计线上直播课

03  合成生物学与基因线路设计线上直播课

04  CADD计算机辅助药物设计线上直播课

05  AIDD人工智能药物发现与设计系统培训录播课

06  AIDD人工智能药物发现与设计进阶顶刊复现录播课

01

AI蛋白质设计线上直播课


2026最新最前沿蛋白质设计工具以及流程!让学员快速学会David baker核心方法!培训理论结合实操!提供服务器使用!通过详细讲解实操AlphaFold2、AlphaFold3以及pymol和Foldseek等软件让学员学会蛋白质结构预测!通过详细讲解实操ESM系列(ESM-1b、ESM-1v、ESM2、ESMC、ESM3)、GPT的生成模型ProGen让学员学会蛋白质大语言模型!通过详细讲解实操ProteinMPNN、LigandMPNN、ThermoMPNN、Rfdiffusion、ABACUS-R、RFdiffusion3等工具让学员学会多种蛋白质设计方法!六天培训流程循序渐进!知识点全覆盖!更是讲解十二篇Nature/Science/Cell/Jacs顶刊文献,让学员更好的知道当下蛋白质设计的核心热点以及优势!

一、蛋白质相关的深度学习简介
1.基础概念
1.1.机器学习简介:从手写数字识别到大语言模型
1.2.蛋白质结构预测与设计回顾
1.3.Linux简介
1.4.代码环境:VS code和Jupyter notebook*
1.5.Python关键概念介绍*
2.常用的分析/可视化蛋白质及相关分子的方法
2.1.常用数据库与同源序列搜索和MSA构建
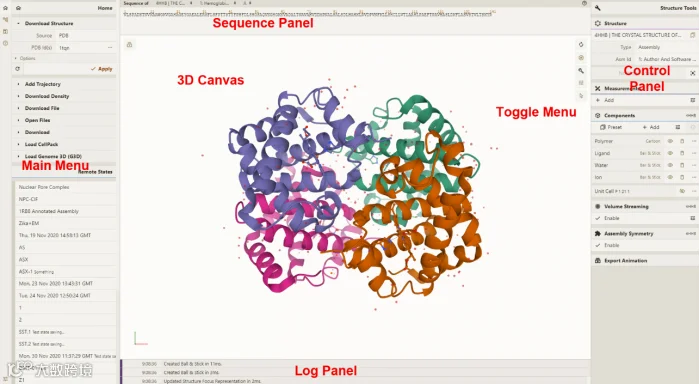
2.2.使用pymol和Mol*可视化蛋白质结构*
 2.3.使用biopython与biotite分析生物序列与结构数据*
2.4.使用fpocket与point-site分析蛋白质结构口袋*
3.深度学习蛋白质设计与传统蛋白质设计之间的差异
3.1.深度学习的本质
3.2.传统方法:全原子能量函数Rosetta与统计势
3.3.深度学习:几何深度学习
3.4.深度学习与传统的物理方法的互补性
3.5.深度学习蛋白质设计的优越性
4.蛋白质语言模型
4.1.语言模型:从RNN到Transformers
4.2.理解蛋白质语言
4.3.生成式蛋白质语言模型
4.4.结构模型与语言模型的比较分析
5.基于深度学习的蛋白质功能与性质预测
5.1.蛋白质功能分类预测*
5.2.信号肽、跨膜区、亚细胞定位预测
5.3.蛋白质同源结构搜索
5.4.酶活性位点预测
二、深度学习与蛋白质结构预测
1. 前深度学习时代的蛋白质(复合物)结构预测
1.1 基于同源性的建模:Swiss-Model,MODELLER,I-TASSER
1.2 基于折叠匹配的预测:Phyre2,RaptorX,HHpred
1.3 基于分子动力学的从头折叠:Rosetta ab initio,QUARK
1.4 蛋白小分子间的分子对接:AutoDock Vina
2. 深度学习方法用于蛋白质结构预测
2.1 RaptorX-Contact:将ResNet用于MSA
2.2 AlphaFold2:几乎解决了蛋白结构预测问题
 2.3 AlphaFold3:引入扩散模型
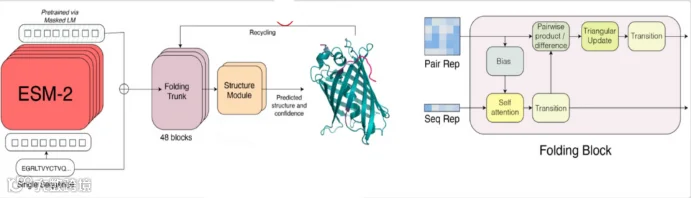
2.4 ESMFold:语言模型与结构预测的融合
3. AlphaFold2 原理回顾
3.1从共进化到结构
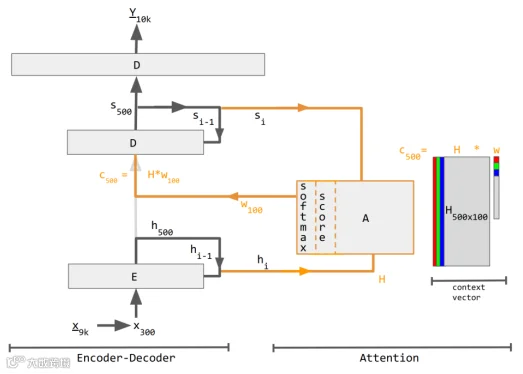
3.2注意力机制
3.3 EvoFormer
3.4 Structural Module
4. AlphaFold3 介绍
4.1 扩散模型
4.2 训练数据
4.3 AlphaFold3 的成绩与不足,与AF2的差异
4.4 AF3的竞争对手们:Chai-1&2,Boltz-1&2
5. AlphaFold2/3 实际操作与结果分析
5.1AlphaFold2&AF-multimer实操*
5.2AlphaFold2各指标介绍,结果分析*
5.3AlphaFold server使用*
5.4本地版的AlphaFold3*
5.5AlphaFold3结果分析*
6. ESMFold
6.1 ESM2:蛋白质语言模型能力的涌现
6.2从ESM2到ESMfold
6.3 ESMFold使用*
三、固定主链蛋白质序列设计
1.传统的蛋白质序列设计
1.1基于全原子力场的RosettaDesign*
1.2基于统计势的ABACUS
2融入结构知识的语言模型设计蛋白质序列
2.1ESM-IF原理介绍
2.2ESM-IF的应用*
3基于CNN的序列设计
3.1CNN原理简介
3.2DenseCPD设计方法
3.3有侧链构象的设计方法
4基于GNN设计序列
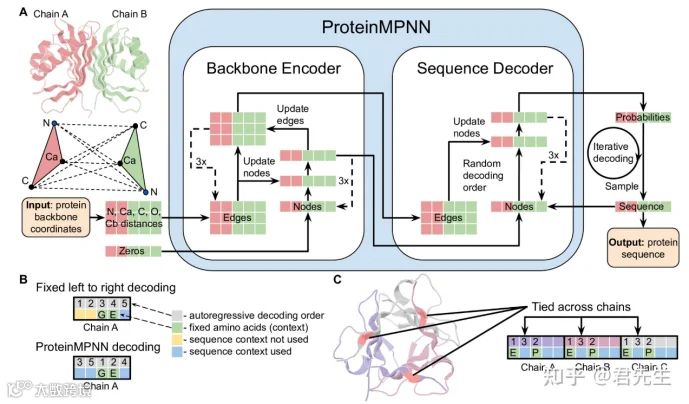
4.1ProteinMPNN 的成功经验分析
4.2ProteinMPNN 的广泛应用
 4.3ProteinMPNN 实际操作*
4.4ProteinMPNN的衍生模型:LigandMPNN,SolubleMPNN,ThermoMPNN
5其他的序列设计模型
5.1ABACUS-R 简介与实际操作*
5.2CarbonDesign 从结构预测来到序列设计去*
5.3CARBonAra 环境感知的序列设计*
6固定主链序列设计在功能蛋白设计中的应用
6.1新骨架蛋白质表达量优化(Science文章复现)*
6.2抗体亲和力优化(Science文章复现)*
6.3 结合进化信息的酶性质全方位优化(JACS文章复现)*
四、深度学习蛋白质结构设计
1.传统思路回顾
1.1.结构域拼接
1.2.SCUBA:无侧链的蛋白质力场
2.基于蛋白质表面几何深度学习的binder设计
2.1.masif原理简介
2.2.masif用于识别蛋白表面的PPI热点
2.3.masif设计binder
3.基于扩散模型的蛋白质骨架设计模型
 3.1.FrameDiff:基于IPA的主链生成*
3.2.Chroma:等变图神经网络结构设计
3.3.RFDiffusion:基于RosettaFold的多任务设计(以及RFantibody)
3.4.RFDiffusion2&3:从骨架设计到全原子设计
3.5.其他全原子蛋白设计模型简介(BindCraft/Boltzgen/HalluDesign)
4.基于RFdiffusion的蛋白设计案例介绍
4.1.抗蛇毒中和蛋白的从头设计(Nature-2025.1.15)
4.2.丝氨酸水解酶的计算设计(Science-2025.2.13)
4.3.靶向固有无序蛋白的结合蛋白设计(Nature-2025.7.30)
4.4.构象依赖的细胞因子结合蛋白设计(Nature-2025.8.13)
4.5.钙离子通道蛋白的计算设计(Nature-2025.10.22)
5.基于RFdiffusion3的功能蛋白设计
5.1.基本流程介绍(表位选取,可设计性评估,结构生成)
5.2.指定位点的结合蛋白设计
5.3.核酸结合蛋白设计
5.4.小分子结合蛋白设计
6.基于RFdiffusion和RFDiffusion3的酶设计
6.1.Theozyme理论解释
6.2.骨架生成策略
6.3.活性位点设计与活性进化
五、面向功能的蛋白质序列设计
1.语言的深度学习建模方法
1.1.Transformer
1.2.BERT: Bidirectional Encoder Representations from Transformers
1.3.GPT: Generative Pre-trained Transformers
2.蛋白质语言模型的代表:ESM
2.1.模型框架
2.2.ESM系列工作:ESM-1/2,MSA Transformer,ESM3
 2.3.ESM模型实际操作*
3.基于蛋白质语言模型的功能蛋白设计
3.1.预训练+微调的范式
3.2.条件式生成模型:Progen与ZymCTRL
3.3.Progen案例分析
3.4.上手微调ZymCTRL*
4.非自回归的序列生成模型
4.1.ProteinGAN:生成序列
4.2.DeepEvo:生成耐热酶
4.3.Prot-VAE
4.4.P450Diffusion:基于扩散模型设计功能P450*
5.功能蛋白生成后的评估指标
5.1.天然序列相似性评估*
5.2.多样性评估*
5.3.结构合理性评估*
六、基于深度学习的蛋白质挖掘与改造应用
1.酶学性质预测
1.1.DLKcat与GotEnzyme数据库介绍
1.2.UniKP:利用预训练模型挖掘、改造Kcat*
1.3.CLEAN:基于对比学习的EC号预测挖掘稀有脱卤酶*
2.蛋白质热稳定性改造
2.1.MutCompute介绍
2.2.利用MutCompute改造PETase(Nature)*
2.3.ThermoMPNN介绍与使用*
2.4.Pythia介绍与使用*
3.机器学习辅助定向进化/蛋白质工程
3.1.零样本突变效应预测原理
3.2.零样本改造基因编辑酶*
3.3.Low-N策略用于蛋白质工程
3.4.预训练模型的Evo-tuning*
3.5.ECNet介绍
3.6.蛋白质相互作用中的突变效应预测
4.针对自己的实验数据,训练自己的神经网络*
4.1.神经网络训练框架
4.2.数据收集、整理
4.3.特征提取方式
4.4.预训练模型的选取
4.5.模型训练、测试
4.6.新突变的预测
5.深度学习辅助的新酶挖掘*
5.1.基因编辑脱氨酶挖掘(Cell工作复现)
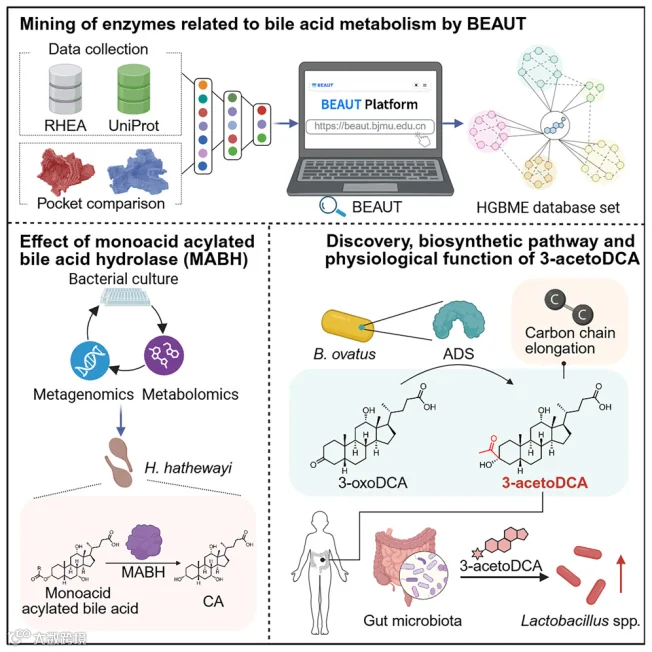
5.2.肠道微生物胆汁酸代谢酶的鉴定(Cell)
5.3.耐热塑料水解酶挖掘(Nature Communications)
5.4.使用FoldSeek进行基于结构的挖掘

02

AI抗菌肽设计线上直播课


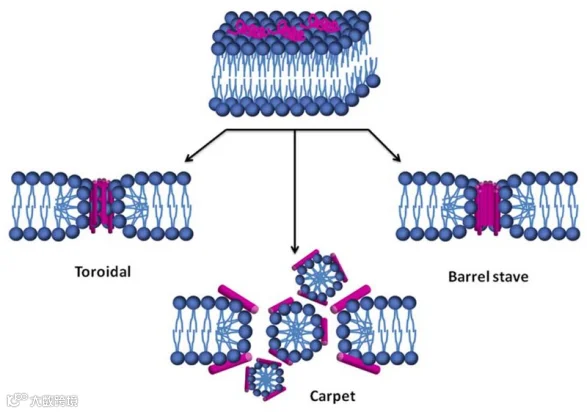
抗生素耐药性的发展速度已经远远超过了我们发现新型抗生素的能力。抗菌肽(Antimicrobial peptide,AMP)是一类天然存在于生物体内的小分子多肽(通常含 10-50 个氨基酸),具有广谱抗菌活性,可对抗细菌、真菌、病毒及寄生虫等病原体。作为宿主免疫防御系统的重要组成部分,其作用机制与传统抗生素不同,主要通过破坏病原体细胞膜或干扰其代谢过程发挥杀菌作用,是一类很有前景的抗生素替代品。生成式人工智能(generative artificial intelligence)为多肽的设计提供了一条强大途径,但这一过程仍充满挑战,原因在于巨大的序列空间、复杂的结构-活性关系以及需要在抗菌效力和低毒性(安全性)之间取得平衡。宾夕法尼亚大学和杜克大学的研究人员合作开发了一种基于蛋白质语言模型嵌入对抗菌肽(AMP)序列进行微调的潜在扩散模型——AMP-Diffusion,AMP-Diffusion 能够通过系统地探索序列空间来快速发现抗菌肽候选物,研究团队利用 AMP-Diffusion 生成并验证了多个候选抗菌肽,它们表现出广谱抗菌活性,包括对多重耐药菌株的活性,同时表现出低细胞毒性。本课程精准对标前沿,涵盖从 APD3/DRAMP 数据库挖掘到 AMP-Diffusion 模型部署、再到多维度计算评估(活性与毒性预测)的全链路实操


一、基础环境与抗菌肽入门
核心目标:为无相关编程与Linux基础的学员扫清环境障碍,并建立抗菌肽设计的理论基础。
抗菌肽基础理论
1.抗菌肽的重要性与应用前景:阐述多重耐药菌的严峻挑战,以及抗菌肽作为新型抗菌剂的独特优势(快速杀菌、不易产生耐药性)
2. 抗菌肽的定义、分类与作用机制:明确抗菌肽是生物体先天免疫产生的短肽,重点讲解以破坏细胞膜为主的作用机制,这是其设计的重要物理基础。
3.抗菌肽的理化特性:深入剖析决定其活性的关键参数:
两亲性:亲水与疏水残基在空间上的排列,影响其与细胞膜的相互作用。
净正电荷:通常为正值,使其能吸引带负电的细菌膜。
螺旋性:常见的二级结构,影响其插入膜的能力。
4.APD3数据库:介绍其基于活性的分类系统,如何根据目标微生物快速查找相关肽序列。
5.DRAMP数据库:强调其包含抗菌肽、抗癌肽、抗病毒肽的全面性,以及丰富的注释信息(如修改、构象)。
6.CAMP数据库:重点介绍其集成的在线预测工具,可作为后续模型结果的初步验证参考。
7.从天然到人工的设计原则:分析天然抗菌肽的结构特征,总结出人工设计所遵循的基本规则,如特定氨基酸组成比例、电荷范围等。
上机操作
1.Linux基础入门:针对生物背景学员,讲解必备命令。如使用cd、ls导航和查看目录;chmod管理文件权限;grep、pip进行文本搜索和包安装。
2.Conda及Jupyter Notebook安装与配置:演示如何用Conda创建独立的Python环境,避免包冲突。并配置Jupyter Notebook在此环境中运行。
3.Jupyter Notebook基础使用:指导学员创建第一个Notebook,混合使用Markdown撰写实验笔记和代码块执行Python命令,形成良好的可重复研究习惯。
二、Python编程基础与 AMP-Diffusion架构解读
核心目标:深入理解当前AI蛋白质设计的核心模型原理,并学会提取可用于下游任务的序列特征。
Transformer核心原理及在蛋白语言模型中的应用
1.注意力机制与Encoder Block:摒弃复杂数学,用“信息聚焦”的比喻讲解Self-Attention如何让序列的每个位置都能关注全局信息,这是理解一切现代蛋白模型的基础。
 2.序列建模基础:解释如何将氨基酸字母(如A, R, N)转化为数字向量(Token Embedding),并添加位置编码以保留序列顺序信息。
ESM-2模型介绍:阐述ESM-2作为一个基于Transformer架构、在海量蛋白质序列上训练而成的“蛋白质大语言模型”,其输出的Embedding(嵌入向量) 如何浓缩了该序列的结构与功能语义信息。
上机操作—Python编程基础
1.Python基础编程:快速掌握变量、列表/字典数据结构、for/while循环、if条件判断及函数定义,为后续脚本编写打下基础。
2.Python 进阶:学习导入os, pandas等模块;使用pandas的DataFrame高效管理序列数据表;掌握Biopython核心对象Seq和SeqRecord,用于读取、处理和写入FASTA等格式文件。
3.实战演练:
编写脚本,通过APD3的本地文件,自动检索具有特定长度和电荷范围的抗菌肽。
编写函数,将下载的多条序列从FASTA格式批量转换为包含序列名、序列字符串、长度等信息的CSV表格,便于后续分析。
4.环境配置:在Conda环境中安装pytorch和transformers库
5.提取ESM-2 Embedding:编写代码,加载预训练的ESM-2模型,输入一条示例抗菌肽序列,提取其最后一个隐藏层的所有氨基酸位点特征或池化后的整体序列特征。ESM-2 Embedding 打分与分析。
 6.Embedding打分与分析:演示如何计算不同抗菌肽序列Embedding之间的余弦相似度,以量化它们的“功能性相似度”;或使用PCA降维后可视化,观察活性肽与非活性肽在嵌入空间中的分布差异。
三、AMP-Diffusion模型实践与序列生成
核心目标:掌握扩散模型生成抗菌肽序列的全流程,并实现基于理化参数的可控设计。
抗菌肽扩散模型原理与应用
1.生成式模型基础对比:简要对比VAE、GAN和扩散模型在生成数据时的核心思想与优劣,突出扩散模型在生成质量和稳定性上的优势。
2.AMP-Diffusion架构详解:重点讲解“条件扩散过程”。解释模型如何在训练时学习从添加噪声的序列逐步去噪恢复为原始序列,并在生成时通过输入特定的条件向量(如目标电荷值、疏水性值)来引导去噪方向,从而生成符合要求的序列。
3.可控生成策略:详细说明如何将计算得到的净电荷、疏水性指数等具体标量参数,通过一个条件编码网络,融入模型的每一步生成过程中。
上机操作—从配置到生成
1.环境配置:根据提供的AMP-Diffusion项目README,安装特定版本的依赖库,配置模型路径。
2.加载模型与参数设置:学习加载预训练好的生成器和条件编码器,并理解关键参数如生成步数、噪声调度器的意义。
3.执行可控生成:编写循环,系统性地生成不同“电荷-疏水性”组合条件下的抗菌肽序列(例如,高电荷高疏水、高电荷低疏水等各100条)。
4.基础分析:对生成的数百条序列进行快速统计分析,绘制序列长度分布直方图,并验证其平均电荷和疏水性是否与设定条件相符,评估模型的可控性。
四、计算筛选、排序与设计验证
核心目标:建立多级计算评估流程,从海量生成序列中筛选出高活性、低毒性的候选者,并形成最终报告。
多维度计算评估体系
1.抗菌活性预测原理:介绍amp-scanner-v2等工具背后的深度学习模型(通常是CNN或Transformer),如何将序列Embedding映射为活性概率分数。
2.安全性评估方法:讲解ToxinPred和HemoFinder等工具的使用逻辑与置信度解读。
3.理化特性验证标准:建立多参数综合评价体系,明确活性分数、毒性概率、溶血概率、实际电荷/疏水性与设计目标的偏差等指标的权重,形成可量化的排序标准。
 上机操作
1.活性预测:对第四天生成的所有序列,调用amp-scanner-v2模型进行批量活性评分,筛选出高于阈值的序列。
2.安全性筛选:对上一步的活性候选序列,依次使用ToxinPred和HemoFinder进行毒性与溶血性预测,剔除高风险的序列。
3.多级筛选与排序:编写脚本,综合活性评分、毒性/溶血概率、与目标理化性质的契合度,计算一个综合优先级得分,并对所有通过初步筛选的序列进行排序。
4.最终报告生成:列出Top 20-50的候选序列,并包含其序列字符串、长度、预测活性分数、预测毒性概率、关键理化性质等完整信息,为后续的化学合成与湿实验验证提供明确指导。
五、AMP-Diffusion论文精解与实战复现
核心目标:基于Cell Biomaterials文章《Generative latent diffusion language modeling yields anti-infective synthetic peptides》的研究框架,完整复现其计算流程与实验验证逻辑,掌握从生成、筛选到验证的科研全流程。
AMP-Diffusion论文精读
1.文章研究逻辑总览:解读论文的整体研究路径:“生成(50,000序列)→ APEX活性预测 → 多样性筛选 → 实验合成与验证(46条)→ 体内外活性/毒性评估”。
2.生成与筛选策略解析:重点讲解文章中的三层筛选逻辑:
a)活性门槛:APEX预测平均MIC ≤ 64 μmol/L。
b)创新性保护:与已知AMP序列相似度 ≤ 60%。
c)多样性保障:候选肽间序列相似度≤ 40%,保留预测活性更优者。
3.研究启示与模型局限:讨论无条件扩散模型的局限,Classifier-Free Guidance 及 MDLM/DDPP 等下一代架构在提高靶向性与安全性方面的潜力。
 上机操作
1.环境配置与数据下载:根据论文提供的GitHub仓库链接,克隆AMP-Diffusion官方代码。从Mendeley Data下载论文中使用的训练数据集(Dataset S1)及生成的候选序列集(Dataset S2)。配置APEX预测器所需环境。
2.执行AMP-Diffusion批量序列生成:调用预训练的AMP-Diffusion模型,加载其EMA权重。设置生成参数(如步数、噪声调度),从高斯噪声开始生成指定数量的候选序列,模拟文章的大规模生成步骤。
3.APEX活性预测与初级筛选:编写脚本,调用APEX模型对生成的所有序列进行批量活性预测,得到针对11种病原体的预测MIC值。
4.序列相似性与多样性过滤:编写序列比对脚本,将筛选后的序列与已知AMP数据库(DRAMP/APD3)进行局部比对,计算序列相似性。
5.理化性质计算:使用DBAASP或本地化脚本,计算最终候选肽的疏水性、净电荷、两亲性指数等关键理化参数。

03

合成生物学与基因线路设计线上直播课


 具备两大独特且稀缺的优势:极为广谱的跨物种与跨领域实战经验: 与多数专注于单一系统的研究者不同,讲师的研究足迹横跨了从经典的原核生物(大肠杆菌),到基础的真核模型(酵母),再到复杂的哺乳动物细胞系统。其应用探索亦贯穿了从基础的合成群落到前沿的免疫应用,因此深刻理解基因线路在不同底盘和不同应用场景下的设计差异、挑战与优化策略。兼具国际视野与本土洞察的教学视角: 讲师对海内外合成生物学的教材体系均有深入研究与比较,这在国内相关教材尚处发展初期的大背景下尤为难得。结合多次参与国际前沿会议的交流经验,讲师能够提供一个既与国际前沿接轨,又深刻理解国内学员认知路径的独特教学框架。 本次课程的设计,将充分发挥讲师的上述优势。授课内容不仅是理论的传递,而是将权威教材的经典框架与顶刊文献的前沿拓展有机结合,并融入讲师在学术和产业界提炼的宝贵经验与心得。课程旨在帮助学员一站式地建立起将基因线路设计应用于解决真实科研与产业问题的强大能力。


一、工程师的思维——从“黑箱”到“电路图”
 目标: 我们将从合成生物学最激动人心的成果出发,通过经典的“生物学家修收音机”隐喻,引导您完成从传统生物学思维到工程学思维的“世界观”升级。您将学习合成生物学的基本设计语言,并掌握在动手设计前,如何利用系统生物学的视角勘探“地基”这一战略规划步骤。
理论模块:建立工程世界观
1.1: 导论:为什么我们需要一种新的思维?
1.1.1奇迹的展示: 领略合成生物学的标志性成果(如细胞工厂、智能疗法、生物材料),感受其重塑未来的巨大潜力。
1.1.2思想碰撞:"生物学家修收音机": 通过经典隐喻,理解系统生物学(Systems Biology,逆向工程)与合成生物学(Synthetic Biology,正向工程)的本质区别与紧密联系。
1.1.3核心方法论:DBTL循环: 掌握贯穿整个课程的核心工程流程——设计-构建-测试-学习(Design-Build-Test-Learn)。
1.2: 合成生物学的设计语言与原则
1.2.1设计的层级结构(Abstraction Hierarchy): 学习将复杂的生物系统,解构成元件(Parts)-> 装置(Devices)->系统(Systems)的模块化层次。
1.2.2标准化(Standardization):合成生物学的“语法”:
历史的基石:BioBrick标准及其对标准化思想的贡献。
现代的要求:定量表征(Quantitative Characterization)。了解经过精细表征的元件库如何实现设计的“可预测性”。
1.2.3拓扑结构入门(Topology): 初步了解反馈(Feedback)、前馈(Feed-forward)、逻辑门(Logic Gate)等基本线路“设计模式”。
1.3: 战略选择:细胞工厂的评估与侦察
1.3.1宏观比较:四大工业底盘: 系统性评估大肠杆菌、酿酒酵母、谷氨酸棒状杆菌、枯草芽孢杆菌的优缺点与适用场景。
1.3.2微观侦察:多组学数据的力量: 学习如何利用公开的蛋白质组学(Proteomics)和代谢组学(Metabolomics)数据,进行“战前侦察”,提前识别潜在的代谢瓶颈。
实操模块:您的第一个“生物APP”——番茄红素工程菌设计
本日实操目标: 以一个有趣、直观的案例——让大肠杆菌生产番茄红素(变红)——为线索,亲手完成一次微缩版的“Design”全过程,体验从想法到蓝图的喜悦。
2.1: 【实操】通路与元件的挖掘
2.1.1目标通路鉴定(Pathway Identification): 在KEGG数据库中,找到从E. coli内源前体FPP到番茄红素的3步异源通路及关键酶(CrtE, CrtB, CrtI)。
2.1.2元件序列挖掘(Part Mining): 在NCBI数据库中,找到这3个关键酶的编码序列(CDS)。
2.2: 【实操】“生物CAD”软件入门与表达盒设计
2.2.1设计软件入门(Benchling/SnapGene): 掌握导入序列、可视化质粒、注释元件等基本操作。
2.2.2 “纸上克隆”:构建基因表达盒(Device Construction):
引导练习: 在讲师引导下,为CrtE基因添加一个标准启动子(Promoter)和核糖体结合位点(RBS),构建一个完整的基因表达盒。
独立练习: 独立为CrtI基因设计一个表达盒。
模块 2.3: 【思考与设计】工程权衡的初体验
2.3.1设计挑战: “文献报道,CrtB基因过表达有毒。请从iGEM元件库的J23100系列中,选择一个中等或较弱强度的启动子,并阐述您的设计理由。”
2.3.2方案讨论: 小组讨论或自由发言,分享自己的设计思路,初步体验工程设计中的核心——权衡(Trade-off)。
二、工程师的工具箱——从蓝图到物理现实
目标: 将第一天设计的“纸上蓝图”转化为可供测试的物理实体。您将深入掌握现代合成生物学的核心构建技术,并学会如何对自己的“作品”进行严谨的质量检验,为后续的计算模拟和优化打下坚实基础。
设计&构建模块:DNA组装与基因组改造
3.1多基因表达系统的设计原理
3.1.1原核生物中的共表达策略:
操纵子(Operon)设计: 学习如何将多个基因串联在一个启动子后,并通过精确设计RBS强度和基因顺序,来实现不同蛋白的化学计量比调控。
多启动子策略: 探讨在一个质粒上使用多个正交启动子的优势与挑战(如质粒不稳定性、资源竞争)。
3.1.2真核生物(酵母)中的共表达策略:
独立表达盒串联: 理解真核与原核共表达的策略差异。
多顺反子策略: 了解IRES(内部核糖体进入位点)和2A自剪切肽等高级工具,如何在一个mRNA上实现多个蛋白的表达。
3.1.3代谢工程考量: 讨论质粒拷贝数(Copy Number)的选择等,如何通过这些策略来平衡代谢负荷。
模块 3.2: DNA的乐高:模块化组装技术
3.2.1主流组装方法: 深入理解Golden Gate、Gibson Assembly等方法的原理,并学会如何选择最合适的方法来拼接您在第一天设计好的基因表达盒。
3.2.2大片段DNA操作: 了解在处理超长基因簇(>50kb)时所需的高级克隆与组装策略(如TAR cloning)。
3.2.5【实操演示】多片段组装: 讲师将现场演示,如何在设计软件中,将第一天设计的三个番茄红素基因表达盒,通过Golden Gate组装到一个载体上。
3.3: 基因组的外科手术:CRISPR/Cas系统
3.3.1核心系统原理: 掌握Cas9与Cas12的工作原理差异及其应用选择。
简要介绍MAGE(Multiplex Automated Genome Engineering)如何实现大规模、多位点的基因组快速编辑。
3.3.2挑战:探讨为何需要同时敲除多个基因(如去除多个竞争性旁路),是否有可替代的方法?
3.3.3基于CRISPR的解决方案(以大肠杆菌为例):
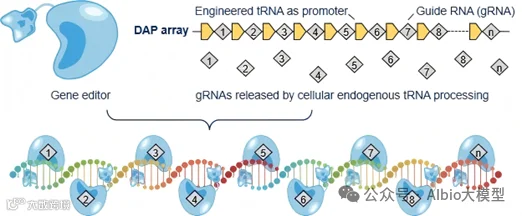
多gRNA表达阵列: 理解细菌宿主对于入侵噬菌体病原体的天然防御机制。学习如何在一个质粒上,通过阵列化的启动子和tRNA/Csy4切割位点,同时表达多个gRNA。
3.3.4 【实操演示】gRNA设计与应用: 学习如何设计gRNA,以实现精准敲除(例如,去除第一天通过系统分析发现的竞争通路)与精准插入。讲师将现场演示gRNA的设计过程。
测试与验证模块:眼见为实
4.1: 加速迭代:快速验证技术
4.1.1什么是无细胞系统:了解其作为“试管中的转录-翻译机器”的基本构成(细胞裂解液、能量缓冲液、DNA模板)。
4.1.2为什么是“加速器”:
领读 Jeung et al. (2025): 学习CFS如何通过绕过细胞转化和培养,将DBTL循环从“数周”缩短至“数天甚至数小时”。
开放与可控: 理解CFS作为一个开放系统,允许我们精确调控反应组分(如辅因子、底物浓度),从而轻松找到最优条件。
4.1.3 CFS在代谢工程中的五大“杀手级”应用
应用一:元件与线路的原型测试: 快速筛选启动子/RBS文库,或验证一个基因开关的逻辑功能。
应用二:多酶途径的快速优化: 通过直接调整不同酶的DNA模板浓度,快速找到整条通路的最佳酶表达比例,避免了体内繁琐的组合构建。
应用三:毒性蛋白/产物的表达与研究: 在不影响“细胞存活”的情况下,生产对细胞有毒的蛋白质或化学品。
应用四:非模式生物的元件开发: 从难以进行遗传操作的“奇异”菌株中制备CFS,为其开发定制化的启动子和RBS。
应用五:与高通量筛选的结合: 了解CFS如何与微流控液滴结合,实现对百万级酶突变体的超高通量筛选。
4.1.4设计挑战:“回到第一天的番茄红素案例。三个基因(CrtE, CrtB, CrtI)的表达量比例对最终产量至关重要,但我们不知道最佳比例是什么。如果用传统方法在细胞内逐一尝试所有组合,可能需要数月时间。我们如何利用无细胞系统,在一天之内找到这个最佳比例?”
4.1.5您的任务:设计一份高通量优化实验方案。
方案设计: 以小组或个人形式,设计一份详细的虚拟实验方案。您需要思考:如何制备DNA模板?如何设置反应体系?如何进行高通量筛选?如何分析数据?
方案讨论:分享您的设计,讲师将结合前沿文献,点评并展示一个工业级的、利用CFS和自动化平台进行通路优化的标准工作流程。
4.2: 质量控制:从序列到功能
4.2.1 Sanger vs. NGS vs. TGS:测序技术: 对比三种测序技术在验证构建、筛选突变体、组装基因组等场景中的应用。了解PacBio/ONT如何轻松快速帮助我们验证大片段组装和复杂基因组区域的结构准确性。
4.2.2【思考与讨论】蛋白功能验证:
基础技术: 学习SDS-PAGE与Western Blot如何“看见”蛋白质的表达。
思维拓展: 深入讨论当敲除一个未知基因后,“无表型”怎么办?学习合成致死、高通量表型分析等高级策略,培养面对复杂问题的坚韧和创造力。
三、工程师的诊断与调优
目标: 工程很少一次成功。这一天,您将扮演一名“诊断工程师”,学习如何解读复杂的实验数据,找出系统瓶颈。我们将以合成生物学史上最经典的代谢工程案例为蓝本,复盘顶尖科学家的思考过程,看他们如何从失败中学习,并提出系统级的优化策略。
案例精读(一):从失败数据中学习
5.1: 性能的终极检验:代谢物检测
5.1.1核心技术解读: 通过“机场安检”的比喻,轻松理解LC-MS/HPLC的工作原理。
5.1.2数据解读入门: 学习如何从真实的色谱图中,通过保留时间进行“定性”,通过峰面积进行“定量”。
5.2: 根本原因分析:紫穗槐二烯的“第一次失败”
5.2.1文献精读: 领读Martin et al. (2003) *Nat. Biotechnol.*,分析科学家为何在初始设计中遭遇“惨败”。
5.2.2思维复现: 学习他们是如何通过严谨的实验推理,精准定位到“前体供应不足”这一核心瓶颈。
案例精读(二):系统优化与实战设计
6.1: 系统优化策略:推-拉-阻断(Push-Pull-Block)
6.1.1策略精讲与案例解析: 深入理解Block(阻断)、Push(推动)、Pull(拉动)三大策略,并结合Ro et al. (2006) *Nature*(青蒿素案例)进行分析。
6.1.2终极策略与战略考量: 学习“旁路设计”的革命性思想,并理解底盘生物的特性如何影响最终的技术选择。
模块 6.2: 【思考与设计】您的第一个优化方案
6.2.1新挑战:黑色素生产。 面对一个全新的、产量低下的生产案例及其模拟实验数据。
6.2.2方案设计与“解惑”:
您的任务: 运用今天所学,为这个新案例设计一套包含前体供应和辅因子平衡两个层面的优化方案。
“解惑”时刻: 讲师将揭示真实世界中科学家们发表的解决方案,与您的设计进行对比和印证,带来“原来如此”的顿悟。
四、智能设计——从静态优化到动态调控
目标:将您的设计思维从“静态”提升到“动态”,为细胞安装“智能大脑”。您将学习如何设计和构建动态基因线路,使其能自主响应内外部信号,解决持续高表达带来的代谢负担与毒性问题。我们将深入拆解领域内的前沿综述,并首次引入定量模拟,让您亲手“调试”基因线路的动态行为。
理论模块:动态调控的设计原理
7.1: 静态优化的困境与动态调控的必要性
7.1.1核心痛点:分析代谢负担(Metabolic Burden)与中间产物毒性(Intermediate Toxicity)。
7.1.2初级解决方案:“手动开关”: 学习化学诱导系统(IPTG/aTc)与物理诱导系统(光遗传学)的原理与应用。
模块 7.2: 智能线路的设计原理与核心元件
7.2.1核心元件:生物传感器(Biosensor): 深入理解基于变构转录因子(aTF)的传感器的工作机制。
7.2.2【新增】定量的语言:RBS强度与表达水平:
RBS计算器入门: 了解如何使用在线的RBS Calculator来预测和设计不同翻译强度的元件。
7.2.3时间特性:响应动力学:了解蛋白降解标签(Degron)如何加速线路的关闭时间,实现快速的动态响应。
7.3: 【文献精读】动态调控的前沿工具箱
7.3.1文献领读: 深入拆解细胞信号处理电路分类以及不同层级的信号处理信号发生器,信号转换器,信号滤波器,模拟生物运算,布尔逻辑,多值逻辑,可逆逻辑,记忆,人工神经网络,遗传控制器;DNA水平信号处理,转录因子、重组酶、质粒拷贝数;RNA水平信号处理,核糖调节因子、核糖开关与核酶、RNA结合蛋白、可编程的RNA靶向系统;蛋白水平信号处理,蛋白结合、蛋白水解、蛋白剪切、蛋白磷酸调节;多级信号处理
设计与实操模块:构建你的第一个“生物开关”
实操目标:以合成生物学最经典的“拨动开关”(Genetic Toggle Switch)为案例,从理论设计到定量模拟,完整地走一遍动态线路的设计流程。
8.1: 设计范式精讲:反馈、前馈与逻辑门
8.1.1负反馈(NFL)与正反馈(PFL): 学习NFL如何实现稳态,PFL如何产生双稳态(Bistability)和“全或无”的开关效应。
8.1.2前馈环(FFL): 学习cFFL作为“信号持续性检测器”和iFFL作为“脉冲发生器”的原理。
8.1.3基本逻辑门(Logic Gates): 系统性学习AND, OR, NOT, NOR, NAND的分子实现方式。
8.2: 【实操设计】Toggle Switch解构与设计
8.2.1案例解构: 详细拆解经典的Gardner & Collins Toggle Switch。理解它本质上是一个由两个NOT门(两个相互抑制的阻遏蛋白LacI和TetR)构成的正反馈环。
8.2.2你的设计任务:
在Benchling中,根据论文图示,亲手画出Toggle Switch的质粒图谱。
思考:如何通过外部信号(IPTG和aTc)来“拨动”这个开关,使其在两个稳定状态(高LacI/低TetR vs. 低LacI/高TetR)之间切换?
五、计算驱动的设计——从基因组到蛋白质
目标: 为您的“工程师工具箱”装上最强大的“数字引擎”。您将系统性地学习如何利用计算工具,在实验开始前就预测、模拟和优化您的生物设计。我们将跨越从基因组宏观尺度到单个基因线路微观动态的多个层面,并首次引入AI工具,让您体验数据驱动的元件挖掘与蛋白质工程。
宏观与微观建模:预测细胞的行为
9.1: 基因组尺度的“城市规划”:通量平衡分析(FBA)
9.1.1核心思想: 了解全基因组代谢模型(GEMs)如何将一个细胞的所有代谢反应抽象为一张巨大的“城市交通网络图”。
9.1.2 FBA入门: 学习通量平衡分析(FBA)如何在这张网络上,通过求解一个优化问题,来预测在特定基因敲除或营养条件下,细胞的生长速率和目标产物的最大理论产量。
9.1.3【实操演示】预测基因敲除靶点: 讲师将使用COBRApy工具,以大肠杆菌或酵母的全基因组模型为例,现场演示:
如何模拟一个基因的敲除。
如何观察敲除后,代谢流(Flux)如何在网络中重新分配。
如何利用FBA,为第三天黑色素案例中的L-酪氨酸生产,找到能提高产量的最佳基因敲除靶点。
9.2: 基因线路的“实时导航”:常微分方程(ODE)建模
9.2.1核心思想: 理解FBA(稳态)与ODE(动态)两种模型的根本区别与适用场景(“城市规划图” vs. “实时GPS导航”)。
9.2.2 ODE入门: 学习如何用简单的常微分方程(如`d[P]/dt = 合成速率 - 降解速率`)来描述一个基因的表达动态。
9.2.3【实操模拟】调试动态线路:
任务: 回到第四天的Toggle Switch案例。我们将提供一个预设好的ODE模型代码(Python/Colab)。
您的挑战: 通过修改代码中的参数(如启动子强度、降解速率),亲手模拟并重现昨天在线模拟器中观察到的现象,并进一步探索“参数敏感性”,即哪个参数对开关的性能影响最大。
计算驱动的元件挖掘与蛋白质工程
10.1: AI赋能的元件挖掘
10.1.1传统方法的局限: 讨论手动在数据库中挖掘元件的低效与不确定性。
10.1.2计算方法结合:
启动子设计: 了解如何利用机器学习模型,根据DNA序列预测启动子强度。
RBS设计: 学习使用RBS Calculator等工具,通过热力学模型,为特定CDS序列反向设计出具有目标翻译强度的RBS序列。
10.1.3【实操演示】设计一个可预测的RBS: 讲师将现场演示,如何使用RBS Calculator,为第一天番茄红素案例的CrtE基因,设计一个预测强度为50000 a.u.的RBS序列。
10.2: 走向自动化的通路设计与酶工程
10.2.1 AI驱动的代谢通路挖掘: 了解RetroPath、Selenzyme等工具如何利用逆合成分析和酶学数据库,自动为目标分子推荐多条可能的生物合成路径。
10.2.2蛋白质工程与设计软件入门:
原理: 了解理性设计(Rational Design)与定向进化(Directed Evolution)的基本策略。
软件操作: 学习使用PyMOL等分子可视化软件,观察蛋白质的三维结构,找到关键的活性位点。
10.2.3【实操演示】蛋白质结构的“第一眼”:
任务:以黑色素案例中的酪氨酸酶为例或其他示例。
讲师演示:如何从PDB数据库下载其蛋白质结构文件,导入PyMOL,找到并高亮其活性中心的两个关键铜离子,让学员直观理解为何它对辅因子如此依赖。

04

CADD计算机辅助药物设计线上直播课


主讲老师的教学风格注重理论与实践结合,通过真实科研案例帮助学员深入理解CADD的核心原理与操作流程。从分子建模、配体筛选到模拟结果分析与可视化,均能以浅显易懂、系统完整的方式进行讲解。凭借丰富的一线科研经验与项目实操能力,袁老师致力于帮助学员全面掌握计算机辅助药物设计的思维方法与技术体系,真正做到“理解原理、掌握方法、学以致用”。


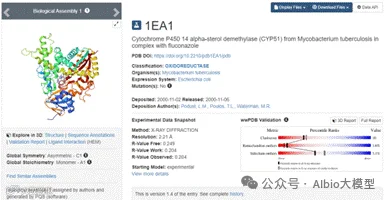
一、pymol的使用与一般蛋白-配体分子对接
1.PDB蛋白结构数据库的介绍和使用
1.1数据库简介
1.2靶点蛋白的结构查询与选取
1.3靶点蛋白的结构序列下载
1.4靶点蛋白的下载与预处理
1.5批量下载蛋白晶体结构
2.pubchem数据库的介绍和使用
2.2 小分子化合物的检索方法2.3 化合物结构与性质信息获取2.4 化合物3D结构下载与格式转换
2.5 批量下载与数据管理
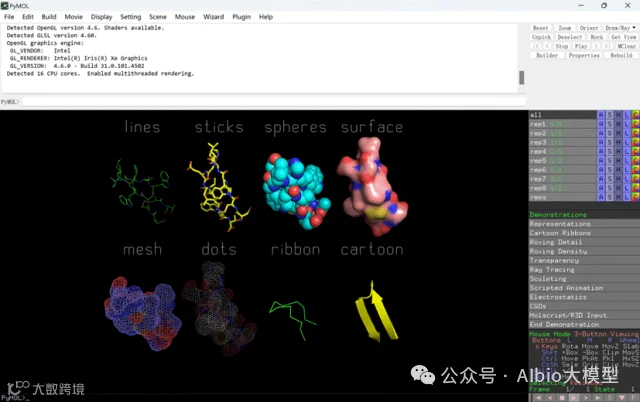
3.Pymol的介绍与使用
2.1软件安装基本操作及基本知识介绍
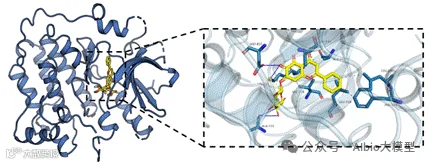
2.2蛋白质-配体相互作用图解
2.3蛋白-配体小分子表面图、静电势表示
2.4蛋白-配体结构叠加与比对
2.5绘制相互作用力
一般的蛋白-配体分子对接讲解
1.对接的相关理论介绍
1.1分子对接的概念及基本原理
1.2分子对接的基本方法
1.3分子对接的常用软件
1.4分子对接的一般流程
2.常规的蛋白-配体对接
2.1收集受体与配体分子
2.2复合体预构象的处理
2.3准备受体、配体分子
2.4蛋白-配体对接
2.5对接结果的分析
以人血清白蛋白(Human Serum Albumin)与一个简单配体咖啡因(Caffeine)为例
二、虚拟筛选的介绍与实际操作
1.虚拟筛选相关程序的介绍
1.1openbabel的介绍和使用
1.2ADFR介绍与使用
1.3chemdraw的介绍与使用
2.虚拟筛选的前处理
3.使用Pymol getbox插件确定蛋白口袋
4.虚拟筛选的流程及实战演示案例:细胞色素 P450 14Alpha-固醇脱甲基酶与ZINC FDA药物虚拟筛选
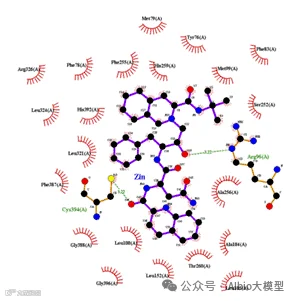
5.Pymol、PLIP、Ligplus+结果分析与作图
5.药物ADMET预测
5.1ADME概念介绍
5.2预测相关网站及软件介绍(SWISSADME、ADMTCADD)
5.3预测结果的分析
三、多类型分子对接理论与实战应用
1.蛋白-蛋白对接
1.1蛋白-蛋白对接的应用场景
1.2相关程序的介绍如 ZDOCK HDOCK Alphafold3
1.3目标蛋白的收集以及预处理
1.4使用算例进行运算
1.5关键残基的预设
1.6结果的获取与文件类型
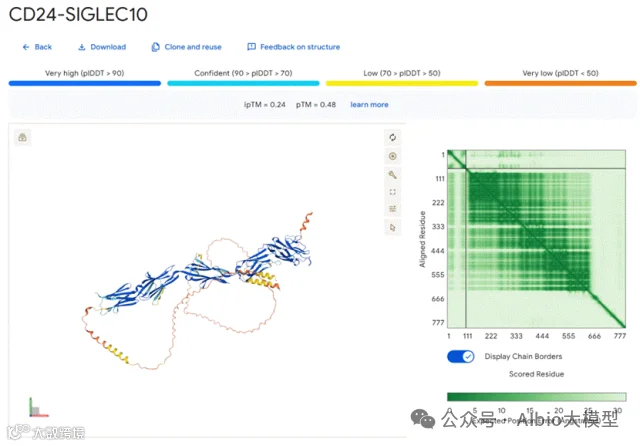
1.7对接实操:以人类热稳定蛋白CD24和SIGLEC10对接分析以及作图。
2.蛋白-金属离子的对接
2.1蛋白-金属离子对接的应用场景
2.2相关程序的介绍如 Alphafold3 MIB2 IonCom
2.3对接实操:以AARS2与金属二价Cu离子做对接分析以及作图。
3.蛋白-DNA/RNA的对接
3.1蛋白-DNA/RNA的对接的应用场景
3.2相关程序的介绍如 Alphafold3 Hdock chCADD-1
2.3对接实操:LacI 抑制蛋白与DNA做对接分析以及作图。
4.蛋白-多配体的对接
4.1蛋白与多个小分子配体对接的应用场景
4.2对接实操:人源磷酸二酯酶 9A(PDE9A)与两个小分子抑制剂的复合物对接结果分析以及作图。
四、蛋白-蛋白相互作用预测与结构分析实战
【声明】内容源于网络
0
0
生物信息与育种
致力将生信、AI、大数据、云计算等技术应用于现代生物育种
内容 1167
粉丝 0
生物信息与育种 致力将生信、AI、大数据、云计算等技术应用于现代生物育种
总阅读5.7k
粉丝0
内容1.2k