


在前期教程中,我们学习了将Screaming Frog审计数据导出并交由AI进行优先级排序。然而,手动导出CSV、GSC数据并合并分析的流程较为繁琐。Screaming Frog付费版的核心优势在于:爬取时自动拉取GSC/GA4流量数据、自动构建内链图谱、自动执行语义分析。原本需要5步的操作,现在1步即可完成。
获取数据后,面对海量数据往往让人无从下手。本文将重点讲解数据导出、AI分析及获取可执行修复方案的实战流程。
功能1:连接GSC/GA4 API与AI分析
相比手动导出,付费版可在Configuration(配置)> API Access(API访问)中连接Google账号,爬取时自动关联URL的GSC数据(点击数、展示次数、CTR、平均排名)和GA4数据(会话数、转化事件)。
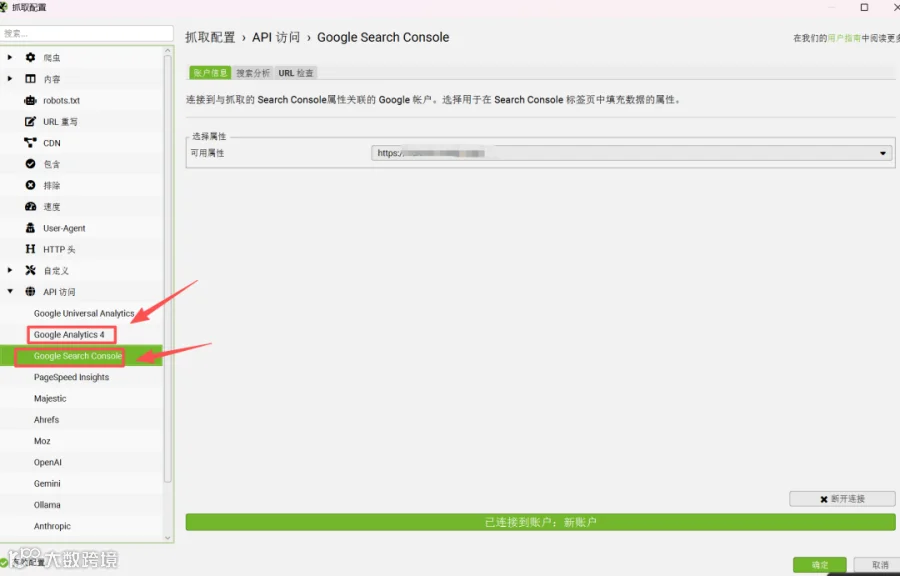
核心在于分析思路。具体操作流程如下:
1. 爬取完成后,在左侧选择 Internal(站内)标签页,过滤 HTML。

2. 点击顶部菜单 Export(导出),导出CSV(该文件已自动包含GSC/GA4字段)。
3. 将CSV上传至ChatGPT,使用以下提示词:
我上传了Screaming Frog爬取的网站数据(已关联GSC流量数据)。请识别CSV列名并确认GSC字段后,执行以下分析:
- 找出「展示次数>500但CTR低于2%」的页面(有曝光无点击),列出当前Title并提供改写建议。
- 找出「排名11-20位且存在技术问题(如Title缺失/重复、H1缺失)」的页面,修复后有望提升排名。
- 找出「返回404但有展示/点击」的页面,需紧急设置301重定向以挽回流量。
- 找出「爬取深度>3层且月展示>100」的页面,需通过首页或导航补充内链。
请根据ROI由高到低排序,输出「本周Top 5必修清单」。
此提示词的核心逻辑是:用流量数据为技术问题定价。例如,月展示2400的产品页与月展示15的旧博客相比,前者的Title缺失问题显然具有更高的修复优先级。
功能2:语义分析定位重复内容并导出AI处理
这是v22版本新增的核心功能,也是SF的差异化优势。SF利用AI为每个页面生成“语义指纹”(Embedding向量),通过数学计算评估页面间的相似度。相较于传统文本比对,向量计算能更精准地识别语义相近的内容。
对外贸站而言,此功能尤为关键。若工业阀门站的球阀、蝶阀、闸阀页面描述高度同质化,Google可能判定为关键词蚕食,导致页面互相竞争排名。SF可快速识别此类语义重复问题,避免数十个产品页需人工逐一排查的低效。
完整操作流程:
1. 配置AI:Configuration(配置)> API Access > AI > 连接Gemini(或其他大模型)。

2. 提示词配置:Prompt Configuration > Add from Library > 选择 "Extract Semantic Embeddings from Page"。
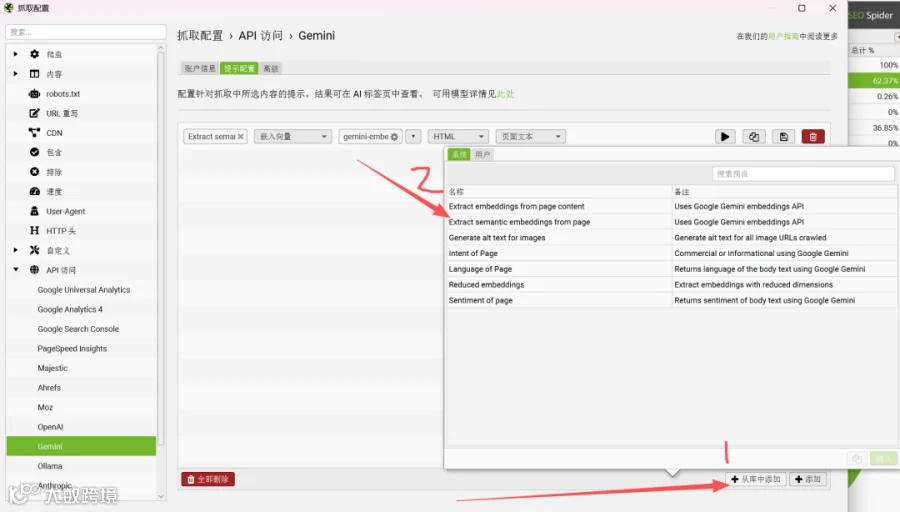
3. 爬虫提取:Configuration > Spider > Extraction > 勾选 Store HTML。

4. 内容向量:Configuration > Content > Embeddings > 勾选 Enable Embedding 与 Enable Semantic Similarity。
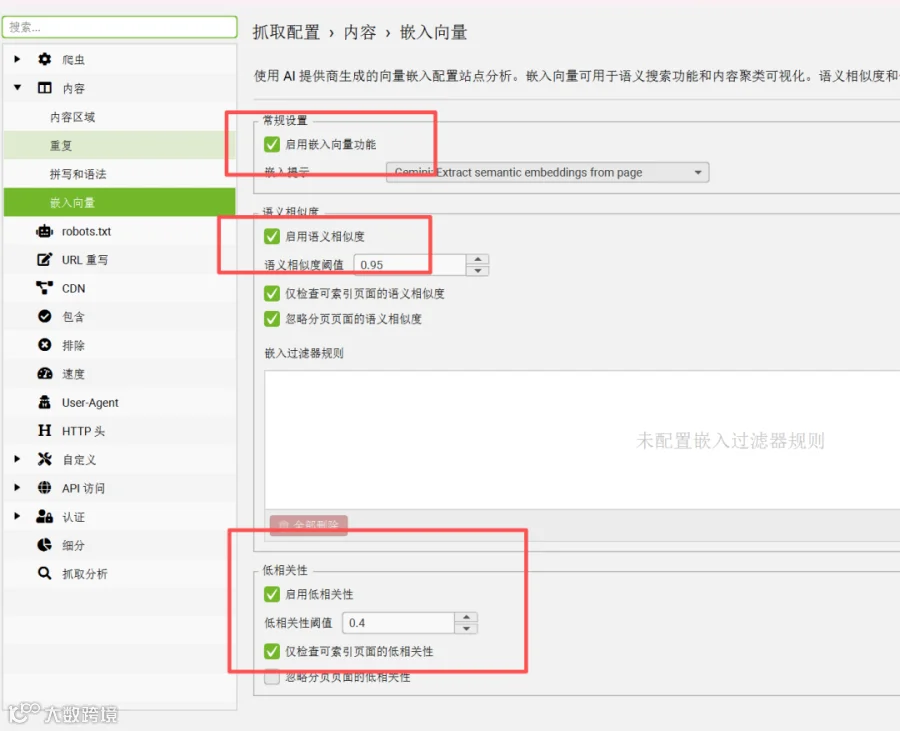
5. 运行爬取后,进入 Crawl Analysis > 点击 Start。

6. 关键步骤:导出相似页面列表。点击 Content 标签页,右侧下拉选择「语义相似」,导出CSV。

7. 将CSV上传至ChatGPT进行分析:
我上传了Screaming Frog导出的「语义相近页面列表」(含两URL及相似度分数)。请执行以下分析:
1. 按相似度降序,列出所有相似度>80%的页面对。
2. 针对每对页面给出操作建议:主题相同建议合并(301重定向,保留高流量页);不同产品但描述雷同建议差异化(提炼独特卖点)。
3. 提供合并或差异化后的内链调整建议。
请以表格形式输出:| 页面A | 页面B | 相似度 | 建议操作 | 具体方案 |
功能3:内链图谱挖掘权重传递机会
SF爬取后可自动生成全站图谱,核心在于将数据导出并交由AI生成结构化方案。
操作流程:
1. 爬取完成后,点击任意URL,通过右侧面板 Inlinks(入链)/ Outlinks(出链)查看单页面内链情况。
2. 批量导出内链:顶部菜单 Bulk Export > Links > All Inlinks,导出CSV。
3. 将导出的内链CSV与功能1的流量数据CSV同时上传至ChatGPT:
我上传了2份数据:inlinks.csv(全站入链关系)与 internal_with_gsc.csv(技术+流量数据)。请进行内链分析:
1. 找出「孤儿页」(0入链):若有流量,需补充内链以提升排名。
2. 找出「排名11-20位但入链<3条」的页面:列出建议添加内链的相关来源页面。
3. 找出「高展示(>1000)但出链<2条」的页面:权重未充分传递,建议添加出链至需提升的页面。
4. 审计锚文本:识别“点击这里”等无效锚文本,并提供优化建议。
请按预期效果降序输出修复清单。
核心价值的体现:不在于界面逐一排查,而是通过批量导出→AI分析→获取结构化修复方案,实现内链优化的规模化与自动化。
功能4:项目保存、自动对比与重定向检测
付费版提供三项提升效率的实用功能:
保存项目:免费版关闭软件即丢失数据。付费版支持通过 File > Save 保存项目(v24.3支持自动保存),下次可直接加载历史数据继续分析。
自动对比爬取(v24新增):设置周期自动运行,系统会自动对比新旧结果,标记新增404、Title变更及新发现页面,异常情况通过邮件通知,相当于全天候技术SEO巡检。
重定向链检测:频繁的301重定向易导致A→B→C的链式跳转,增加抓取延迟并导致权重衰减。在 Reports > Redirects > Redirect Chains 中可一键排查。修复时,需在后台将多重跳转优化为直达目标页的一步跳转。
整合分析结果,输出最终行动计划
完成上述三项功能后,会获得多份AI分析清单。为消除重叠并明确优先级,需进行最终整合:
我上传了3份AI分析结果:①技术问题+流量优先级Top 5清单;②语义相近页面合并/差异化方案;③内链修复清单。
请执行以下操作:
1. 去重合并:若同一URL在多处出现,整合为单条并汇总所有操作。
2. 重新排序:依据「预期流量提升效果」由大到小排列。
3. 输出最终「本周行动清单」,格式:| 优先级 | URL | 执行动作 | 预期效果 |
本篇检查清单

参考来源:Screaming Frog — SEO Spider User Guide v24 · Screaming Frog — API Access Documentation · Screaming Frog — Release Notes v21/v22/v23/v24 · Google Search Central — Crawl Budget Management